Introduzione: perché il tempo reale impone scelte architetturali
Collegare un avatar IA distribuito su schermo o chiosco ai sistemi di business (POS, inventario, CRM, prenotazioni) non è solo una questione di accesso alle API. Si tratta di garantire che le informazioni mostrate al visitatore siano coerenti, aggiornate e fornite con una latenza compatibile con un’interazione conversazionale, controllando al contempo i costi delle chiamate e assicurando la resilienza in produzione.
Questo articolo tratta le scelte tecniche e organizzative che aiutano a raggiungere questi obiettivi: quando orchestrare i flussi, quando preferire un’architettura basata su eventi, come progettare API e webhooks resilienti, quale strategia di cache adottare e come prevedere la degradazione elegante dell’esperienza utente. Runbook, modelli di test e checklist pratiche completano il contenuto.
Orchestrazione versus coreografia: scegliere il pattern giusto
Due famiglie di architetture sono comuni per integrare i sistemi di business: orchestrazione centralizzata e coreografia (architettura event-driven). Ogni approccio ha vantaggi e limiti a seconda della necessità di coerenza e della natura dei sistemi terzi.
Orchestrazione: un componente centrale (API Gateway, BFF, orchestratore) coordina tutte le richieste verso POS, inventario e CRM. Vantaggi: visibilità centralizzata dei flussi, controllo delle politiche di retry e quota, semplicità nella gestione degli SLO. Limiti: rischio di punto unico di guasto e carico maggiore sull’orchestratore se non dimensionato correttamente.
Coreografia: i sistemi comunicano tramite eventi (webhook, event bus). Vantaggi: migliore disaccoppiamento, scalabilità, latenza potenzialmente inferiore per alcune interazioni. Limiti: complessità nella gestione della consistenza e delle transazioni distribuite.
Consiglio pratico: privilegiare l’orchestrazione per azioni sincrone critiche (verifica di disponibilità al checkout, prenotazione istantanea) e la coreografia per aggiornamenti e propagazione di stato non bloccanti (sincronizzazione stock, notifiche promozioni).
Progettazione di API e webhooks resilienti
La qualità delle API esposte dai sistemi di business e degli endpoint che sviluppate è determinante. Ecco regole di progettazione da rispettare per ridurre gli errori in produzione.
Endpoint idempotenti e verbi chiari: per azioni di business (prenotazioni, cancellazioni), progettare API idempotenti facilita i retry senza rischio di doppia esecuzione. Usare identificativi di richiesta forniti dal client permette di individuare e ignorare duplicati.
Contratti e versioning: documentare precisamente gli schemi (payload, codici di errore) e applicare un versioning chiaro evita regressioni durante le evoluzioni. I mock contrattuali sono utili per i test di integrazione continui.
Webhooks resilienti: prevedere meccanismi di retry lato mittente, backoff esponenziali e header di identificazione per la validazione. Evitare webhooks non autenticati; usare una firma HMAC o un token per convalidare l’origine delle notifiche.
Cache, invalidazione e coerenza: strategia pratica
La cache riduce la latenza e il costo delle chiamate API, ma introduce la sfida della coerenza. Piuttosto che una regola universale, ecco pattern applicabili in funzione della criticità dei dati.
Cache di sola lettura a breve durata: per informazioni non critiche ma consultate frequentemente (schede prodotto, disponibilità approssimativa), una cache a breve durata può migliorare la reattività dell’avatar. Usare TTL brevi e logiche di validazione condizionata (ETag/If-Modified-Since) quando l’API lo supporta.
Invalidazione tramite evento: per inventario e promozioni, preferire un’invalidazione proattiva via webhook o messaggi di evento inviati dal sistema sorgente. Appena cambia uno stock o una promozione, pubblicare un evento che provochi l’invalidazione mirata della cache.
Cache lato client e edge: in alcune configurazioni, mantenere una cache edge (CDN o uno strato vicino al device) permette di ridurre la latenza percepita. Attenzione alla coerenza sulle operazioni transazionali: per queste, leggere la fonte di verità anziché la cache.
Gestione delle quote, latenza e SLO/SLA
Le API di POS o delle soluzioni di prenotazione possono imporre quote o presentare latenze variabili. Per progettare un servizio robusto è necessario definire obiettivi operativi — senza pretesa di imporre cifre universali.
Definire SLO interni per l’avatar: ad esempio, tempo massimo consentito per rispondere a una richiesta esplorativa rispetto a un’azione bloccante. Questi SLO aiutano a prioritizzare le chiamate (es.: le letture sono meno prioritarie) e a scegliere il comportamento di degradazione.
Circuit breaker e quote: implementare circuit breaker per evitare di sovraccaricare un servizio terzo in difficoltà, e applicare throttling lato orchestratore per rispettare le quote. Quando un servizio è limitato, passare ai dati in cache o proporre un’alternativa UX.
Osservabilità delle latenze: strumentare le chiamate esterne con trace e metriche (latenza p95/p99, tasso di errore) per rilevare degradazioni e attivare il runbook appropriato.
Degradazione elegante ed esperienza utente (UX) in caso di indisponibilità
Quando i sistemi di business non rispondono, l’avatar deve rimanere utile. La strategia UX di degradazione è un elemento chiave del design operativo.
Informare anziché nascondere: l’avatar può indicare chiaramente al visitatore che non ha accesso all’informazione in tempo reale e proporre alternative utili (informazioni generali, orari, reindirizzamento a un servizio umano).
Modalità di sostituzione: mostrare informazioni tratte dalla cache (con indicazione di freschezza), proporre un appuntamento o una pre-richiesta (raccogliere i contatti per richiamare), oppure offrire opzioni offline se non è possibile eseguire l’azione integrata.
Considerazioni vocali: per un’interazione vocale, prevedere risposte brevi e prompt di ripresa per evitare che la conversazione si blocchi quando mancano dati esterni.
Test, validazione e runbook di incidente
La robustezza di un’integrazione si dimostra con i test e con la preparazione agli incidenti. Di seguito un insieme di metodi di validazione e un runbook operativo sintetico.
Test automatizzati: includere test unitari sugli adattatori API, test di integrazione contro mock contrattuali e test end-to-end in ambienti che riproducano latenza ed errori dei servizi di business.
Test di resilienza: simulare guasti (timeout, 5xx, interruzioni di rete), quote raggiunte e risposte corrotte. I test devono coprire scenari di retry, idempotenza e rollback.
Runbook minimo da preparare (esempi di passi da seguire):
Rilevare l’incidente tramite alert (errore 5xx, aumento delle latenze p99).
Identificare l’ambito interessato (POS, inventario, CRM) e attivare una modalità degradata configurata per l’avatar.
Commutare gli endpoint critici su mock o su uno strato di cache aggiornato se possibile.
Notificare i team di business e attivare il piano di comunicazione verso i siti impattati.
Registrare le azioni e preparare un post-mortem per correggere i punti deboli (contratti, timeouts, capacità).
RAG, multi-LLM e dati in tempo reale: come conciliarli
L’uso di una knowledge base per arricchire le risposte (RAG) e la possibilità di orchestrare più motori LLM influenzano il modo di integrare i dati in tempo reale.
Separare gli usi: assegnare al motore RAG le informazioni statiche o periodiche (FAQ, regole commerciali) e interrogare direttamente le API di business per i dati critici e volatili (stock, disponibilità al momento, prenotazione).
Contestualizzazione in tempo reale: quando l’avatar deve comporre una risposta che mischia conoscenze RAG e dati real-time, definire l’ordine delle chiamate per limitare la latenza — ad esempio chiamare prima la fonte critica e poi arricchire con RAG se il budget di latenza lo consente.
Multi-LLM e routing: a seconda della configurazione, può essere utile instradare alcuni tipi di richieste verso un LLM specializzato (dialogo, sintesi) e altri verso un modello ottimizzato per la verifica fattuale. Queste scelte vanno testate per misurarne l’impatto su latenza e costo.
Checklist pratica ed esempi operativi (retail e hospitality)
Ecco una checklist da usare in fase di progettazione e preparazione del pilota, seguita da due esempi concreti. La checklist mira alle decisioni e alle validazioni chiave prima di mettere l’avatar in produzione.
Checklist di integrazione:
Identificare i casi d’uso sincroni (es.: verifica stock per acquisto) e asincroni (es.: propagazione aggiornamento prezzo).
Scegliere il pattern architetturale principale: orchestrazione per sincroni / coreografia per propagazione di eventi.
Documentare i contratti API e mettere in produzione mock contrattuali.
Definire la strategia di cache e i meccanismi di invalidazione (webhook o messaggi).
Prevedere circuit breaker, throttling e regole di retry (con idempotenza).
Preparare il runbook di incidente e i messaggi UX di degradazione; validare con test utente se possibile (touch e voice).
Esempi (illustrativi)
Retail — disponibilità prodotto e promozione: l’avatar interroga l’inventario in lettura per indicare la disponibilità locale. Pattern consigliato: orchestratore che legge la fonte di inventario per le decisioni di checkout, e invalidazione della cache tramite webhook emesso dal WMS in caso di cambiamenti di stock o operazioni di sconto.
Hospitality — prenotazione e check-in: per una richiesta di prenotazione, utilizzare un’interazione sincrona orchestrata verso il sistema di prenotazione per ottenere una conferma istantanea. In parallelo, alimentare la knowledge base RAG con informazioni non critiche (orari, servizi) per arricchire lo scambio.
Conclusione e passi successivi
Un’integrazione in tempo reale affidabile tra un avatar IA e i sistemi di business richiede scelte ponderate sull’architettura (orchestrazione vs coreografia), API e webhooks progettati per la resilienza, una strategia di cache adeguata e runbook pronti all’uso. Il compromesso tra latenza, costo e coerenza si decide caso per caso in base alle priorità di business.
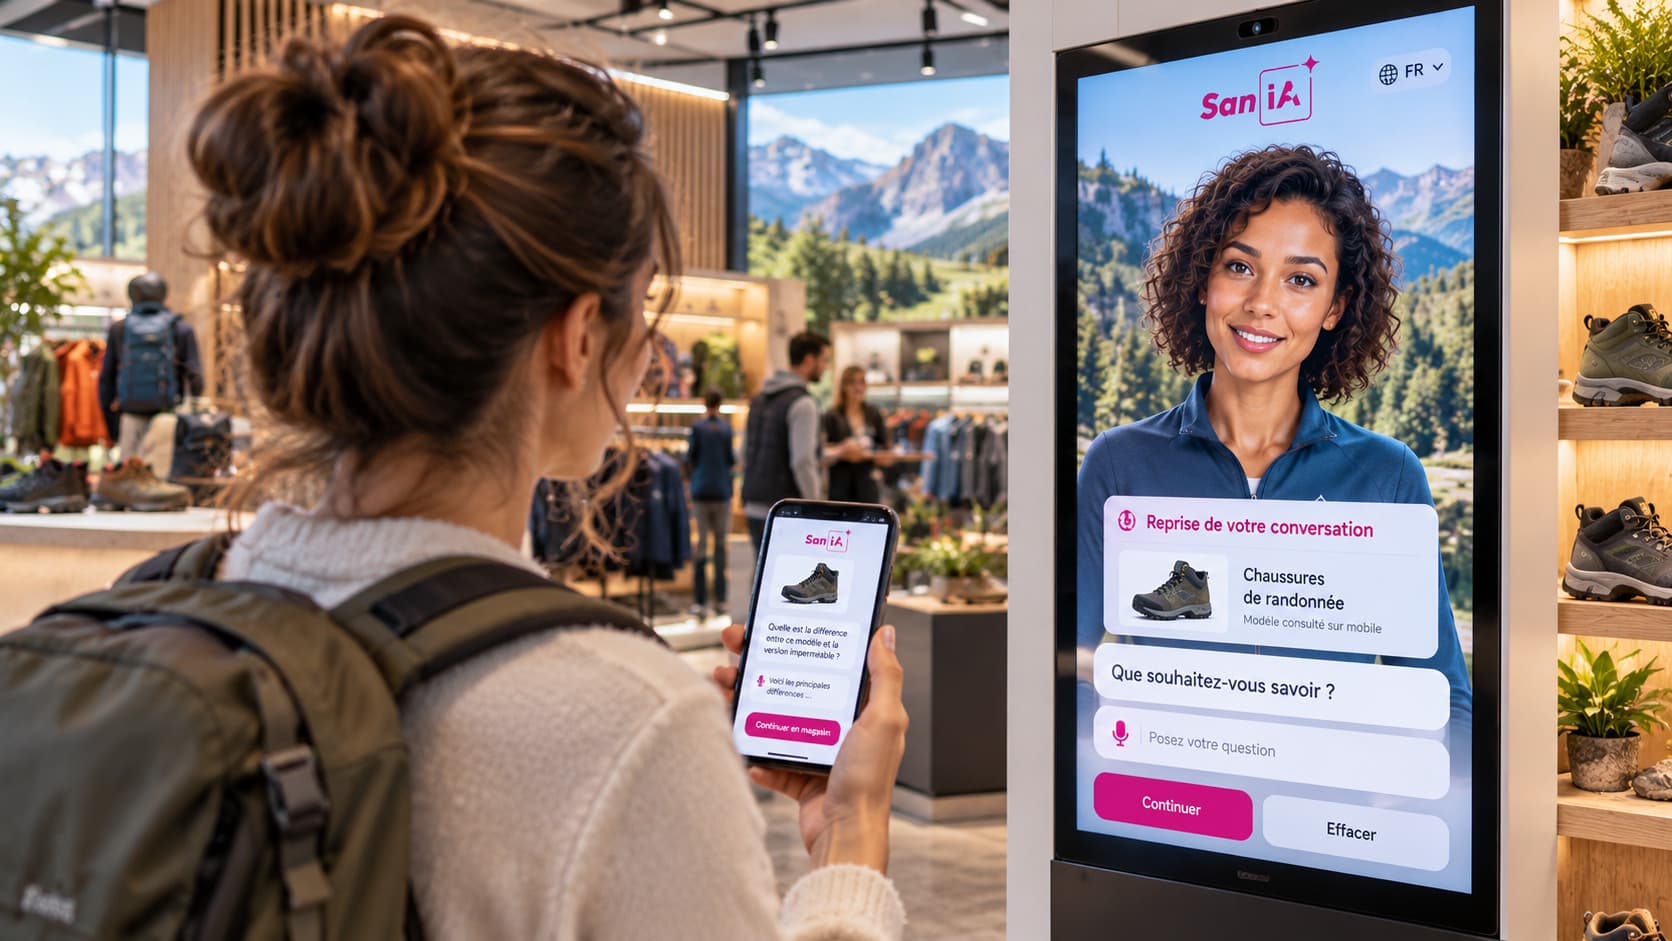
SANIA può essere configurata per interagire con webhooks, chiamare endpoint esterni e sfruttare una knowledge base per il RAG, oltre a poter essere distribuita su schermi o chioschi touch/voice e integrata con l’ecosistema Sandisplay a seconda del progetto. Per valutare come questi pattern possano applicarsi al vostro contesto (retail, hospitality, multi-sito), è possibile richiedere una demo mirata di SANIA.