Introduzione rapida
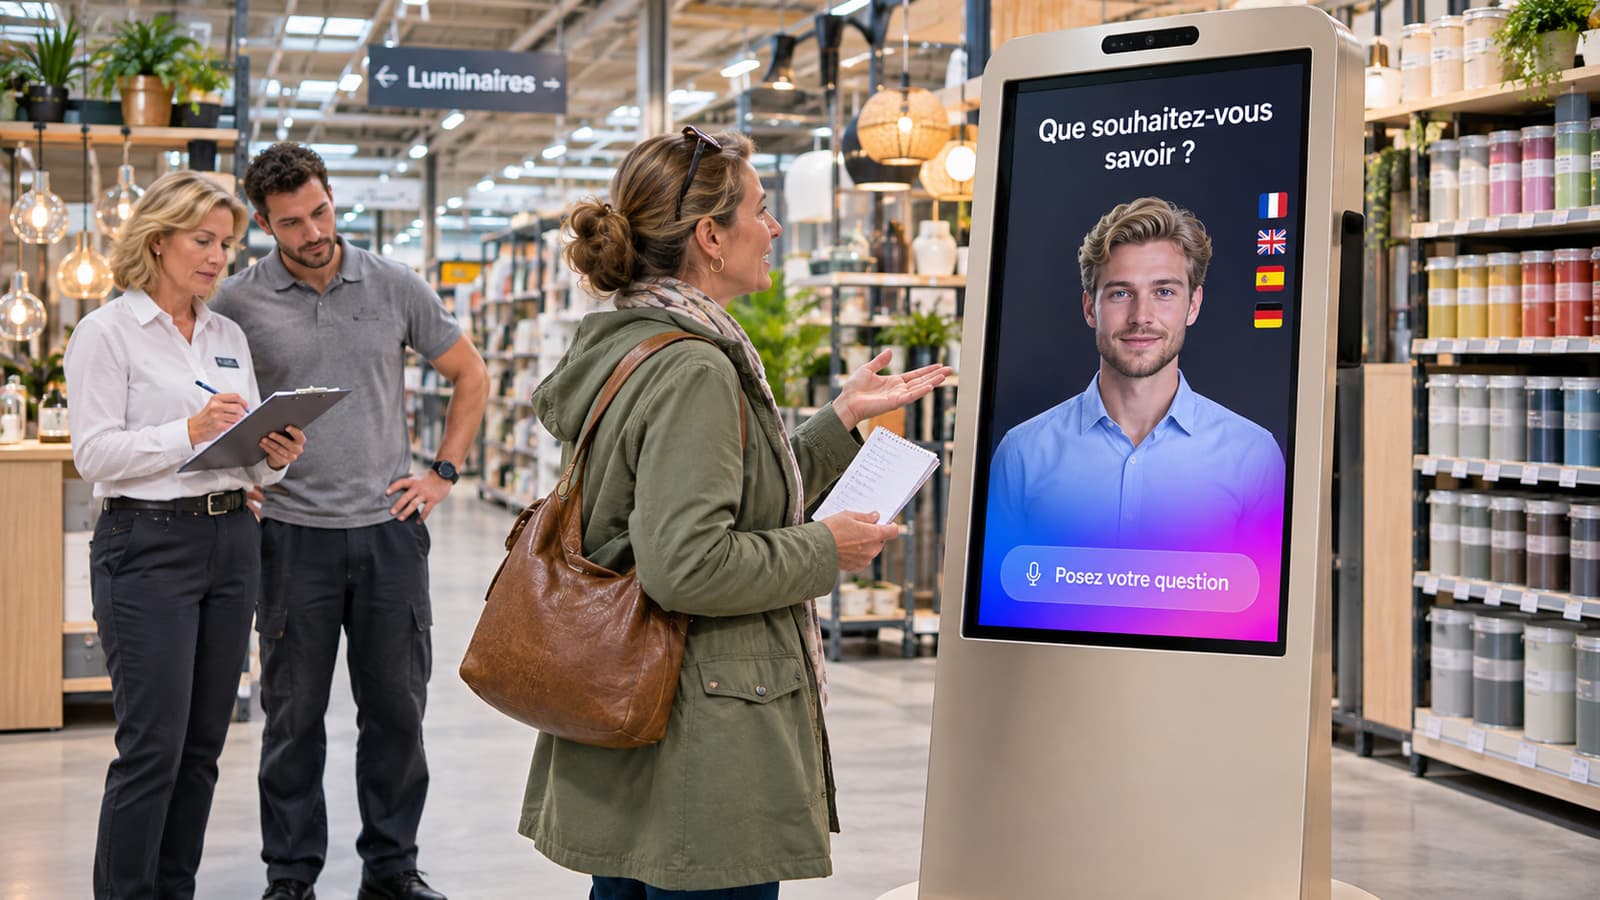
I team che dispiegano un avatar IA di accoglienza alimentato da una base RAG si espongono a un rischio concreto: possono comparire errori fattuali o allucinazioni nelle risposte visibili ai visitatori. Questi errori mettono in discussione la fiducia, la qualità del servizio e la sicurezza informativa. Questo articolo propone un quadro operativo per misurare la factualità, rilevare le allucinazioni in test e in produzione e mettere in atto rimedi che rispettino la disponibilità 24/7 di un servizio di accoglienza.
Perché misurare la factualità per un avatar di accoglienza
Un avatar IA di accoglienza svolge il ruolo di primo punto informativo in un ambiente fisico. A differenza di uno strumento interno, le sue risposte sono pubbliche e direttamente legate all'immagine dell'organizzazione. Misurare la frequenza e la gravità degli errori fattuali consente di prioritizzare le azioni correttive, definire SLA accettabili e scegliere pattern di mitigazione adeguati al livello di rischio (informazione commerciale, consulenza normativa, indicazioni di sicurezza, ecc.).
Misurare non significa soltanto contare gli errori. È necessario caratterizzare le situazioni a rischio, distinguere errori minori da errori critici e fornire ai team tecnici e di business indicatori sfruttabili per guidare i miglioramenti.
Definire metriche di factualità utilizzabili
Prima di qualsiasi strumentazione, concordate con i team di business una palette di indicatori semplici e azionabili. Di seguito tipi di metriche da valutare, presentati come opzioni da adattare al contesto:
1. Tasso di incidenti rilevati su un campione annotato. Si tratta di una misura di campionamento manuale per stimare la frequenza delle allucinazioni nelle interazioni rappresentative.
2. Tasso di risposte con provenienza (citazione della fonte) quando la configurazione RAG lo consente. La presenza di un estratto documentato riduce il rischio percepito ma non elimina l'errore.
3. Punteggio di divergenza tra la risposta generata e i documenti recuperati. A seconda dell'architettura, la ricerca semantica può restituire un punteggio di similarità utilizzabile come segnale di allerta. Questo segnale va interpretato insieme ad altri segnali e log e richiede una configurazione adeguata.
Costruire set di test e protocolli offline
I test fuori produzione permettono di identificare tendenze prima che impattino gli utenti. Create più set di test:
1) Set di regressione business: domande tipiche estratte dalle FAQ, documenti PDF/DOCX/XLSX/TXT/CSV e casi d'uso critici validati dai knowledge manager. Annotazione: ogni risposta attesa è documentata e validata da un referente di business.
2) Set adversarial: domande formulate per provocare allucinazioni (ambiguità, domande composite, manipolazione di entità). Questi casi testano la robustezza della generazione e della contestualizzazione RAG.
3) Set di non‑risposta: frasi fuori perimetro che dovrebbero portare a una risposta del tipo "non lo so" o a un instradamento verso un umano. Verificate che il sistema non "completi" risposte in modo errato.
Rilevamento automatico in produzione: segnali e pratiche
In produzione, il rilevamento automatico si basa su una combinazione di segnali provenienti dalla catena RAG, dall'LLM e dall'interfaccia. I segnali utili includono in particolare:
• metadati della ricerca semantica (punteggio di similarità, elenco dei documenti sorgente restituiti);
• indicatori legati alla generazione (se il motore espone punteggi o euristiche configurabili);
• eventi di interfaccia: richieste di chiarimento ripetute, riavvii immediati della conversazione, segnali espliciti dell'utente (pulsante di feedback, pollice verso il basso);
Raccogliere e correlare questi segnali in una piattaforma di osservabilità permette di avviare workflow di indagine.
Usare regole semplici all'inizio (ad es. correlazione di un basso punteggio di similarità e feedback negativo) e poi perfezionare con modelli di anomalie.
Pattern operativi di mitigazione
Quando la rilevazione individua una risposta a rischio, possono essere applicati diversi pattern di mitigazione a seconda della gravità e della configurazione:
1. Fallback conservativo: preferire una risposta che limiti il perimetro (ad esempio indicare che la domanda richiede verifica) piuttosto che una risposta potenzialmente errata. Questo è una scelta editoriale e UX.
2. Source‑first: configurare l'avatar per citare la fonte o indicare la provenienza dell'informazione quando la risposta si basa sulla base RAG. La citazione riduce la sorpresa e facilita il controllo da parte dell'utente e dei team di business.
3. Call‑to‑verify tramite strumenti e webhooks: quando è possibile l'integrazione, attivare una chiamata di funzione o un webhook verso un servizio di verifica esterno o verso un'API di business. Questa capacità richiede un'integrazione specifica e deve essere esplicitata nell'architettura del progetto.
Orchestrazione multi‑LLM e verifiche a cascata
Una strategia efficace per ridurre gli errori fattuali è l'uso orchestrato di più modelli. Esempi di pattern applicabili a seconda della configurazione:
• Routing per rischio: instradare le richieste semplici verso un modello efficiente e poco costoso, e le richieste segnalate ad alto rischio verso un modello più robusto o specializzato.
• Cascata di verifica: generazione iniziale da un LLM, quindi rivalutazione o riformulazione da un secondo motore che verifica la coerenza con i passaggi RAG. Questa implementazione è avanzata e richiede un orchestratore e criteri decisionali condivisi.
Questi pattern possono essere combinati con chiamate di funzione per effettuare verifiche fattuali esterne. Qualsiasi orchestrazione multi‑LLM va testata offline e strumentata per monitorare latenza e costi.
Workflow human‑in‑the‑loop e cicli di correzione
La correzione duratura delle allucinazioni implica un processo umano strutturato. Un workflow operativo raccomandato comprende:
• Triaging automatizzato: le interazioni segnalate vengono inserite in una coda di revisione per valutazione umana. Questa coda deve includere il contesto conversazionale e i documenti sorgente utilizzati dalla RAG.
• Annotazione e rimedio: i knowledge manager convalidano la risposta corretta e, se necessario, correggono o arricchiscono i documenti della knowledge base. Le modifiche devono seguire la governance esistente per la KB (validazione, versioning, test).
• Test di regressione: integrare i casi corretti nel set di regressione per evitare regressioni durante aggiornamenti del motore o della base documentale. La frequenza delle revisioni e i ruoli coinvolti devono essere definiti in base alla criticità.
SLA, alerting e organizzazione della supervisione
Per rendere questi meccanismi sfruttabili dall'IT e dai team knowledge, formalizzate alcuni elementi operativi:
• definire soglie qualitative di allerta e procedure di escalation concordate tra IT, knowledge manager e team prodotto;
• integrare i segnali di factualità nella piattaforma di monitoring SRE per ottenere alert distinti di business e tecnici;
• prevedere un runbook che spieghi i passaggi di verifica, correzione e rollback in caso di deriva. Il runbook deve precisare chi esegue le correzioni nella base documentale e come validare l'efficacia delle misure adottate.
Errori frequenti e punti di attenzione
Alcuni errori osservati nei progetti RAG/LLM e consigli per evitarli:
• Aspettarsi una "fiducia" universale dall'LLM. Non considerare un punteggio generato dal modello come una prova assoluta. È preferibile incrociare più segnali e far validare i casi critici da una persona.
• Non versionare i set di test. Senza uno storico, è impossibile misurare regressioni dopo un aggiornamento del modello o dei documenti.
• Confondere disponibilità 24/7 con tolleranza agli errori. Mantenere la disponibilità non deve oscurare la necessità di un fallback conservativo quando l'incertezza è elevata.
Checklist operativa rapida
Prima di lanciare un pilota o passare in produzione, verificate di avere:
Set di test business e adversarial annotati e versionati.
Strumentazione dei segnali RAG e LLM esportata alla piattaforma di osservabilità.
Workflow di triage human‑in‑the‑loop definito e ruoli assegnati.
Politica di fallback e regole UX per risposte a rischio.
Piano di allerta e runbook SRE con contatti di business.
Conclusione e passaggi pratici successivi
Misurare e ridurre le allucinazioni di un avatar IA di accoglienza alimentato da RAG richiede un approccio che combini metriche chiare, test rigorosi, rilevamento in produzione e workflow di correzione guidati dall'uomo. Diversi pattern tecnici contribuiscono alla mitigazione: fallback conservativi, citazioni di fonte, chiamate di funzione per verifiche esterne e orchestrazione multi‑LLM in base alla criticità. Questi elementi devono integrarsi nella governance della knowledge base e nelle pratiche SRE dell'organizzazione.
SANIA può essere configurata per sfruttare una knowledge base dedicata, utilizzare la ricerca semantica RAG, orchestrare più motori LLM e attivare chiamate di funzione o webhooks secondo l'architettura scelta. Per valutare concretamente come questi pattern possano applicarsi al vostro contesto di accoglienza, potete richiedere una dimostrazione di SANIA e discutere un protocollo pilota adattato alle vostre esigenze.