
Introduzione: perché un’osservabilità pensata SRE per un avatar IA fisico
Un avatar IA distribuito su schermo o kiosk opera in un ambiente distribuito che combina componenti locali (UI tattile, I/O audio, periferiche) e servizi cloud o on‑premise (ASR, LLM, TTS, RAG, integrazioni di business). Garantire disponibilità 24/7 e rilevamento rapido delle degradazioni richiede un approccio di osservabilità progettato per l’operatività, non solo per lo sviluppo.
Questa guida propone un playbook operativo per definire SLO e SLA adeguati, costruire test sintetici end‑to‑end che includano percorsi tattili e vocali, progettare log tracciabili e privacy‑safe, predisporre dashboard e alert azionabili, e organizzare runbook e on‑call. Le raccomandazioni sono applicabili a un deployment SANIA su schermo o kiosk tenendo conto delle specificità hardware e delle integrazioni del progetto.
Definire SLO e SLA pertinenti prima di qualsiasi supervisione
Gli SLO (service level objectives) traducono in criteri operativi cosa significa un servizio accettabile per utenti e organizzazione. Gli SLA sono impegni contrattuali o interni che si basano su quegli SLO. Per un avatar IA in spazio pubblico è importante allineare SLO/SLA con le aspettative di business e le reali capacità tecniche.
Piuttosto che imporre metriche tecniche isolate, struttura gli obiettivi attorno all’esperienza: disponibilità on‑site dei servizi vocali e tattili, latenza percepita dall’utente, capacità di fornire una risposta pertinente dalla base documentale e tolleranza alle degradazioni delle integrazioni in tempo reale.
Mappare i percorsi critici (es. orientamento visitatore, informazione prodotto, scenario di pagamento se presente) e definire quali componenti devono essere misurati per ciascun percorso.
Trasporre le aspettative di business in misure osservabili: disponibilità, latenza percepita, tasso di fallback a messaggio di errore o assistenza umana, freschezza dei contenuti RAG.
Documentare le dipendenze esterne (ASR, LLM, TTS, API di business) e precisare quali livelli di servizio sono contrattuali e quali fanno parte del monitoring operativo.
Progettare test sintetici end‑to‑end che coprano tattile e vocale
Il synthetic monitoring consente di rilevare regressioni prima che impattino gli utenti. Per un kiosk interattivo, il piano di test sintetici deve coprire i percorsi tattili, le interazioni vocali complete (ASR -> LLM -> TTS) e gli scenari che interrogano la base documentale RAG o API esterne.
I test sintetici possono essere eseguiti dal cloud, da un agente on‑premise o da dispositivi posizionati in loco. Devono riprodurre fedelmente la catena completa di interazione e verificare non solo il successo tecnico ma anche la qualità funzionale minima (per esempio risposta non vuota, assenza di errori tecnici, latenza accettabile).
Test tattili: flow di benvenuto, navigazione dei menu, transizioni di schermo, validazione dei pulsanti e rendering visivo.
Test vocali end‑to‑end: iniezione di un file audio o voce sintetica simulata, verifica della trascrizione ASR, valutazione della risposta generata dal LLM/RAG, riproduzione TTS e controllo dell’uscita audio.
Test di integrazione in tempo reale: chiamate simulate ad API di business, verifica dei codici di errore e comportamento in caso di indisponibilità (degradazione controllata).
Test di freschezza RAG: query mirate su documenti recentemente aggiornati per verificare che la base documentale restituita sia coerente.
Progettare log privacy‑safe e tracciabili
La qualità dei log è essenziale per diagnosticare un incidente. Allo stesso tempo occorre garantire la riservatezza delle conversazioni e rispettare gli obblighi legali. Progetta log che restino sfruttabili per i team SRE minimizzando i dati personali conservati.
Adotta principi chiari: separare i metadata operativi dai contenuti utente, usare identificatori di correlazione non reversibili e applicare politiche di anonimizzazione o pseudonimizzazione adeguate alla natura dei dati e alla configurazione del progetto.
Includere sistematicamente un correlation id globale per una sessione (correlabile tra UI locale, ASR, LLM, TTS e chiamate API).
Loggare metadata utili alla diagnosi: timestamp, latenze per fase, codici di errore, versione del modello LLM, identificativi di deployment e macchina.
Evitare di conservare la trascrizione completa o l’audio grezzo senza giustificazione operativa. Quando la conservazione è necessaria per l’analisi, applicare robuste misure di anonimizzazione e minimizzare il periodo di retention in conformità con le decisioni GDPR del progetto.
Conservare tracce delle azioni di sistema e delle fasi di elaborazione RAG (quale fonte documentale è stata interrogata) senza esporre il contenuto sensibile.
Correlazione multi‑componente per diagnosticare ASR, LLM, TTS e integrazioni
Un incidente apparentemente globale può derivare da un singolo componente: un ASR degradato, un motore LLM degradato, latenza di rete su una API di business o un problema locale sul kiosk. La correlazione delle tracce tra componenti è quindi indispensabile per isolare rapidamente la causa radice.
Progetta pipeline di log e trace che permettano di ricostruire una sessione completa. Usa correlation id propagati attraverso ogni chiamata e conserva metadata che indichino il percorso eseguito e le latenze per fase.
Tracciare l’input utente, la richiesta inviata al servizio ASR, la trasmissione verso LLM/RAG, la richiesta TTS e la riproduzione finale, con latenza e stato per ciascuna fase.
Includere gli ID di versione dei modelli o delle configurazioni (ASR model vX, LLM routing, indice RAG) per facilitare rollback o analisi di regressioni post‑deploy.
Conservare gli identificativi delle richieste ad API esterne e i codici di risposta per valutare incidenti di integrazione senza necessariamente archiviare il payload.
Dashboard e alerting azionabili per i team Ops
I dashboard devono sintetizzare lo stato del servizio per consentire decisioni rapide. Devono essere orientati all’azione e collegati ad alert chiari, evitando rumore e favorendo la prioritizzazione degli incidenti.
Progetta alert differenziati: quelli che richiedono intervento immediato e quelli che richiedono un’indagine pianificata. Documenta il livello di impatto previsto per ciascun tipo di alert per guidare l’on‑call.
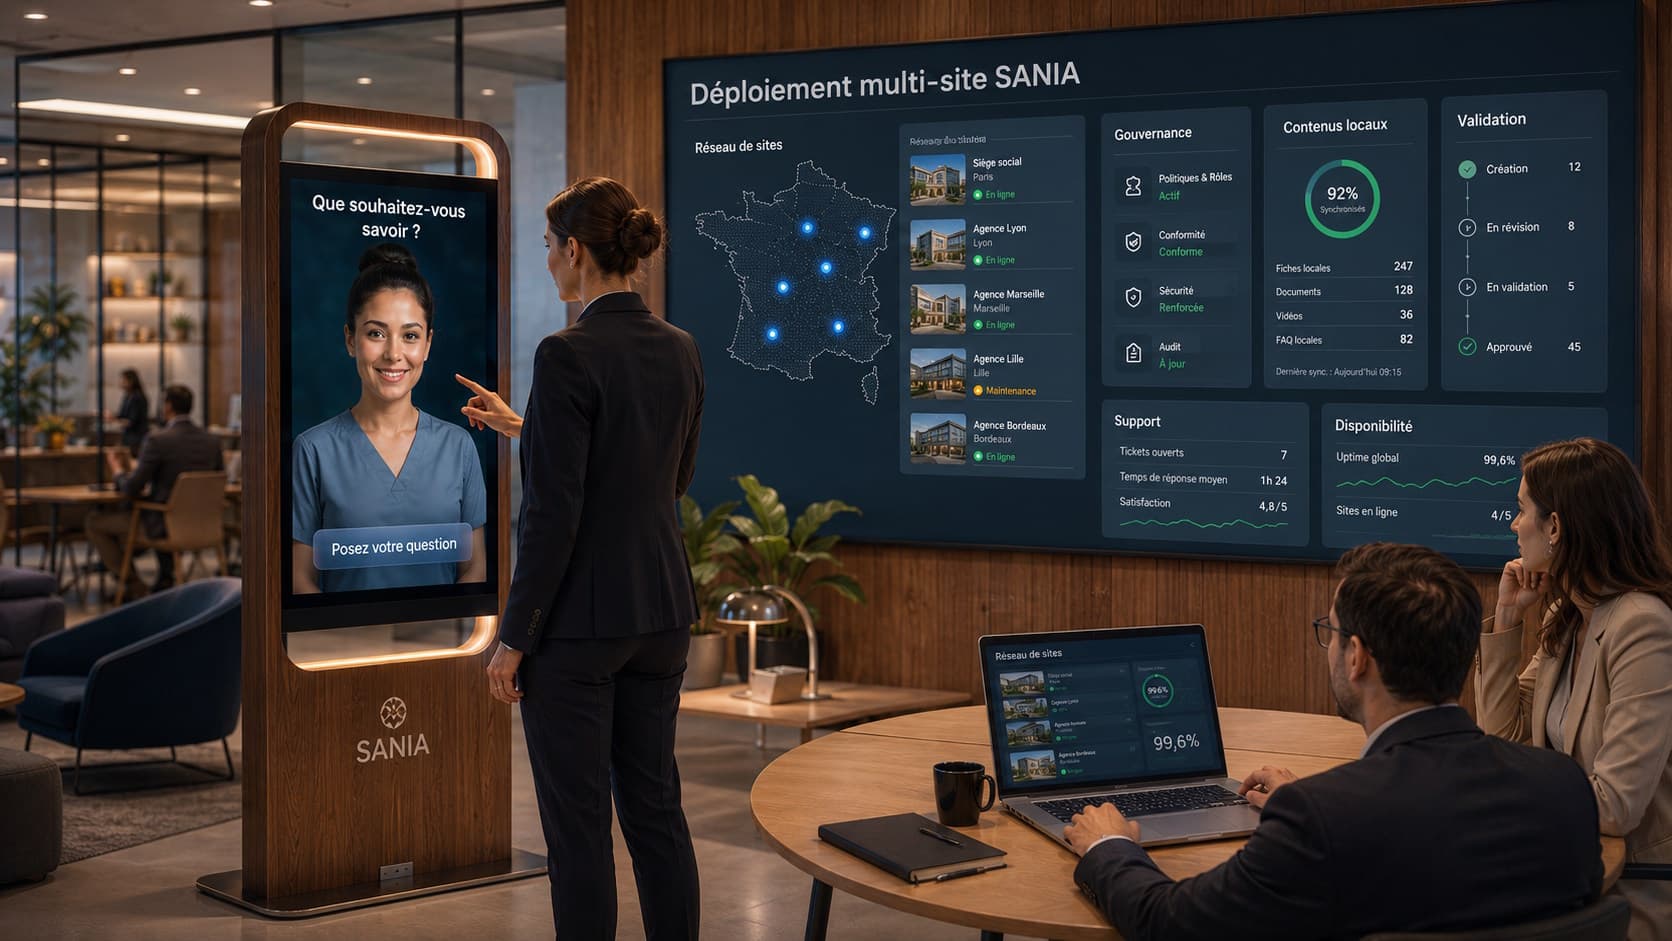
Esempi di viste Dashboard: mappa dei siti e stato dei kiosk, latenza media per componente, tracce di errore ASR/LLM/TTS aggregate, tasso di fallback funzionale.
Alert raccomandati: indisponibilità di un servizio critico (ASR/LLM/TTS), aumento sostenuto degli errori di integrazione, degrado percepibile della latenza media, anomalie nella freschezza RAG che indichino drift dei contenuti.
Privilegiare alert con contesto arricchito: log correlati, fasi impattate, ultimo test sintetico fallito e suggerimenti operativi presi dal runbook.
Runbook, on‑call e procedure di escalation adatte agli avatar IA
Un buon runbook deve essere pragmatico e focalizzato sui sintomi osservabili. Per ogni tipo di alert o incidente, documenta i passi di diagnosi rapida, le verifiche da fare in loco e le possibili azioni di mitigazione.
L’organizzazione on‑call deve prevedere ruoli chiari: chi opera l’infrastruttura locale, chi interroga i servizi cloud, chi gestisce le integrazioni di business. Evita di contare su trasferimenti automatici non definiti nel progetto; documenta i punti di contatto e i canali di comunicazione.
Struttura di un runbook d’incidente: descrizione del sintomo, prime verifiche, comandi o console da consultare, metodo di correlazione dei log, azioni di mitigazione temporanee, criteri di fallback ed escalation.
Includere procedure per test rapidi in loco (riavvio controllato, failover di rete, verifica hardware audio/tattile) e script di estrazione log correlati.
Prevedere esercitazioni regolari per validare i runbook e mantenere la reattività dei team.
Strategie di deployment e pattern canary per limitare i rischi
I deployment di componenti critici (nuovo modello LLM, aggiornamento ASR, modifica del pipeline RAG) devono minimizzare il rischio di impattare l’intero parco. Il canary deployment è un pattern utile: distribuire su ambito limitato, monitorare gli indicatori chiave e poi estendere progressivamente in assenza di segnali di degradazione.
Documenta i criteri di validazione di un canary e le condizioni di rollback. Ciò include i risultati dei test sintetici, i tassi di errore osservati e l’assenza di alert comportamentali.
Pianificare fasi di validazione: pre‑deployment in ambiente di test, canary su un piccolo perimetro, rollout progressivo con monitoraggio rafforzato.
Definire criteri di stop: segnali di allerta chiari che inneschino rollback o sospensione del rollout.
Preparare meccanismi di rollback semplici e testati per tornare a una versione stabile se necessario.
Checklist operativa prima e dopo la messa in produzione
Ecco una lista di controllo pensata per preparare la messa in produzione e stabilizzare l’operatività continua. Raggruppa aspetti di monitoring, privacy, test e procedure umane.
Questa checklist va adattata al contesto del progetto, all’architettura scelta e agli obblighi normativi locali. Serve da base per validare che l’avatar sia pronto per funzionare 24/7.
Validare SLO/SLA definiti e tradurli in metriche osservabili.
Configurare test sintetici che coprano percorsi tattili e vocali e verificarne l’esecuzione automatizzata.
Configurare la propagazione dei correlation id e la separazione metadata/contenuti nei log.
Definire la policy di anonimizzazione e retention dei log in conformità con le decisioni GDPR del progetto.
Creare dashboard operative e configurare alert azionabili con runbook associato.
Organizzare l’on‑call ed eseguire un’esercitazione d’incidente per validare procedure di diagnosi e rollback.
Domande frequenti (FAQ): aspetti pratici
D: È sempre necessario registrare l’audio o la trascrizione per diagnosticare un incidente? R: Non necessariamente. I metadata, i codici di stato e le trascrizioni anonimizzate possono essere sufficienti per la maggior parte delle diagnosi. La registrazione completa deve essere conservata solo se un’analisi specifica lo richiede e previa validazione degli aspetti legali e di privacy.
D: SANIA fornisce metriche di osservabilità in modo nativo? R: In base alla configurazione del progetto, SANIA può essere integrata con strumenti di monitoring ed elaborare documenti di business (PDF, DOCX, XLSX, TXT, CSV, o NDJSON per workflow specifici). Le metriche utili devono essere esposte o raccolte tramite i componenti deployati e le integrazioni scelte.
D: Come verificare la freschezza dei contenuti RAG? R: Implementare query sintetiche mirate su documenti recentemente aggiornati e monitorare le risposte insieme ai log RAG che indicano quali fonti sono state interrogate, per segnalare drift o assenza di documenti aggiornati.
Per approfondire
L’implementazione di un sistema di osservabilità completo per un avatar IA richiede una stretta collaborazione tra prodotto, infrastruttura, security e operazioni. Adatta questo playbook al perimetro tecnico e agli obblighi del progetto, e privilegia iterazioni brevi per stabilizzare progressivamente gli SLO.
SANIA può essere sfruttata su schermo o kiosk interattivo con interazione tattile e/o vocale in base alla configurazione, e integrare una base documentale di business per scenari RAG. Per studiare l’adattamento di questo playbook al tuo deployment e ricevere una dimostrazione operativa, puoi richiedere una presentazione di SANIA e dei nostri workflow operativi.