Introduzione: perché un protocollo UAT dedicato agli avatar IA in negozio
Un pilota di avatar IA su kiosk o schermo deve dimostrare in condizioni reali che l'esperienza soddisfa gli obiettivi di business: accoglienza, informazione, orientamento e guida. Un protocollo strutturato di test utente e accettazione (UAT) evita le illusioni prodotte da test tecnici isolati e garantisce che l'avatar funzioni con vere interazioni vocali e touch, in più lingue e con la base documentale di business.
Questo documento propone un protocollo pronto all'uso: definizione degli obiettivi, scenari di test tipo, metodo di reclutamento multilingue, script osservabili, indicatori qualitativi e quantitativi da monitorare, checklist tecniche e criteri operativi go/no‑go. Gli elementi specifici SANIA sono indicati chiaramente quando devono essere verificati durante il pilota.
Definire gli obiettivi di business e l'ambito del pilota
Prima di ogni test, formalizzate gli obiettivi concreti del pilota. Devono essere legati a usi specifici: reperimento di informazioni sul prodotto, orientamento in negozio, risposta a domande frequenti, accesso multilingue o guida verso un servizio. Ogni obiettivo si traduce in casi d'uso prioritari che saranno la base per gli scenari di test.
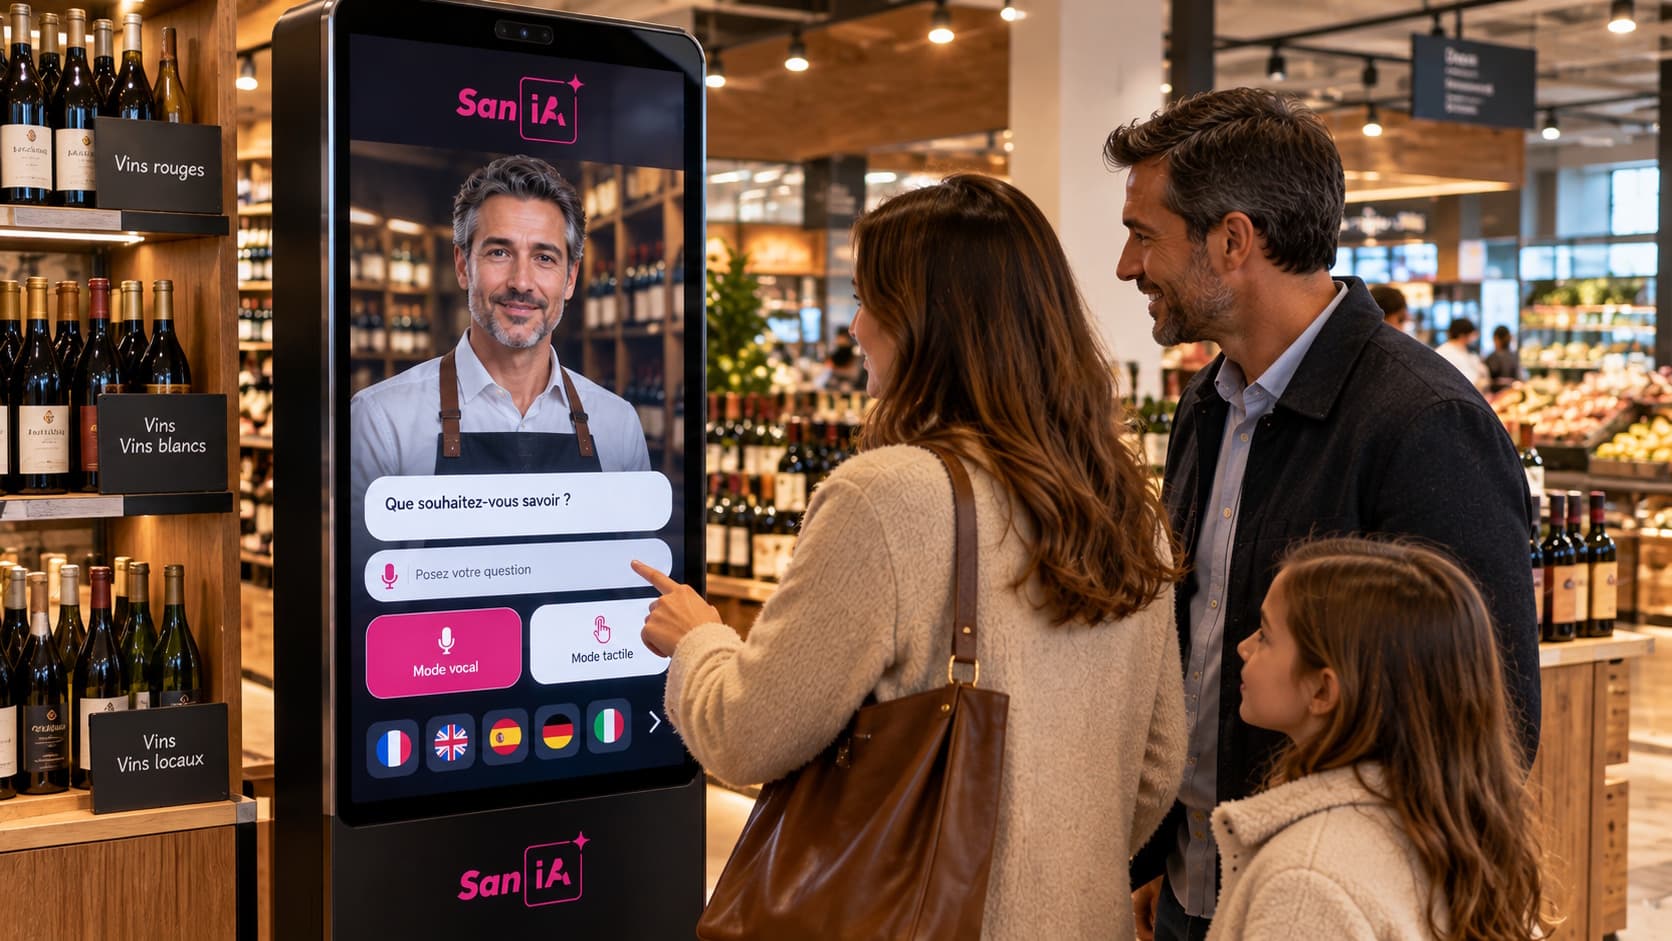
Specificate l'ambito tecnico e operativo: modalità di interazione attivate (voce, touch o entrambe), lingue da coprire, integrazioni eventualmente disponibili (inventario, orari, segnaletica dinamica) e vincoli ambientali (rumore, illuminazione, afflusso). Distinzione importante: cosa è una capacità nativa dell'avatar e cosa richiederà un'integrazione specifica.
Scenari utente tipo: voce, touch e multilingue
Costruite un set di scenari che coprano i percorsi più frequenti e le situazioni di fallimento. Ogni scenario deve includere l'obiettivo dell'utente, il contesto, i prerequisiti (lingua, disponibilità di un'integrazione), lo script dell'utente e i criteri di esito. Variate gli scenari secondo: interazioni esclusivamente vocali, interazione solo touch, percorsi misti touch poi voce e cambio di lingua durante la sessione.
Esempi di casi business da includere: richiesta di informazioni sul prodotto, ricerca di un reparto o di un prodotto a stock, richiesta di orari e servizi, domanda normativa o di sicurezza semplice, e richiesta che richieda instradamento a personale umano. Per i test multilingue includete parlanti nativi e non nativi per valutare la robustezza dell'ASR e la formulazione delle risposte.
Script di test osservabili e griglia di osservazione
Ogni sessione di test deve essere condotta con uno script preciso e una griglia di osservazione compilata in tempo reale dal tester. La griglia documenta i seguenti elementi oggettivi: avvio (tempo per iniziare l'interazione), comprensione ASR (l'avatar ha trascritto correttamente la richiesta?), pertinenza della risposta, chiarezza vocale e volume TTS, ergonomia touch (menu, etichette), latenza percepita, necessità di escalation e soddisfazione dichiarata dell'utente.
Integrate queste osservazioni con note qualitative su intonazione, confusioni ricorrenti e espressioni utente non previste. L'obiettivo è produrre tracce utilizzabili per correggere la base documentale, aggiustare prompts e microcopy o migliorare i parametri ASR/TTS.
Campi della griglia di osservazione: ID test, scenario, lingua, modalità (voce/touch), trascrizione ASR osservata, risposta fornita, durata interazione, intervento umano necessario, stato successo/insuccesso, commenti.
Reclutamento dei partecipanti e dimensione del campione
Il reclutamento deve mirare alla rappresentatività dei visitatori reali: profili demografici, livelli di familiarità con lo strumento, lingue parlate e comportamenti d'uso (preferenza touch o vocale). Prioritizzate la diversità rispetto al volume assoluto per individuare casi problematici e bias linguistici o culturali.
Piuttosto che imporre un numero fisso, organizzate i test per iterazioni fino al punto di saturazione qualitativa: quando emergono gli stessi problemi ricorrenti e poche osservazioni nuove, la fase iniziale di test può considerarsi esaustiva. Questo principio evita una soglia arbitraria e si adatta all'affluenza e alla complessità dell'ambito testato.
Esecuzione dei test in negozio: logistica e buone pratiche
Programmate sessioni durante fasce rappresentative di afflusso. Preparate l'ambiente: segnaletica chiara che indica si tratta di un test, istruzioni sulla riservatezza e autorizzazioni se vengono effettuate registrazioni. Ricordate che la raccolta di dati personali deve essere trattata secondo la normativa applicabile e che la configurazione di SANIA dipenderà dalle opzioni di conservazione scelte dall'organizzazione.
Durante la sessione limitate le intervenzioni del tester per non distorcere i comportamenti. Registrate campioni anonimizzati delle interazioni se la configurazione del pilota lo consente e viene ottenuto il consenso. Utilizzate la griglia di osservazione per raccogliere misure oggettive e feedback qualitativi immediati.
KPI e criteri go/no‑go: cosa misurare e come decidere
Selezionate un set limitato di indicatori quantitativi e qualitativi allineati con gli obiettivi di business. Dimensioni utili: tasso di risoluzione percepito dai tester, tasso di escalation verso intervento umano identificato tramite osservazione, qualità della comprensione ASR nelle lingue testate, latenza media percepita e soddisfazione utente dichiarata a caldo. Precisate i metodi di raccolta: griglia di osservazione, sondaggio post‑interazione separato o strumentazione esterna a seconda delle integrazioni disponibili.
Per i criteri go/no‑go, preferite criteri operativi leggibili: se le principali richieste di business non vengono risolte in modo affidabile nelle lingue prioritarie, se l'ASR fallisce sistematicamente in contesto reale, o se l'interfaccia touch impedisce l'accesso a funzioni essenziali, il pilota non può essere convalidato per la fase successiva. Evitate di fissare soglie numeriche universali senza contestualizzarle: sono criteri da adattare all'ambizione del progetto e alla criticità di business.
Checklist tecnica da validare durante il pilota
Durante l'UAT, validate gli elementi tecnici che impattano l'esperienza. Controllate in particolare la robustezza dell'ASR nelle lingue abilitate, la qualità e intelligibilità del TTS, la pertinenza delle risposte provenienti dalla base documentale RAG, i comportamenti di fallback quando la fonte documentale non è sufficiente e la latenza percepita per le chiamate LLM o le integrazioni in tempo reale.
Per SANIA verificate i seguenti punti nella configurazione del pilota: capacità di passare tra voce e testo secondo la configurazione, mantenimento del contesto conversazionale durante una sessione, disponibilità multilingue configurata e adeguatezza della knowledge base fornita dall'organizzazione. Le integrazioni con sistemi terzi devono essere testate come sviluppi specifici.
Checklist tecnica sintetica: ASR (test in condizioni reali per lingua), TTS (intelligibilità, volume), RAG (pertinenza e fonti citate), gestione degli errori e fallback, latenza delle chiamate LLM, integrazioni critiche testate, disponibilità simulata 24/7.
Processo di escalation e gestione dei guasti in produzione
Definite in anticipo le situazioni in cui l'avatar deve invitare l'utente a contattare un membro del personale. Il pilota deve documentare questi casi per evitare rotture dell'esperienza: questioni normative sensibili, problemi di sicurezza, richieste che richiedono accesso a sistemi protetti o incomprensione persistente dopo diversi tentativi.
Non presumete un meccanismo automatico di trasferimento: prevedete messaggi tipo, il modo in cui l'avatar informa l'utente e la logica di raccomandazione verso un interlocutore umano. Il playbook 'Passare a un agente umano da un avatar IA' può servire come riferimento per formalizzare queste regole operative.
Template esportabili: scenari, griglia di osservazione e report di accettazione
Per agevolare l'esecuzione, ecco dei modelli che potete riprodurre in un foglio di calcolo o in uno strumento di raccolta:
Template scenario: ID | Nome scenario | Obiettivo | Lingua | Modalità (voce/touch) | Precondizione | Script utente | Azioni attese dall'avatar | Criterio successo/insuccesso | Note.
Template griglia di osservazione: ID test | Scenario | Partecipante (profilo) | Lingua | Inizio interazione | Trascrizione ASR | Risposta fornita | Durata | Intervento umano | Stato | Commenti dettagliati.
Template report di accettazione: Contesto pilota | Ambito testato | Sintesi risultati qualitativi | Sintesi risultati tecnici | Punti bloccanti | Miglioramenti richiesti | Elenco azioni prioritarie | Raccomandazione operativa (go / go con riserve / no‑go).
Punti specifici SANIA da verificare nel pilota
Tra le capacità confermate di SANIA, verificate durante il pilota: comunicazione multilingue configurata per le lingue rilevanti, interazione vocale e touch secondo la configurazione scelta, capacità di mantenere il contesto durante una sessione e sfruttamento della knowledge base di business fornita dalla vostra organizzazione. Questi elementi sono componenti nativi o configurabili la cui qualità va validata in condizioni reali.
Se il vostro progetto include integrazioni specifiche (inventario, orari, POS), trattatele come sviluppi distinti e testatele come tali. Allo stesso modo, la gestione di voci personalizzate o del voice cloning è possibile solo se diritti e configurazione sono forniti e devono essere convalidati durante il pilota.
FAQ rapida
Come misurare la soddisfazione senza strumentazione nativa? Un'organizzazione può raccogliere la soddisfazione a caldo tramite un breve sondaggio separato dopo l'interazione, o tramite la griglia di osservazione compilata da un tester. Questi metodi devono essere decisi prima del pilota.
Serve tradurre tutta la base documentale per ogni lingua? No. SANIA può comunicare in oltre 100 lingue quando è configurata. La priorità deve andare alle informazioni di business chiave e alla loro qualità nelle lingue realmente rilevanti per il vostro pubblico. La strategia di localizzazione dipenderà dai vostri obiettivi e risorse.