Introduzione: la sfida operativa
Distribuire un avatar IA vocale su un chiosco o uno schermo in un luogo pubblico comporta vincoli tecnici concreti: rumore ambientale variabile, interlocutori multilingue, disponibilità 24/7 e requisiti di riservatezza. Questa guida propone un percorso operativo per prendere decisioni pragmatiche su scelta dell'ASR, hardware audio, pipeline di preprocessing e pratiche di validazione e gestione.
L'obiettivo non è proporre una soluzione universale, ma esporre i compromessi da valutare in base al profilo ambientale e agli obiettivi di business, e fornire checklist e runbook utili a project manager, responsabili IT e integratori.
Perché questa scelta è critica
La qualità del riconoscimento vocale condiziona l'usabilità dell'interfaccia vocale. In un ambiente silenzioso, la maggior parte degli ASR moderni offre riconoscimenti soddisfacenti. In ambienti rumorosi, la degradazione dipende tanto dall'acustica e dal posizionamento del microfono quanto dai limiti del motore ASR.
Le scelte tecniche hanno anche implicazioni non funzionali: latenza, riservatezza dei flussi audio, costi operativi e facilità di manutenzione. È quindi essenziale progettare come una catena di elementi dipendenti: sensori audio, processing in edge, trasporto verso un servizio di riconoscimento e UX di fallback.
Matrice decisionale ASR: edge vs cloud
La prima scelta strategica riguarda la collocazione del motore ASR. Il cloud tende a offrire prestazioni migliori e aggiornamenti rapidi dei modelli, mentre una soluzione in edge riduce la latenza e limita l'invio di flussi audio a terzi. La scelta giusta dipende dal profilo di rumore, dai requisiti di riservatezza e dai vincoli di rete.
Per siti con connettività affidabile e requisiti di privacy tollerabili, il cloud facilita la gestione delle lingue e motori scalabili. Per siti con latenza critica, banda limitata o esigenze di forte riservatezza, l'ASR in edge può essere preferibile con una configurazione adeguata.
In pratica, un'architettura ibrida è spesso pertinente: preprocessing e rilevamento dell'attività vocale (VAD) in locale, con invio a motore cloud o edge a seconda della situazione e delle policy di privacy. La decisione tecnica va formalizzata nel capitolato e negli SLA di rete.
Microfoni e posizionamento: mono, array e montaggio
La scelta del sensore è tanto determinante quanto il motore ASR. Microfoni direzionali singoli possono bastare in ambienti silenziosi, mentre gli array microfonici consentono tecniche avanzate di spatializzazione e beamforming che migliorano significativamente il rapporto segnale‑rumore percepito dall'ASR.
Il posizionamento fisico influisce sulla cattura: altezza, distanza dall'utente, occlusioni e superfici riflettenti sono fattori da considerare durante l'installazione. Il design del chiosco e l'ergonomia tattile devono essere pensati congiuntamente al posizionamento del microfono per evitare zone morte acustiche.
Considerare un microphone array per siti rumorosi per abilitare beamforming e cancellazione dell'eco a seconda dell'hardware.
Privilegiare il posizionamento vicino alla zona di interazione, con marcatura visiva chiara che inviti l'utente a parlare verso il sensore.
Evitare posizioni vicine a fonti di rumore ricorrenti (cassa, estrattori, porte automatiche).
Pipeline di preprocessing audio: VAD, riduzione del rumore e beamforming
Prima di raggiungere l'ASR, la catena audio deve applicare diverse fasi di elaborazione per migliorare la qualità del segnale utile. Il voice activity detection (VAD) evita di inviare rumore continuo al motore e permette di controllare la latenza. La soppressione adattativa del rumore e i filtri di banda aiutano a stabilizzare il segnale.
Il beamforming sfrutta un array microfonico per privilegiare la direzione della voce dell'utente e attenuare i suoni fuori asse. A seconda dell'hardware, questi trattamenti possono essere eseguiti in locale (edge) o in cloud. Si raccomanda di progettare la catena affinché i componenti critici (VAD, cancellazione eco) restino disponibili anche in assenza di connettività.
Wake word, VAD e gestione delle attivazioni accidentali
La combinazione di wake word e VAD migliora l'ergonomia: un wake word ben scelto permette l'ascolto attivo senza catturare continuamente il flusso audio. Il wake word può essere eseguito in locale per motivi di privacy e reattività, mentre la VAD gestisce l'apertura della sessione.
Occorre però prevedere comportamenti UX chiari per evitare attivazioni accidentali in ambienti rumorosi: feedback visivo/sonoro breve all'attivazione, opzione tattile per avviare la voce e la possibilità di disattivare il micro tramite un controllo visibile o fisico secondo il progetto.
Rilevamento della lingua e strategia multilingue
Il rilevamento automatico della lingua agevola l'accoglienza multilingue, ma può essere perturbato dal rumore e da enunciati brevi. Si raccomandano due approcci complementari: proporre una scelta esplicita della lingua tramite l'interfaccia tattile all'inizio dell'interazione e usare il rilevamento automatico come supporto quando il segnale vocale è sufficientemente lungo e stabile.
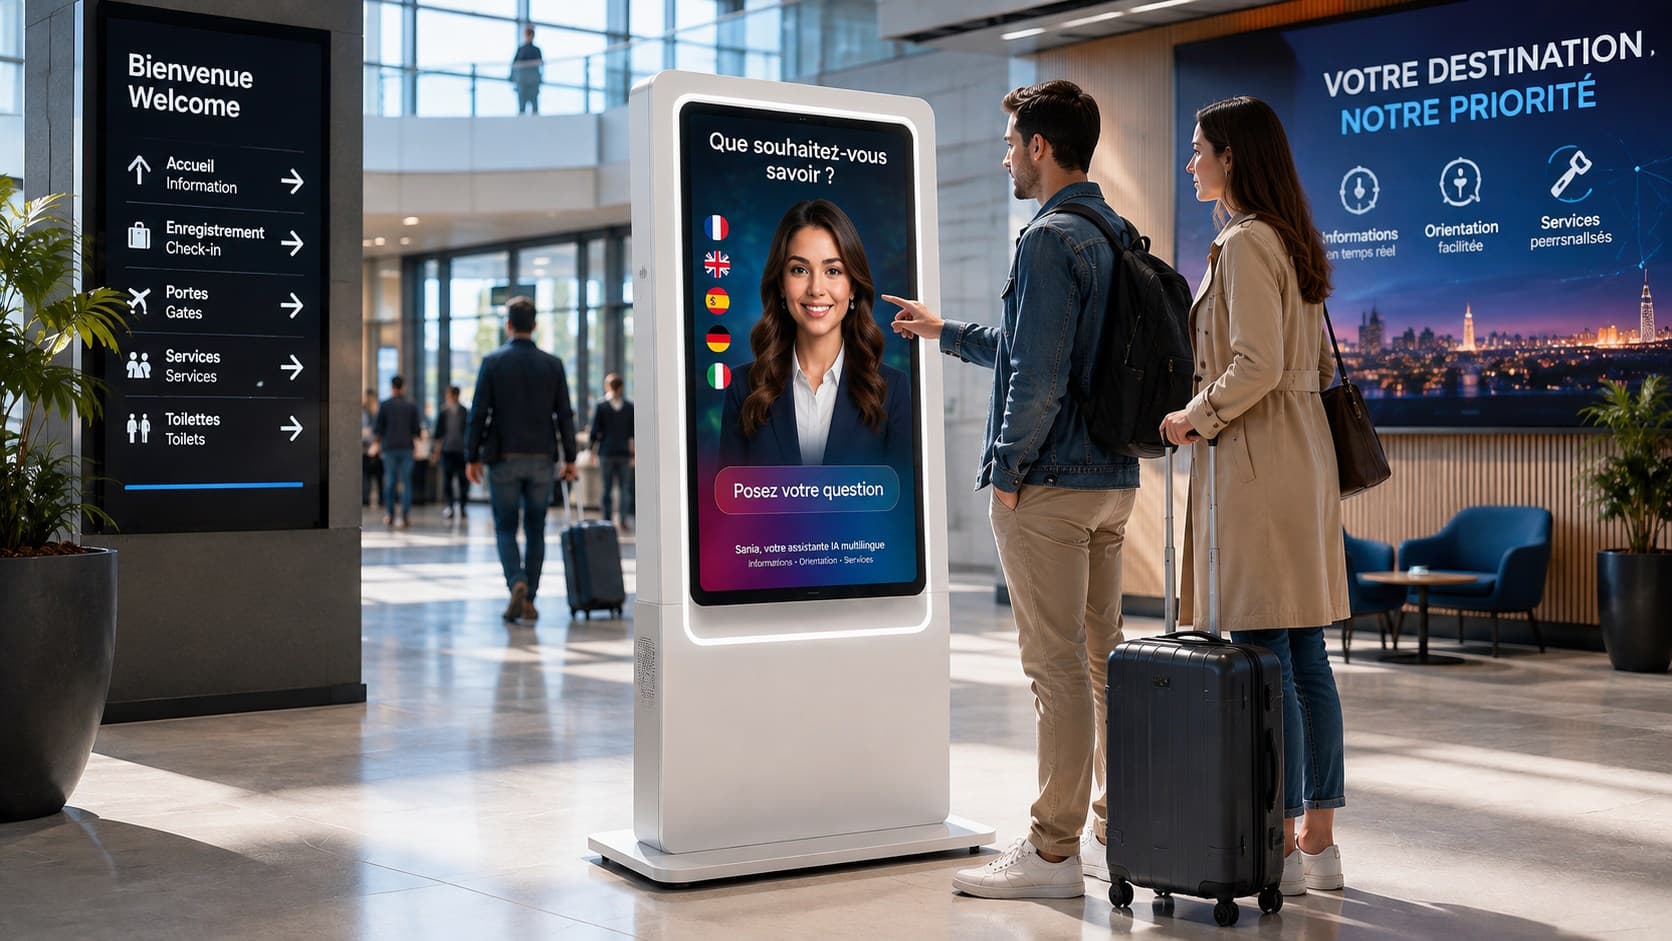
In ogni caso, privilegiare un'UX multimodale: mostrare le lingue disponibili, permettere un rapido cambio tattile e assicurare che la knowledge base di business sia aggiornata nelle lingue rilevanti. SANIA può comunicare in oltre 100 lingue a seconda della configurazione, il che agevola l'implementazione quando l'infrastruttura ASR supporta le lingue target.
Fallback tattile ed esperienza multimodale
Nessun sistema vocale è infallibile in tutte le circostanze. Prevedere un fallback tattile o visivo è indispensabile per mantenere l'accesso al servizio. Per esempio, se la confidenza dell'ASR è bassa o la rilevazione dell'attività fallisce ripetutamente, l'interfaccia deve offrire chiaramente l'opzione tattile per proseguire il compito.
L'UX deve rendere fluida la transizione voce‑tattile: pulsanti di suggerimento, menu contestuali e scorciatoie precompilate riducono il carico cognitivo. La persona dell'avatar può guidare l'utente verso queste alternative senza interrompere l'esperienza.
Protocolli di test in condizioni reali
I test di laboratorio non sono sufficienti: è necessario validare la catena vocale on site, negli orari di affluenza reale e con parlanti nativi delle lingue target. Costruire set di scenari rappresentativi (domande tipiche, accenti, durate delle enunciazioni) e registrare le interazioni per analisi qualitativa e correzione dei punti deboli.
I test devono coprire la resilienza della rete, la latenza, i tassi di falsi trigger del wake word e le situazioni di rumore improvviso. I risultati orienteranno la calibrazione della pipeline audio, la scelta tra edge e cloud e le regolazioni di sensibilità del VAD.
Manutenzione e runbook 24/7: checklist operativa
Un'esercizio affidabile richiede procedure di manutenzione chiare e accessibili ai team locali o ai fornitori. Il runbook deve descrivere le verifiche periodiche, le azioni d'emergenza e le operazioni di monitoraggio per garantire disponibilità continua.
Privilegiare procedure semplici e ripetibili, e prevedere strumenti di diagnostica remota secondo la configurazione. L'aggiornamento dei componenti software (driver audio, firmware del chiosco, moduli di preprocessing) deve essere pianificato e tracciato.
Ispezione visiva e pulizia delle griglie dei microfoni e degli altoparlanti.
Verifica delle connessioni di rete e alimentazione prima di intervenire sull'ASR.
Controllo dei log locali ed estrazione periodica delle tracce audio quando la policy di privacy lo consente.
Verifica delle versioni software e applicazione controllata delle patch.
Procedura di switch in modalità tattile se persiste un incidente audio.
Configurazioni tipo in base al livello di rumore
Per facilitare la decisione, ecco indicazioni pratiche per profilo acustico. Rimangono raccomandazioni generali da adattare al contesto.
Basso rumore: un'interfaccia vocale con microfono direzionale e ASR cloud è accettabile. Il preprocessing può essere minimo e l'UX può privilegiare la voce come input principale.
Rumore medio: un microphone array con beamforming, VAD locale e soppressione adattativa del rumore migliora la robustezza. Un'architettura ibrida (preprocessing locale, ASR cloud o edge) è spesso pertinente.
Forte rumore: privilegiare un sensore di qualità (array), processing locale avanzato, wake word in edge e una strategia di fallback tattile sistematica. La riservatezza può anche raccomandare il trattamento locale dei segmenti sensibili prima di qualsiasi invio.
FAQ breve
D: È sempre necessario scegliere un array microfonico per ambienti rumorosi? R: Un array fornisce vantaggi tecnici (beamforming) ma comporta un aumento dei costi hardware e un'integrazione più rigorosa. Spesso è la soluzione più efficace per ambienti rumorosi, ma la decisione va giustificata dall'uso previsto e dal budget del progetto.
D: Come misurare che il riconoscimento vocale sia sufficiente per accettare un deployment? R: Oltre alle misure tecniche, definire criteri di accettazione chiari nel capitolato e validare on site con scenari rappresentativi consente di decidere. Tali criteri dovrebbero includere tassi di errore percepibili, latenza di interazione e la capacità degli utenti di raggiungere il proprio obiettivo tramite la voce o il fallback tattile.