Introduzione: perché un TCO preciso è indispensabile
Decidere un pilota o un rollout multi‑sito di un avatar IA su totem interattivo richiede una cifra credibile, accettata dalla direzione e dall’IT. Il costo non si limita all’acquisto del totem: copre l’infrastruttura hardware, le licenze LLM, la sintesi e il riconoscimento vocale, la connettività, l’integrazione con i sistemi di business, la manutenzione 24/7 e la governance dei contenuti.
Questo articolo propone un metodo operativo per scomporre queste voci, stimare il consumo di token e costruire scenari pilota / 10 / 100 siti. L’obiettivo: fornire riferimenti concreti per redigere un budget, negoziare contratti e definire leve di ottimizzazione.
Voci di costo da considerare
Per costruire un TCO completo, raggruppate le spese in CAPEX (investimenti iniziali) e OPEX (costi ricorrenti). Ogni voce di seguito deve comparire nel vostro foglio di calcolo.
Hardware e installazione (CAPEX): schermo o totem interattivo, supporto fisico, contenitore audio, microfoni e altoparlanti, eventuale protezione fisica e installazione di rete in sede. Considerate i costi di trasporto e installazione on site.
Software e licenze (OPEX/CAPEX a seconda del contratto): licenza del software dell’avatar, costi di accesso ai motori LLM (tariffazione a token o abbonamento), licenze TTS (sintesi vocale) e ASR (riconoscimento vocale) se fatturate separatamente, licenze OS o applicazione kiosk.
Integrazioni e sviluppo (CAPEX / OPEX iniziale): adattamento della knowledge base, sviluppo di API per collegare POS, inventario o CRM, configurazione del RAG e test multilingue. Includete la validazione legale dei contenuti quando necessario per risposte sensibili di business. Questi costi coprono anche UAT e aggiustamenti UX voce/touch prima della produzione locale o del pilota multi‑sito.
Costi operativi ricorrenti da budgettare
Operare un avatar IA comporta costi ricorrenti spesso sottostimati. Individuate e budgettizzate chiaramente:
Costi LLM: fatturazione a token o tramite abbonamento. Il costo dipenderà dal volume di richieste, dalla dimensione media di prompt e risposte e dalla politica tariffaria del fornitore. A seconda della configurazione, più motori LLM possono essere orchestrati per bilanciare qualità e costi.
Costi voce: TTS e ASR possono essere fatturati a minuti, per numero di richieste o tramite abbonamento. Il riconoscimento vocale in ambienti rumorosi può aumentare il volume di richieste (ritrasmissioni, retry); tenetene conto.
Connettività e dati: banda per chiamate API, costo di connessioni ridondanti per garantire disponibilità, eventuali costi di storage e trasferimento per gli embeddings se la soluzione memorizza vettori in cloud o on‑premise secondo la configurazione RAG scelta.
Metodo passo dopo passo per stimare il consumo LLM (formula operativa)
Invece di inventare cifre, definite variabili misurabili e applicate una formula semplice. Ecco i passaggi e la formula da integrare nel vostro foglio di calcolo:
1. Misurare o stimare il traffico: numero medio di interazioni per totem al giorno, distinguendo interazioni touch e vocali. 2. Stimare la dimensione media di un’interazione in token: prompt utente + contesto inviato al LLM + risposta generata. 3. Moltiplicare token per interazione per il numero di interazioni nel periodo desiderato (mese/anno). 4. Applicare la tariffa del fornitore espressa per 1000 token (o altra unità).
Formula sintetica da implementare: Costo LLM periodico = (interazioni/giorno x giorni) x (token medi per interazione / 1000) x (prezzo per 1000 token).
Stessa logica per TTS/ASR: stimare il tempo medio di audio generato o processato per interazione e moltiplicare per la tariffa del fornitore (a minuto o per richiesta).
Costruire scenari: pilota, 10 siti, 100 siti (modello di calcolo da adattare)
Piuttosto che comunicare importi, strutturate tre scenari nel foglio di calcolo usando le stesse variabili precedenti. Per ogni scenario, indicate: numero di unità (totem), traffico stimato per totem, esigenze multilingue (numero di lingue attivate), modalità voce attiva o no, architettura (edge, cloud, ibrida) e livello di SLA atteso.
I costi CAPEX si moltiplicano per il numero di unità per hardware e installazione, mentre alcuni costi OPEX possono beneficiare di economie di scala (ad esempio licenza centrale, hosting condiviso, monitoraggio centralizzato). Compilate le colonne: unità, quantità, prezzo unitario (fornitore), periodicità, totale periodico e totale annualizzato.
Incluete una colonna dedicata ai “costi di integrazione una tantum” per sito e un’altra per i “costi di gestione centralizzati” (supporto, aggiornamento contenuti, hosting degli embeddings). Prevedete una cella per imprevisti e uno scenario di sensibilità basato su variazioni di traffico o aumenti dei prezzi dei token.
Leve concrete di ottimizzazione economica
Diverse decisioni tecniche e operative influenzano fortemente il TCO. Ecco le leve che potete testare o negoziare:
Edge vs cloud: processare alcune richieste localmente riduce i costi delle chiamate LLM e la latenza, ma aumenta CAPEX e la manutenzione locale. Un approccio ibrido permette di esternalizzare le richieste complesse e gestire localmente le FAQ comuni.
Cache e pre‑generazione: mettere in cache risposte frequenti o pre‑generare contenuti statici riduce il volume di token inviati al LLM.
Orchestrazione multi‑LLM: instradare le richieste meno costose verso modelli più economici e riservare i modelli premium per i casi che richiedono risposte più articolate.
TTS localizzato: usare voci locali (edge TTS) per interazioni frequenti può ridurre il conto TTS, a condizione di sostenere i costi hardware e di manutenzione.
Ottimizzazione di prompt e RAG: strutturare la knowledge base per limitare la quantità di contesto inviata al LLM. L’uso di una ricerca semantica ben progettata può ridurre token inutili, ma comporta costi di storage e aggiornamento degli embeddings a seconda della configurazione (on‑prem o cloud).
Clausole contrattuali e SLA da negoziare
I contratti con fornitori LLM, TTS/ASR, fornitore dell’avatar o integratore devono coprire punti precisi per tutelare il vostro budget e il livello di servizio:
Prezzi e granularità dell’unità: specificare l’unità fatturata (token, richieste, minuti), le fasce tariffarie e i meccanismi di overage.
SLA di disponibilità e penali: definire l’impegno di disponibilità per l’API e le eventuali penalità legate a interruzioni che impattino il servizio sul totem.
Impegni di performance: latenza media attesa per le risposte e per la TTS, e tempo massimo accettabile in caso di degrado.
Supporto e orari: livello di supporto (ore lavorative vs 24/7), tempi di risposta, processo di escalation e contatto dedicato.
Sicurezza e trattamento dei dati: obblighi su conservazione, cancellazione, localizzazione dei dati e condizioni d’uso dei contenuti business forniti (RAG, embeddings).
Clausole di uscita e portabilità: condizioni di recesso, accesso ai dati esportabili e modalità per riprendere la knowledge base in caso di cambio fornitore.
Checklist procurement e template di calcolo da preparare prima della gara
Prima di lanciare una gara o una negoziazione, preparate un dossier strutturato contenente le vostre variabili di business e i requisiti tecnici:
Descrizione degli usi prioritari e volume previsto per totem (interazioni voce / touch), per periodo.
Elenco delle integrazioni necessarie (POS, inventario, CRM) e requisiti di autenticazione.
Esigenze multilingue e qualità vocale (TTS) attesa per ciascuna lingua.
Livello di disponibilità desiderato e ritmo di aggiornamento della knowledge base.
Metodologia di stima dei costi che vi aspettate dai fornitori (condividete il vostro foglio di variabili per ottenere confronti omogenei).
Punti contrattuali non negoziabili: SLA minimo, sicurezza dei dati e ripristino in caso di uscita.
Domande frequenti (FAQ) utili per il steering committee
D: Come giustificare lo scarto tra CAPEX elevato e OPEX ridotto sul lungo periodo? R: Presentate più orizzonti di confronto (costo totale annualizzato) e mettete in evidenza i costi ricorrenti principali (LLM, TTS, supporto). Il comitato deve comprendere il punto di pareggio e le leve per spostarlo.
D: Conviene privilegiare l’edge per ridurre la spesa LLM? R: L’edge riduce alcune chiamate a modelli a pagamento ma richiede maggiore investimento hardware e manutenzione locale. Una strategia ibrida è spesso la più pragmatica: processare localmente le interazioni di scarso valore e delegare al cloud i casi complessi.
Per approfondire e prossimi passi
Per trasformare questa guida in cifre concrete, scaricate o create un foglio di calcolo con le variabili citate e invitate i fornitori a compilare le loro tariffe unità in base agli usi stimati. Testate almeno un pilota su un sito per misurare i token medi per interazione e aggiustare gli scenari 10/100 siti.
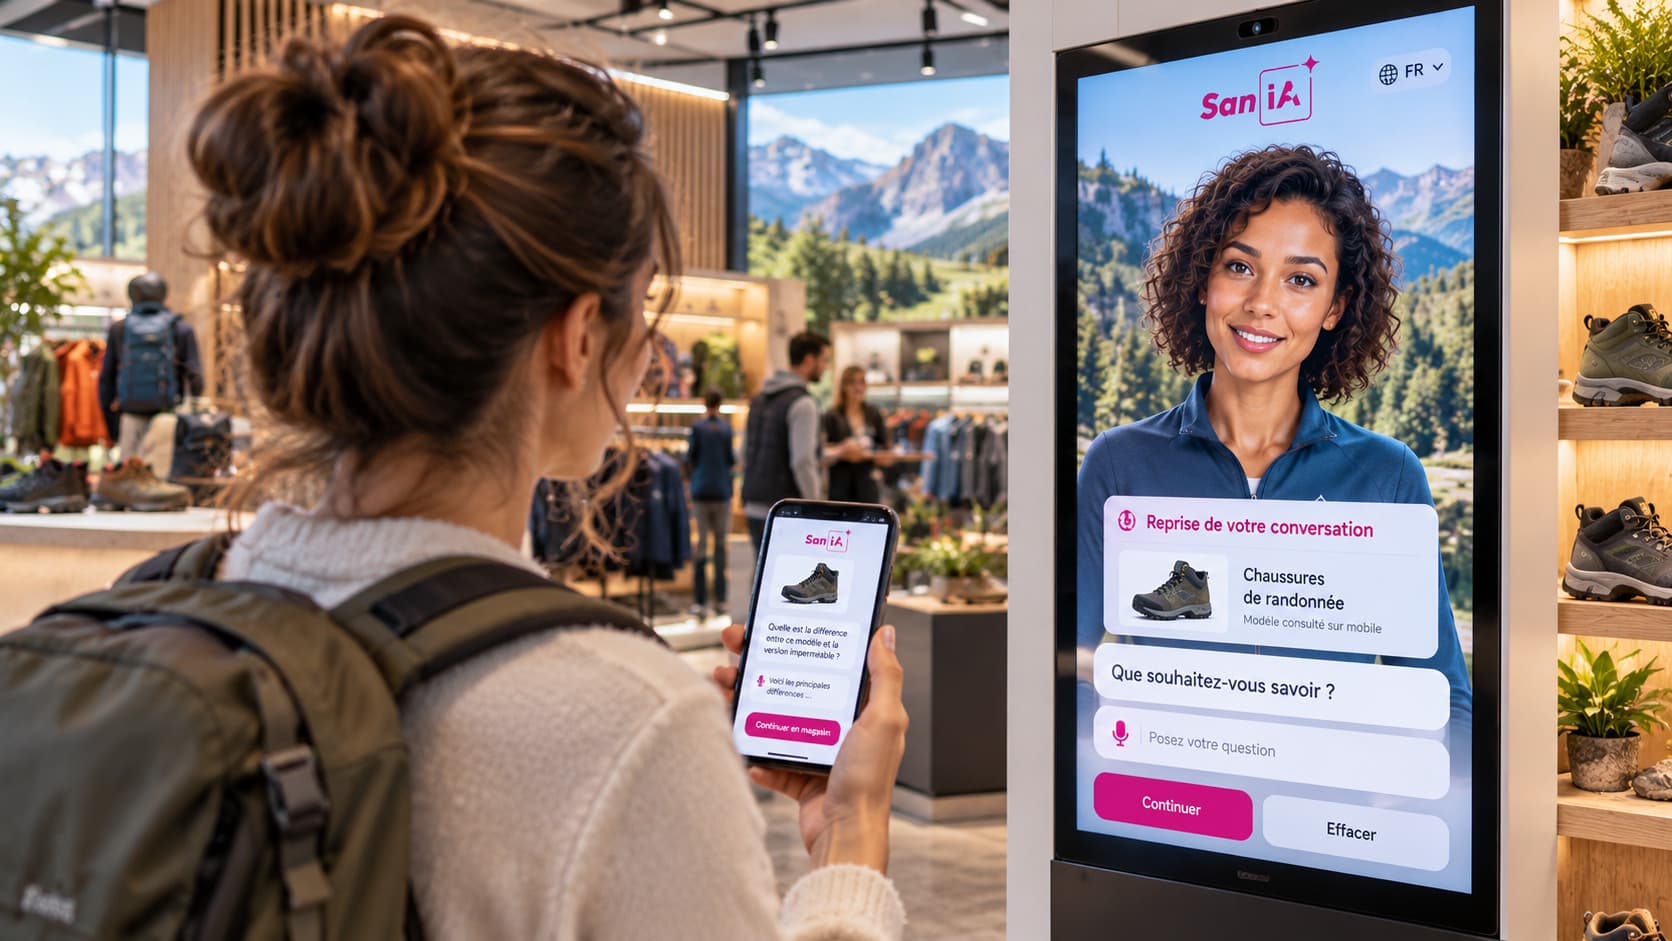
SANIA può essere distribuita su schermo o totem interattivo, funzionare via voce e/o touch e appoggiarsi a una knowledge base propria dell’organizzazione. Per analizzare con precisione come queste scelte impattano il vostro TCO nel vostro contesto (architettura edge vs cloud, orchestrazione multi‑LLM, TTS/ASR), potete richiedere una dimostrazione e un preventivo su misura per la vostra rete di siti.