Introducción breve
Los equipos que despliegan un avatar IA de bienvenida respaldado por una base RAG se enfrentan a un riesgo concreto: pueden aparecer errores factuales o alucinaciones en respuestas visibles para los visitantes. Estos errores afectan la confianza, la calidad del servicio y la seguridad de la información. Este artículo propone un marco operativo para medir la factualidad, detectar alucinaciones en pruebas y en producción, y aplicar remediaciones que respeten la disponibilidad 24/7 de un servicio de acogida.
Por qué medir la factualidad para un avatar de bienvenida
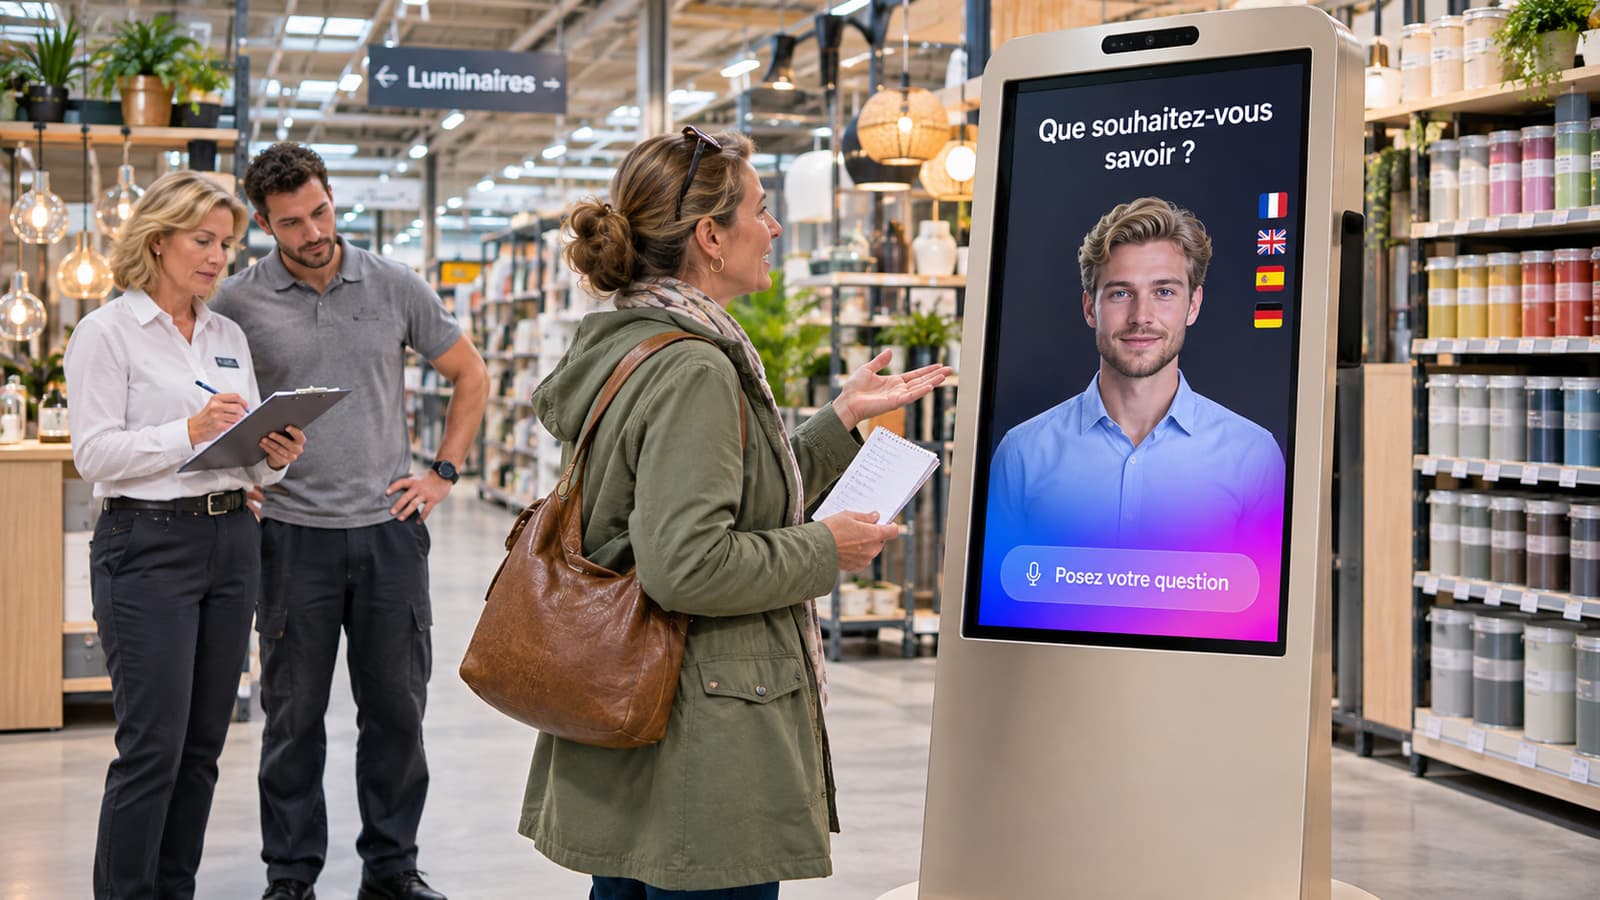
Un avatar IA de bienvenida actúa como primer punto de información en un entorno físico. A diferencia de una herramienta interna, sus respuestas son públicas y están directamente ligadas a la imagen de la organización. Medir la frecuencia y gravedad de los errores factuales permite priorizar acciones correctivas, definir SLA aceptables y elegir patrones de mitigación adecuados al nivel de riesgo (información comercial, asesoramiento regulatorio, indicaciones de seguridad, etc.).
Medir no consiste solo en contar errores. Hay que caracterizar las situaciones de riesgo, distinguir errores menores de críticos y proporcionar a los equipos técnicos y de negocio indicadores accionables para impulsar mejoras.
Definir métricas de factualidad utilizables
Antes de cualquier instrumentación, acuerde con los equipos de negocio un conjunto de indicadores simples y accionables. Aquí hay tipos de métricas a considerar, presentadas como opciones para adaptar al contexto:
1. Tasa de incidentes detectados en una muestra anotada. Se trata de una medida de muestreo manual para estimar la frecuencia de las alucinaciones en interacciones representativas.
2. Tasa de respuestas con procedencia (citación de fuente) cuando la configuración RAG lo permita. La presencia de un extracto documentado reduce el riesgo percibido pero no anula el error.
3. Puntuación de divergencia entre la respuesta generada y los documentos recuperados. Según la arquitectura, la búsqueda semántica puede devolver una puntuación de similitud utilizable como señal de alerta. Esa señal debe interpretarse junto con otros indicadores y logs, y necesita una configuración adecuada.
Constituir juegos de pruebas y protocolos offline
Las pruebas fuera de producción permiten identificar tendencias antes de que afecten a los usuarios. Constituya varios juegos de pruebas:
1) Juego de regresión de negocio: preguntas típicas extraídas de FAQ, documentos PDF/DOCX/XLSX/TXT/CSV y casos de uso críticos validados por los gestores del conocimiento. Anotación: cada respuesta esperada se documenta y valida por un referente de negocio.
2) Juego adversarial: preguntas formuladas para provocar alucinaciones (ambigüedades, preguntas compuestas, manipulación de entidades). Estos casos prueban la robustez de la generación y de la contextualización RAG.
3) Juego de no‑respuesta: frases fuera del perímetro que deben conducir a una respuesta del tipo "no lo sé" o a una derivación hacia un humano. Verifique que el sistema no «complete» respuestas de forma errónea.
Detección automática en producción: señales y prácticas
En producción, la detección automática se basa en una combinación de señales procedentes de la cadena RAG, del LLM y de la interfaz. Las señales útiles incluyen, entre otras:
• metadatos de la búsqueda semántica (puntuación de similitud, lista de documentos fuente devueltos);
• indicadores relacionados con la generación (si el motor expone puntuaciones o heurísticas configurables);
• eventos de interfaz: peticiones de clarificación repetidas, reformulaciones inmediatas del usuario, señales explícitas del usuario (botón de feedback, pulgar hacia abajo);
Recopilar y correlacionar estas señales en una plataforma de observabilidad permite activar flujos de investigación.
Utilice reglas simples al inicio (por ejemplo correlación de una baja puntuación de similitud y un feedback negativo) y luego afínelas con modelos de anomalía.
Patrones operativos de mitigación
Cuando la detección identifica una respuesta en riesgo, se pueden aplicar varios patrones de mitigación según la gravedad y la configuración:
1. Fallback conservador: preferir una respuesta que limite el alcance (por ejemplo indicar que la pregunta requiere verificación) en vez de una respuesta potencialmente incorrecta. Esto se concibe como una elección editorial y de UX.
2. Source‑first: configurar el avatar para citar la fuente o indicar la procedencia de la información cuando la respuesta se apoya en la base RAG. La cita reduce la sorpresa y facilita la comprobación por parte del usuario y de los equipos de negocio.
3. Call‑to‑verify mediante herramientas y webhooks: cuando existe integración posible, desencadenar una llamada de función o un webhook hacia un servicio de verificación externo o hacia una API de negocio. Esta capacidad requiere una integración específica y debe quedar explícita en la arquitectura del proyecto.
Orquestación multi‑LLM y verificación en cascada
Una estrategia eficaz para reducir los errores factuales es el uso orquestado de varios modelos. Ejemplos de patrones aplicables según la configuración:
• Enrutamiento por riesgo: dirigir consultas simples a un modelo eficiente y económico, y las consultas señaladas como de alto riesgo a un modelo más robusto o especializado.
• Cascada de verificación: generación inicial por un LLM, seguida de reevaluación o reformulación por un segundo motor que verifique la coherencia con los fragmentos RAG. Esta implementación es avanzada y requiere un orquestador y criterios de decisión compartidos.
Estos patrones pueden combinarse con llamadas de función para realizar comprobaciones factuales externas. Cualquier orquestación multi‑LLM debe probarse offline e instrumentarse para vigilar latencia y coste.
Workflow human‑in‑the‑loop y ciclos de corrección
La corrección sostenible de las alucinaciones implica un proceso humano estructurado. Un workflow operativo recomendado incluye:
• Triage automatizado: las interacciones marcadas se colocan en una cola de revisión para evaluación humana. Esta cola debe incluir el contexto conversacional y los documentos fuente usados por la RAG.
• Anotación y remediación: los gestores del conocimiento validan la respuesta correcta y, si procede, corrigen o enriquecen los documentos de la base de conocimiento. Los cambios deben seguir la gobernanza existente de la KB (validación, versionado, pruebas).
• Pruebas de regresión: integrar los casos corregidos en el juego de regresión para evitar regresiones al actualizar el motor o la base documental. La cadencia de revisión y los roles implicados deben definirse según la criticidad.
SLA, alertas y organización de la supervisión
Para que estos mecanismos sean explotables por TI y los equipos de conocimiento, formalice algunos elementos operativos:
• definir umbrales cualitativos de alerta y procedimientos de escalado acordados entre TI, gestores del conocimiento y equipos de producto;
• integrar las señales de factualidad en la plataforma de monitorización SRE para obtener alertas separadas de negocio y técnicas;
• prever un runbook que explique los pasos de verificación, corrección y rollback ante una deriva detectada. El runbook debe especificar quién opera las correcciones en la base documental y cómo validar la eficacia de las medidas.
Errores frecuentes y puntos de vigilancia
Algunos errores observados en proyectos RAG/LLM y consejos para evitarlos:
• Esperar una "confianza" universal del LLM. No considere una puntuación generada por un modelo como una prueba absoluta. Es preferible cruzar varias señales y hacer validar los casos críticos por un humano.
• No versionar los juegos de pruebas. Sin historial, es imposible medir regresiones tras una actualización de modelo o documentos.
• Confundir disponibilidad 24/7 con tolerancia a errores. Mantener la disponibilidad no debe ocultar la necesidad de un fallback conservador cuando la incertidumbre es alta.
Checklist operativa rápida
Antes de lanzar un piloto o pasar a producción, verifique que dispone de:
Juegos de pruebas de negocio y adversariales anotados y versionados.
Instrumentación de señales RAG y LLM exportadas a la plataforma de observabilidad.
Workflow de triage human‑in‑the‑loop definido y roles asignados.
Política de fallback y reglas UX para respuestas en riesgo.
Plan de alertas y runbook SRE que incluya contactos de negocio.
Conclusión y siguientes pasos prácticos
Medir y reducir las alucinaciones de un avatar IA de bienvenida alimentado por RAG exige un enfoque que combine métricas claras, pruebas rigurosas, detección en producción y workflows de corrección liderados por personas. Varios patrones técnicos contribuyen a la mitigación: fallbacks conservadores, citas de fuente, llamadas de función para verificación externa y orquestación multi‑LLM según la criticidad. Estos elementos deben integrarse en la gobernanza de la base de conocimiento y en las prácticas SRE de la organización.
SANIA puede configurarse para explotar una base de conocimiento propia, usar la búsqueda semántica RAG, orquestar varios motores LLM y desencadenar llamadas de función o webhooks según la arquitectura elegida. Para evaluar concretamente cómo estos patrones podrían aplicarse a su contexto de recepción, puede solicitar una demostración de SANIA y discutir un protocolo piloto adaptado a sus retos.