
Introducción: por qué una observabilidad pensada desde SRE para un avatar IA físico
Un avatar IA desplegado en pantalla o kiosco opera en un entorno distribuido que combina componentes locales (UI táctil, E/S de audio, periféricos) y servicios cloud u on‑premise (ASR, LLM, TTS, RAG, integraciones de negocio). Garantizar disponibilidad 24/7 y detección rápida de degradaciones requiere un enfoque de observabilidad diseñado para la explotación, no solo para el desarrollo.
Esta guía ofrece un playbook operativo para definir SLO y SLA adecuados, construir tests sintéticos end‑to‑end que incluyan recorridos táctiles y vocales, diseñar logs trazables y privacy‑safe, implementar dashboards y alertas accionables, y organizar runbooks y on‑call. Las recomendaciones son aplicables a un despliegue SANIA en pantalla o kiosco, teniendo en cuenta las especificidades de hardware e integraciones del proyecto.
Definir SLO y SLA pertinentes antes de cualquier supervisión
Los SLO (objetivos de nivel de servicio) traducen en criterios explotables lo que significa un servicio aceptable para usuarios y organización. Los SLA son compromisos contractuales o internos que se apoyan en esos SLO. Para un avatar IA en espacio público, es importante alinear SLO/SLA con las expectativas de negocio y las capacidades técnicas reales.
En lugar de imponer métricas técnicas aisladas, estructura los objetivos alrededor de la experiencia: disponibilidad del servicio vocal y táctil en sitio, latencia de respuesta perceptible por el usuario, capacidad para ofrecer una respuesta pertinente desde la base documental, y tolerancia a degradaciones de integraciones en tiempo real.
Mapear los recorridos críticos (p. ej. orientación de visitante, información de producto, escenario de pago si existe) y definir qué componentes deben medirse para cada recorrido.
Transponer las expectativas de negocio en medidas observables: disponibilidad, latencia percibida, tasa de fallback a mensaje de error o a ayuda humana, frescura de contenidos RAG.
Documentar dependencias externas (ASR, LLM, TTS, APIs de negocio) y precisar qué niveles de servicio son contractuales y cuáles corresponden a monitorización operativa.
Diseñar tests sintéticos end‑to‑end que cubran táctil y vocal
El synthetic monitoring permite detectar regresiones antes de que afecten masivamente a los usuarios. Para un kiosco interactivo, un plan de tests sintéticos debe cubrir los recorridos táctiles, las interacciones vocales completas (ASR -> LLM -> TTS), y los escenarios que consultan la base documental RAG o APIs externas.
Los tests sintéticos pueden ejecutarse desde la nube, un agente on‑premise o desde dispositivos ubicados en el sitio. Deben reproducir fielmente la cadena completa de interacción y verificar no solo el éxito técnico sino también la calidad funcional mínima (por ejemplo, respuesta no vacía, ausencia de error técnico, latencia aceptable).
Tests táctiles: flujo de bienvenida, navegación de menús, sucesión de pantallas, validación de botones y renderizado visual.
Tests vocales end‑to‑end: inyección de un archivo de audio o síntesis vocal simulada, verificación de la transcripción ASR, evaluación de la respuesta del LLM/RAG, restitución TTS y comprobación de la salida de audio.
Tests de integración en tiempo real: llamadas a APIs de negocio simuladas, verificación de códigos de error y comportamiento en caso de indisponibilidad (degradación controlada).
Tests de frescura RAG: consultas dirigidas a documentos recientemente actualizados para comprobar que la base documental devuelta es coherente.
Diseñar logs privacy‑safe y trazables
La calidad de los logs es esencial para diagnosticar un incidente. Paralelamente, hay que garantizar la confidencialidad de las conversaciones y respetar las obligaciones legales. Diseña logs que sigan siendo explotables para los equipos SRE minimizando los datos personales almacenados.
Adopta principios claros: separar metadatos operativos del contenido de usuario, usar identificadores de correlación no reversibles y aplicar políticas de anonimización o seudonimización según la naturaleza de los datos y la configuración del proyecto.
Incluir sistemáticamente un correlation id global para una sesión (correlable entre UI local, ASR, LLM, TTS y llamadas API).
Registrar las metadatas útiles para diagnóstico: timestamps, latencias por etapa, códigos de error, versión del modelo LLM, identificadores de despliegue y de máquina.
Evitar almacenar la transcripción completa o el audio bruto sin justificación operacional. Cuando la conservación sea necesaria para el análisis, aplicar medidas robustas de anonimización y minimizar la retención conforme a las decisiones RGPD del proyecto.
Conservar trazas de acciones del sistema y de etapas de procesamiento RAG (qué fuente documental se consultó) sin exponer el contenido sensible en sí.
Correlación multi‑componentes para diagnosticar ASR, LLM, TTS e integraciones
Un incidente aparentemente global puede provenir de un solo componente: un ASR degradado, un motor LLM en degradación, latencia de red en una API de negocio, o un problema local en el kiosco. La correlación de trazas entre componentes es por tanto imprescindible para aislar rápidamente la causa raíz.
Diseña pipelines de logs y trazas que permitan reconstruir una sesión completa. Usa correlation ids propagados a través de cada llamada y conserva metadatos que indiquen la ruta ejecutada y las latencias por etapa.
Trazar la entrada del usuario, la petición enviada al servicio ASR, la transmisión hacia LLM/RAG, la petición TTS y la restitución final, con latencia y estado para cada etapa.
Incluir el ID de versión de los modelos o configuraciones (ASR model vX, LLM routing, índice RAG) para facilitar rollbacks o análisis de regresiones tras un despliegue.
Conservar identificadores de las peticiones a APIs externas y los códigos de respuesta para evaluar incidentes de integración sin necesariamente almacenar la carga útil.
Dashboards y alertas accionables para equipos de Ops
Los dashboards deben sintetizar el estado del servicio para permitir una toma de decisión rápida. Deben orientarse a la acción y enlazarse con alertas claras, evitando ruido y favoreciendo la priorización de incidentes.
Diseña alertas diferenciadas: aquellas que requieren intervención inmediata y las que precisan investigación planificada. Documenta el nivel de impacto esperado para cada tipo de alerta para guiar al on‑call.
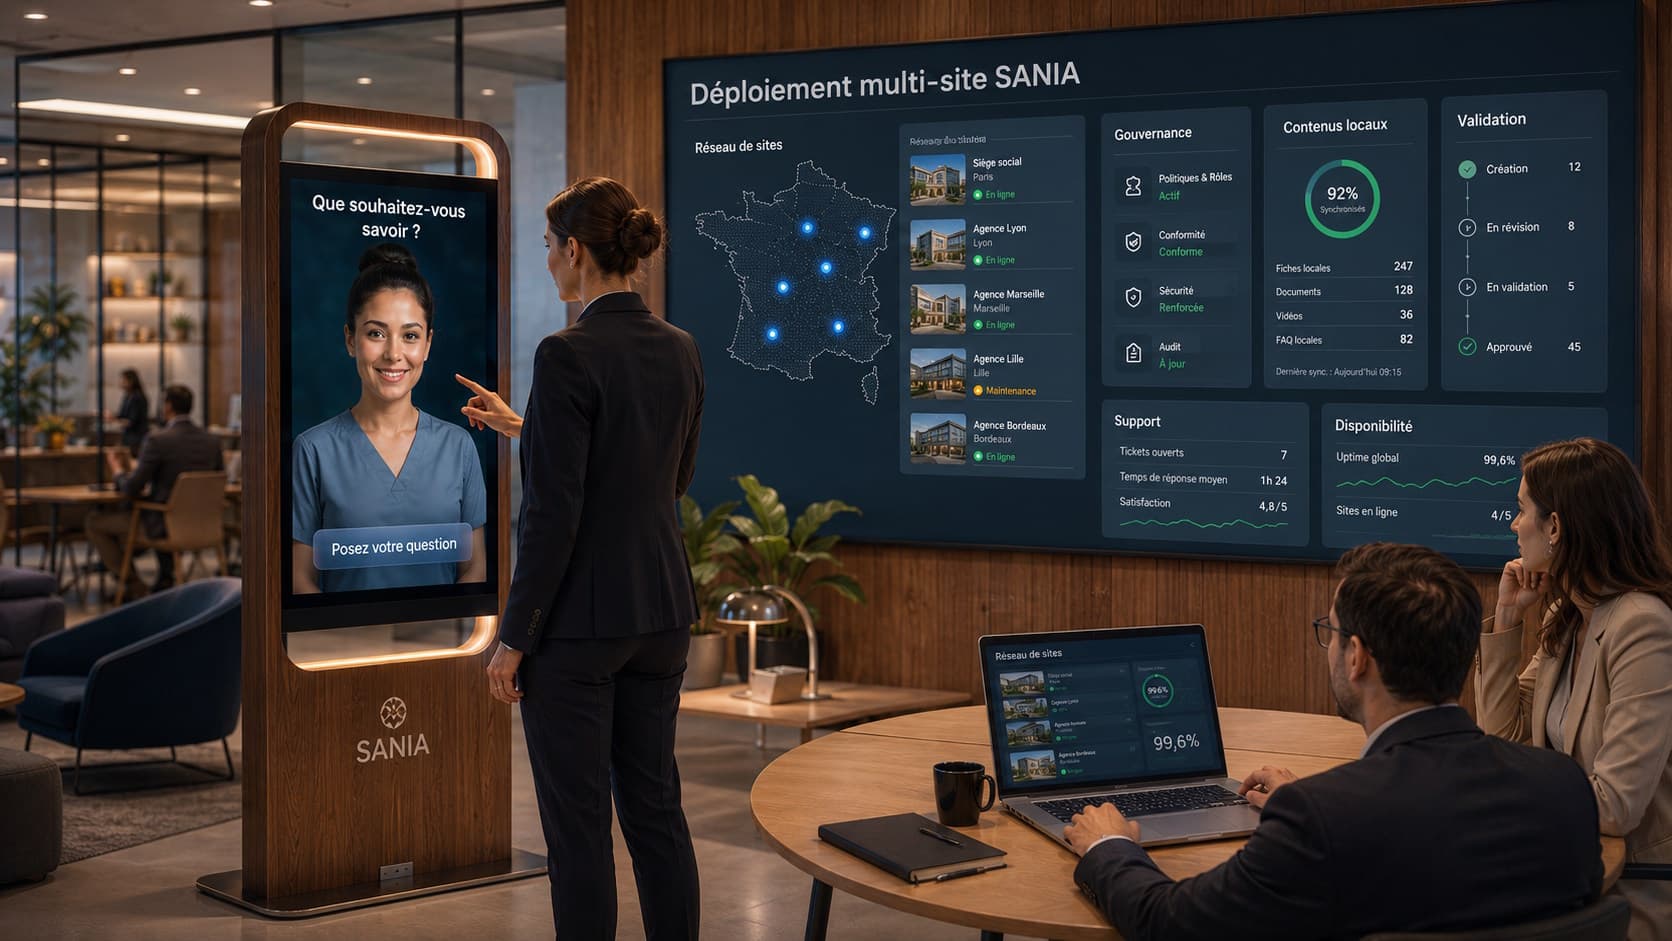
Ejemplos de vistas de Dashboard: cartografía de sitios y estado de kioscos, latencia media por componente, trazas de error ASR/LLM/TTS agregadas, tasa de fallback funcional.
Alertas recomendadas: indisponibilidad de un servicio crítico (ASR/LLM/TTS), aumento sostenido de errores de integración, degradación perceptible de latencia media, anomalías en la frescura RAG que indiquen drift de contenido.
Priorizar alertas con contexto enriquecido: logs correlados, pasos afectados, último test sintético que falló y sugerencias operativas extraídas del runbook.
Runbook, on‑call y procedimientos de escalado adaptados a avatars IA
Un buen runbook debe ser pragmático y centrado en los síntomas observables. Para cada alerta o incidente tipo, documenta los pasos de diagnóstico rápido, las verificaciones a realizar en el sitio y las acciones de mitigación posibles.
La organización on‑call debe prever roles claros: quién opera la infraestructura local, quién interroga servicios cloud y quién gestiona las integraciones de negocio. Evita apoyarte en transferencias automáticas no definidas en el proyecto; documenta los contactos y los modos de comunicación.
Estructura de un runbook de incidente: descripción del síntoma, comprobaciones iniciales, comandos o consolas a consultar, método de correlación de logs, acciones de mitigación temporales, criterios de fallback y escalado.
Incluir procedimientos para tests rápidos en sitio (reinicio controlado, conmutación de red, verificación de hardware de audio/táctil) y scripts de extracción de logs correlados.
Prever ejercicios regulares para validar los runbooks y mantener la capacidad de respuesta de los equipos.
Estrategias de despliegue y patrón canary para limitar riesgos
Los despliegues de componentes críticos (nuevo modelo LLM, actualización de ASR, cambio en pipeline RAG) deben minimizar el riesgo de afectar todo el parque. El canary deployment es un patrón útil: desplegar en un alcance limitado, monitorizar indicadores clave y luego ampliar gradualmente si no aparecen señales de degradación.
Documenta los criterios de validación de un canary y las condiciones de rollback. Esto incluye resultados de tests sintéticos, tasas de error observadas y ausencia de alertas de comportamiento.
Planificar fases de validación: pre‑despliegue en entorno de prueba, canary en un pequeño alcance, despliegue progresivo con monitorización reforzada.
Definir criterios de parada: señales de alerta claras que desencadenen rollback o detención del rollout.
Preparar mecanismos de rollback simples y probados para volver a una versión estable si es necesario.
Checklist operacional antes y después de la puesta en producción
Aquí hay una lista de control destinada a preparar la puesta en producción y a estabilizar la explotación continua. Agrupa aspectos de monitoring, privacidad, tests y procedimientos humanos.
Esta checklist debe adaptarse al contexto del proyecto, a la arquitectura elegida y a las obligaciones regulatorias locales. Sirve como base para validar que el avatar está listo para operar 24/7.
Validar los SLO/SLA definidos y traducirlos en métricas observables.
Implementar tests sintéticos que cubran recorridos táctiles y vocales y verificar su ejecución automatizada.
Configurar la propagación de correlation ids y la separación metadatos/contenidos en los logs.
Definir la política de anonimización y retención de logs en conformidad con las decisiones RGPD del proyecto.
Crear dashboards operativos y configurar alertas accionables con runbook asociado.
Organizar el on‑call y realizar un ejercicio de incidente para validar procedimientos de diagnóstico y rollback.
Preguntas frecuentes (FAQ): aspectos prácticos
P: ¿Siempre hay que registrar el audio o la transcripción para diagnosticar un incidente? R: No necesariamente. Los metadatos, los códigos de estado y las transcripciones anonimizadas pueden ser suficientes para la mayoría de diagnósticos. La grabación completa debe conservarse solo si un análisis específico lo exige y tras validación de los aspectos jurídicos y de privacidad.
P: ¿SANIA proporciona métricas de observabilidad de forma nativa? R: Según la configuración del proyecto, SANIA puede integrarse con herramientas de monitoring y explotar documentos de negocio (PDF, DOCX, XLSX, TXT, CSV, o NDJSON para flujos específicos). Las métricas útiles deben exponerse o recopilarse vía los componentes desplegados y las integraciones elegidas.
P: ¿Cómo verificar la frescura de los contenidos RAG? R: Implementar consultas sintéticas dirigidas a documentos recientes y monitorizar las respuestas así como los logs RAG que indiquen qué fuentes se han solicitado, para alertar en caso de drift o ausencia de documentos actualizados.
Para profundizar
La puesta en marcha de un dispositivo de observabilidad completo para un avatar IA requiere colaboración estrecha entre producto, infraestructura, seguridad y explotación. Adapta este playbook al perímetro técnico y a las obligaciones del proyecto, y prioriza iteraciones cortas para estabilizar progresivamente los SLO.
SANIA puede explotarse en pantalla o kiosco interactivo con interacción táctil y/o vocal según la configuración, e integrar una base documental de negocio para escenarios RAG. Para estudiar la adaptación de este playbook a tu despliegue y recibir una demostración operativa, puedes solicitar una presentación de SANIA y de nuestros flujos de explotación.