Introducción: el reto operativo
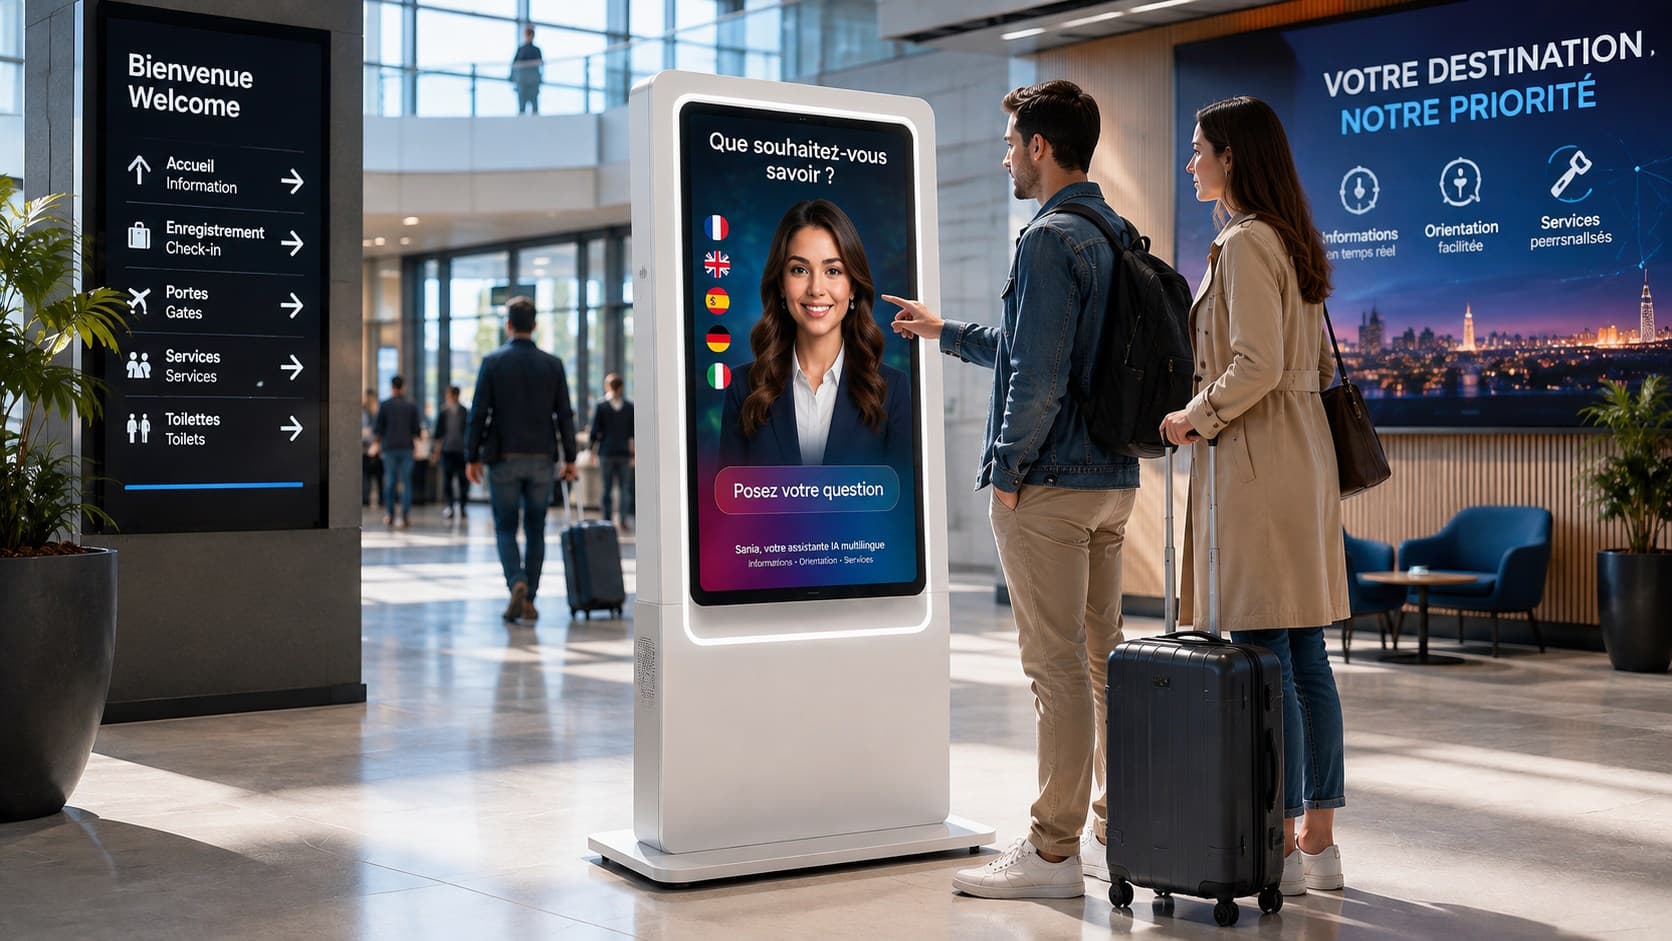
Desplegar un avatar IA de voz en un quiosco o pantalla en un espacio público plantea restricciones técnicas concretas: ruido ambiente variable, usuarios multilingües, disponibilidad 24/7 y requisitos de privacidad. Esta guía propone un enfoque operativo para tomar decisiones pragmáticas sobre la elección del ASR, el hardware de audio, el pipeline de preprocesado y las prácticas de validación y explotación.
El objetivo no es ofrecer una solución universal, sino exponer los compromisos a evaluar según el perfil del entorno y los objetivos de negocio, y entregar checklists y runbooks utilizables por jefes de proyecto, responsables de TI e integradores.
Por qué esta elección es crítica
La calidad del reconocimiento de voz condiciona la usabilidad de la interfaz vocal. En un entorno silencioso, la mayoría de los ASR modernos ofrecen un reconocimiento satisfactorio. En entornos ruidosos, la degradación proviene tanto de la acústica y la colocación del micrófono como de las limitaciones del motor ASR.
Las decisiones técnicas también tienen implicaciones no funcionales: latencia, privacidad de los flujos de audio, coste operativo y facilidad de mantenimiento. Es esencial abordar el diseño como una cadena de elementos dependientes: sensores de audio, procesamiento en edge, transporte hacia un servicio de reconocimiento y UX de fallback.
Matriz de decisión ASR: edge vs cloud
La primera elección estratégica es dónde ejecutar el motor ASR. El procesamiento en cloud suele ofrecer mejor rendimiento y actualizaciones de modelo más rápidas, mientras que una solución en edge reduce la latencia y limita el envío de audio a terceros. La elección correcta depende del perfil de ruido, las exigencias de privacidad y las restricciones de red.
En sitios con conectividad fiable y tolerancia en privacidad, el cloud facilita la gestión de idiomas y motores escalables. En ubicaciones con latencia crítica, ancho de banda limitado o requisitos de privacidad estrictos, el ASR en edge puede ser preferible con una configuración adaptada.
En la práctica, una arquitectura híbrida suele ser pertinente: preprocesado y detección de actividad vocal (VAD) local, con envío a un motor cloud o edge según la situación y las políticas de privacidad. La decisión técnica debe formalizarse en el pliego y los SLA de red.
Micrófonos y colocación: mono, arrays y montaje
La elección del sensor es tan determinante como el motor ASR. Los micrófonos direccionales simples pueden bastar en entornos tranquilos, mientras que los arrays permiten técnicas avanzadas de espacialización y beamforming que mejoran notablemente la relación señal‑ruido percibida por el ASR.
La colocación física influye en la captación: altura, distancia al usuario, obstáculos y superficies reflectantes son factores a considerar durante la instalación. El diseño del quiosco y la ergonomía táctil deben pensarse junto con la implantación del micrófono para evitar zonas muertas acústicas.
Considerar un array de micrófonos para sitios ruidosos para activar beamforming y cancelación de eco según el hardware.
Priorizar una colocación próxima a la zona de interacción, con marcado visual claro para incitar al usuario a hablar hacia el sensor.
Evitar ubicaciones próximas a fuentes de ruido recurrentes (caja, extractores, puertas automáticas).
Pipeline de preprocesado de audio: VAD, reducción de ruido y beamforming
Antes de llegar al ASR, la cadena de audio debe aplicar varias etapas de procesamiento para mejorar la calidad de la señal útil. La detección de actividad vocal (VAD) evita enviar ruido continuo al motor y permite controlar la latencia. La supresión adaptativa de ruido y los filtros de banda ayudan a estabilizar la señal.
El beamforming explota un array de micrófonos para favorecer la dirección de la voz del usuario y atenuar sonidos fuera de eje. Según el hardware, estos tratamientos pueden ejecutarse localmente (edge) o en cloud. Se recomienda diseñar la cadena para que los componentes críticos (VAD, cancelación de eco) sigan disponibles incluso ante pérdida de conectividad.
Wake word, VAD y gestión de activaciones accidentales
La combinación de wake word y VAD mejora la ergonomía: un wake word bien elegido permite la escucha activa sin captar permanentemente el flujo de audio. El wake word puede ejecutarse localmente por motivos de privacidad y reactividad, mientras que la detección de actividad vocal gestiona la apertura de la sesión.
Conviene prever comportamientos UX claros para evitar disparos accidentales en entornos ruidosos: feedback visual/sonoro breve al activarse, opción táctil de inicio vocal y posibilidad de silenciar el micrófono mediante un control visible o físico según el proyecto.
Detección de idioma y estrategia multilingüe
La detección automática de idioma facilita la bienvenida multilingüe, pero puede verse perturbada por el ruido y por enunciados cortos. Se recomiendan dos enfoques complementarios: ofrecer una elección explícita de idioma vía la interfaz táctil al inicio, y usar la detección automática como ayuda cuando la señal vocal sea lo bastante larga y estable.
En todo caso, priorizar una UX multimodal: mostrar los idiomas disponibles, permitir un cambio táctil rápido y garantizar que la base de conocimientos de negocio esté actualizada en los idiomas relevantes. SANIA puede comunicarse en más de 100 idiomas según la configuración, lo que facilita la implementación cuando la infraestructura ASR soporta los idiomas objetivo.
Fallback táctil y experiencia multimodal
Ningún sistema vocal es infalible en todas las circunstancias. Prever un fallback táctil o visual es imprescindible para mantener el acceso al servicio. Por ejemplo, si la confianza del ASR es baja o la detección de actividad falla de forma reiterada, la interfaz debe proponer claramente la opción táctil para continuar la tarea.
La UX debe hacer fluida la transición voz‑táctil: botones de sugerencia, menús contextuales y atajos pre‑rellenados reducen la carga cognitiva. La persona del avatar puede guiar al usuario hacia estas alternativas sin interrumpir la experiencia.
Protocolos de prueba en condiciones reales
Las pruebas en laboratorio no bastan: es necesario validar la cadena vocal in situ, en horas de afluencia real y con hablantes nativos de los idiomas objetivo. Construir conjuntos de escenarios representativos (preguntas tipo, acentos, duraciones de enunciado) y grabar las interacciones para análisis cualitativo y corrección de puntos débiles.
Las pruebas deben cubrir la resiliencia de la red, la latencia, las tasas de falsos disparos del wake word y situaciones de ruido súbito. Los resultados orientarán la calibración del pipeline de audio, la elección entre edge y cloud y los ajustes de sensibilidad del VAD.
Mantenimiento y runbook 24/7: checklist operacional
Una explotación fiable exige procedimientos de mantenimiento claros y accesibles para los equipos locales o proveedores. El runbook debe describir las verificaciones regulares, las acciones de emergencia y las operaciones de monitorización para asegurar disponibilidad continua.
Priorizar procedimientos simples y reproducibles, y prever medios de diagnóstico remoto según la configuración. La actualización de componentes software (drivers de audio, firmware del quiosco, módulos de preprocesado) debe planificarse y registrarse.
Inspección visual y limpieza de rejillas de micrófono y altavoces.
Verificación de conexiones de red y alimentación antes de intervenir en el ASR.
Control de logs locales y extracción periódica de trazas de audio cuando lo permita la política de privacidad.
Comprobación de versiones de software y aplicación controlada de parches.
Procedimiento de conmutación a modo táctil si persiste un incidente de audio.
Configuraciones tipo según nivel de ruido
Para facilitar la toma de decisión, aquí hay orientaciones prácticas por perfil acústico. Siguen siendo recomendaciones generales para adaptar al contexto.
Bajo ruido: una interfaz vocal con micrófono direccional y ASR en cloud es aceptable. El preprocesado puede ser mínimo y la UX puede favorecer la voz como entrada principal.
Ruido medio: un array de micrófonos con beamforming, VAD local y supresión de ruido adaptativa mejora la robustez. Una arquitectura híbrida (preprocesado local, ASR cloud o edge) suele ser pertinente.
Alta contaminación sonora: priorizar un sensor de calidad (array), procesamiento local avanzado, wake word en edge y una estrategia de fallback táctil sistemática. La privacidad también puede recomendar el tratamiento local de segmentos sensibles antes de cualquier envío.
FAQ breve
P: ¿Siempre hay que elegir un array de micrófonos para entornos ruidosos? R: Un array aporta ventajas técnicas (beamforming) pero implica un coste adicional de hardware e integración más estricta. Suele ser la solución más eficaz para entornos ruidosos, pero la decisión debe justificarse por el uso esperado y el presupuesto del proyecto.
P: ¿Cómo medir que el reconocimiento de voz es suficiente para aceptar un despliegue? R: Más allá de medidas técnicas, defina criterios de aceptación claros en su pliego y valide in situ con escenarios representativos. Estos criterios deberían incluir tasas de fallo perceptibles, latencia de interacción y la capacidad de los usuarios para alcanzar su objetivo mediante la voz o el fallback táctil.