Introducción: por qué un TCO preciso es imprescindible
Decidir un piloto o un despliegue multi‑sitio de un avatar IA en un kiosco interactivo exige una cifra creíble, aceptada por la dirección y la DSI. El coste no se limita a la compra del kiosco: cubre la infraestructura hardware, las licencias LLM, la síntesis y el reconocimiento de voz, la conectividad, la integración con sistemas de negocio, el mantenimiento 24/7 y la gobernanza del contenido.
Este artículo propone un método accionable para descomponer estas partidas, estimar el consumo de tokens y construir escenarios piloto / 10 / 100 sitios. El objetivo: ofrecer referencias concretas para redactar un presupuesto, negociar contratos y definir palancas de optimización.
Partidas de coste a tener en cuenta
Para elaborar un TCO completo, agrupe los gastos en CAPEX (inversiones iniciales) y OPEX (gastos recurrentes). Cada partida indicada más abajo debe aparecer en su hoja de cálculo presupuestaria.
Hardware e instalación (CAPEX): pantalla o kiosco interactivo, soporte físico, carcasa de audio, micrófonos y altavoces, posible protección física e instalación de red en sitio. Considere los costes de transporte e instalación física en cada ubicación.
Software y licencias (OPEX/CAPEX según contrato): licencia del software del avatar, costes de acceso a motores LLM (tarificación por tokens o suscripción), licencias TTS (síntesis de voz) y ASR (reconocimiento de voz) si se facturan por separado, licencias de SO o de la aplicación kiosco.
Integraciones y desarrollo (CAPEX / OPEX inicial): adaptación de la base de conocimiento, desarrollo de APIs para conectar POS, inventario o CRM, configuración del RAG y pruebas multilingües. Incluya la validación legal de contenidos cuando sea necesaria para respuestas sensibles del negocio. Estos costes cubren también pruebas UAT y ajustes de UX voz/táctil antes de la puesta en producción local o del piloto multi‑sitio.
Costes operativos recurrentes a presupuestar
Explotar un avatar IA implica costes recurrentes a menudo subestimados. Identifique y presupuestele claramente:
Costes LLM: facturación por token o por suscripción. El coste dependerá del volumen de peticiones, del tamaño medio de prompts y respuestas, y de la política tarifaria del proveedor. Según la configuración, se pueden orquestar varios motores LLM para equilibrar calidad y coste.
Costes de voz: TTS y ASR pueden facturarse por minutos, por número de peticiones o mediante suscripción. El reconocimiento de voz en entornos ruidosos puede aumentar el volumen de peticiones (retransmisiones, reintentos); hay que considerarlo.
Conectividad y datos: ancho de banda para llamadas a APIs, coste de conexiones redundantes para garantizar disponibilidad, posibles costes de almacenamiento y transferencia para embeddings si la solución guarda vectores en la nube o on‑premise según la configuración elegida para el RAG.
Método paso a paso para estimar el consumo LLM (fórmula operativa)
En lugar de inventar cifras, defina variables medibles y aplique una fórmula simple. Estos son los pasos y la fórmula a incorporar en su hoja de cálculo:
1. Medir o estimar el tráfico: interacciones medias por kiosco y por día, diferenciando interacciones táctiles y vocales. 2. Estimar el tamaño medio de una interacción en tokens: prompt del usuario + contexto enviado al LLM + respuesta generada. 3. Multiplicar tokens por interacción por el número de interacciones en el periodo deseado (mes/año). 4. Aplicar la tarifa del proveedor expresada por 1.000 tokens (u otra unidad).
Fórmula compacta a implementar: Coste LLM periódico = (interacciones/día x días) x (tokens medios por interacción / 1000) x (precio por 1000 tokens).
La misma lógica para TTS/ASR: estime el tiempo medio de audio generado o procesado por interacción y multiplique por la tarifa del proveedor (por minuto o por petición).
Construir escenarios: piloto, 10 sitios, 100 sitios (modelo de cálculo a adaptar)
En vez de publicar importes, estructure tres escenarios en su hoja de cálculo usando las mismas variables anteriores. Para cada escenario, detalle: número de unidades (kioscos), tráfico estimado por kiosco, exigencias multilingües (número de idiomas activados), si la voz está activada o no, arquitectura (edge, cloud, híbrida) y nivel de SLA esperado.
Los costes CAPEX se multiplican por el número de unidades para hardware e instalación, mientras que algunos costes OPEX pueden beneficiarse de economías de escala (por ejemplo, licencia central, alojamiento compartido, monitorización centralizada). Rellene columnas con: unidad, cantidad, precio unitario (proveedor), periodicidad, total periódico y total anualizado.
Incluya una columna dedicada a «costes de integración únicos» por sitio y otra para «costes de operación centralizados» (soporte, actualización de contenidos, alojamiento de embeddings). Prevea también una celda para imprevistos y un escenario de sensibilidad basado en variaciones de tráfico o subidas en el precio de los tokens.
Palancas concretas de optimización económica
Varias decisiones técnicas y operativas influyen fuertemente en el TCO. Estas son las palancas que puede probar o negociar:
Edge vs cloud: procesar algunas peticiones localmente reduce costes de llamadas a LLM y latencia, pero aumenta CAPEX y mantenimiento local. Un enfoque híbrido permite externalizar peticiones complejas y procesar en local las FAQs habituales.
Cache y pre‑generación: cachear respuestas frecuentes o pre‑generar contenidos estáticos disminuye el volumen de tokens solicitados al LLM.
Orquestación multi‑LLM: dirigir peticiones de bajo coste a modelos más económicos y reservar modelos premium para casos que requieren respuestas elaboradas.
TTS localizado: usar voces locales (edge TTS) para interacciones frecuentes puede reducir la factura TTS, siempre que se acepte el coste de hardware y mantenimiento.
Optimización de prompts y del RAG: estructurar la base de conocimiento para limitar la cantidad de contexto enviado al LLM. Un buen uso de búsqueda semántica puede reducir tokens innecesarios, pero implica coste de almacenamiento y actualización de embeddings según la configuración (on‑prem o cloud).
Cláusulas contractuales y SLA a negociar
Los contratos con proveedores LLM, TTS/ASR, editor del avatar o integrador deben cubrir puntos concretos para proteger su presupuesto y el nivel de servicio:
Tarificación y granularidad de unidades: precisar la unidad facturada (tokens, peticiones, minutos), tramos tarifarios y mecanismos de exceso.
SLA de disponibilidad y penalizaciones: definir el compromiso de disponibilidad para la API y las penalizaciones asociadas a indisponibilidades que afecten el servicio en kiosco.
Compromisos de rendimiento: latencia media esperada para las respuestas y para la TTS, y tiempo máximo aceptable en caso de degradación.
Soporte y horarios: nivel de soporte (horario laboral vs 24/7), tiempos de respuesta, proceso de escalado y contacto dedicado.
Seguridad y tratamiento de datos: obligaciones sobre conservación, supresión, localización de datos y condiciones de uso de contenidos de negocio suministrados (RAG, embeddings).
Cláusulas de salida y portabilidad: condiciones de rescisión, acceso a datos exportables y modalidades para recuperar la base de conocimiento en caso de cambio de proveedor.
Checklist de procurement y plantilla de cálculo a preparar antes del RFP
Antes de lanzar un RFP o negociación, prepare un dossier estructurado que contenga sus variables de negocio y requisitos técnicos:
Descripción de los usos prioritarios y volumen esperado por kiosco (interacciones voz / táctil), por periodo.
Lista de integraciones necesarias (POS, inventario, CRM) y requisitos de autenticación.
Exigencias multilingües y calidad de voces (TTS) esperada para cada idioma.
Nivel de disponibilidad deseado y ritmo de actualizaciones de la base de conocimiento.
Metodología de estimación de costes que espere del proveedor (comparta su hoja de variables para obtener comparativas homogéneas).
Puntos contractuales no negociables: SLA mínimo, seguridad de los datos y recuperación en caso de salida.
Preguntas frecuentes (FAQ) útiles para el comité de dirección
P: ¿Cómo justificar la diferencia entre un CAPEX importante y un OPEX reducido a largo plazo? R: Presente varios horizontes de comparación (coste total anualizado) y destaque los costes recurrentes principales (LLM, TTS, soporte). El comité debe comprender el punto de equilibrio y las palancas para moverlo.
P: ¿Conviene priorizar el edge para reducir la factura LLM? R: El edge reduce algunas llamadas a modelos de pago pero exige mayor inversión en hardware y mantenimiento local. Una estrategia híbrida suele ser la opción más pragmática: procesar localmente interacciones de bajo valor y delegar al cloud los casos complejos.
Para profundizar y próximos pasos
Para convertir esta guía en cifras concretas, descargue o cree una hoja de cálculo con las variables mencionadas e invite a sus proveedores a completar sus tarifas unitarias según sus usos estimados. Pruebe como mínimo un piloto en un sitio para medir tokens medios por interacción y ajustar los escenarios 10/100 sitios.
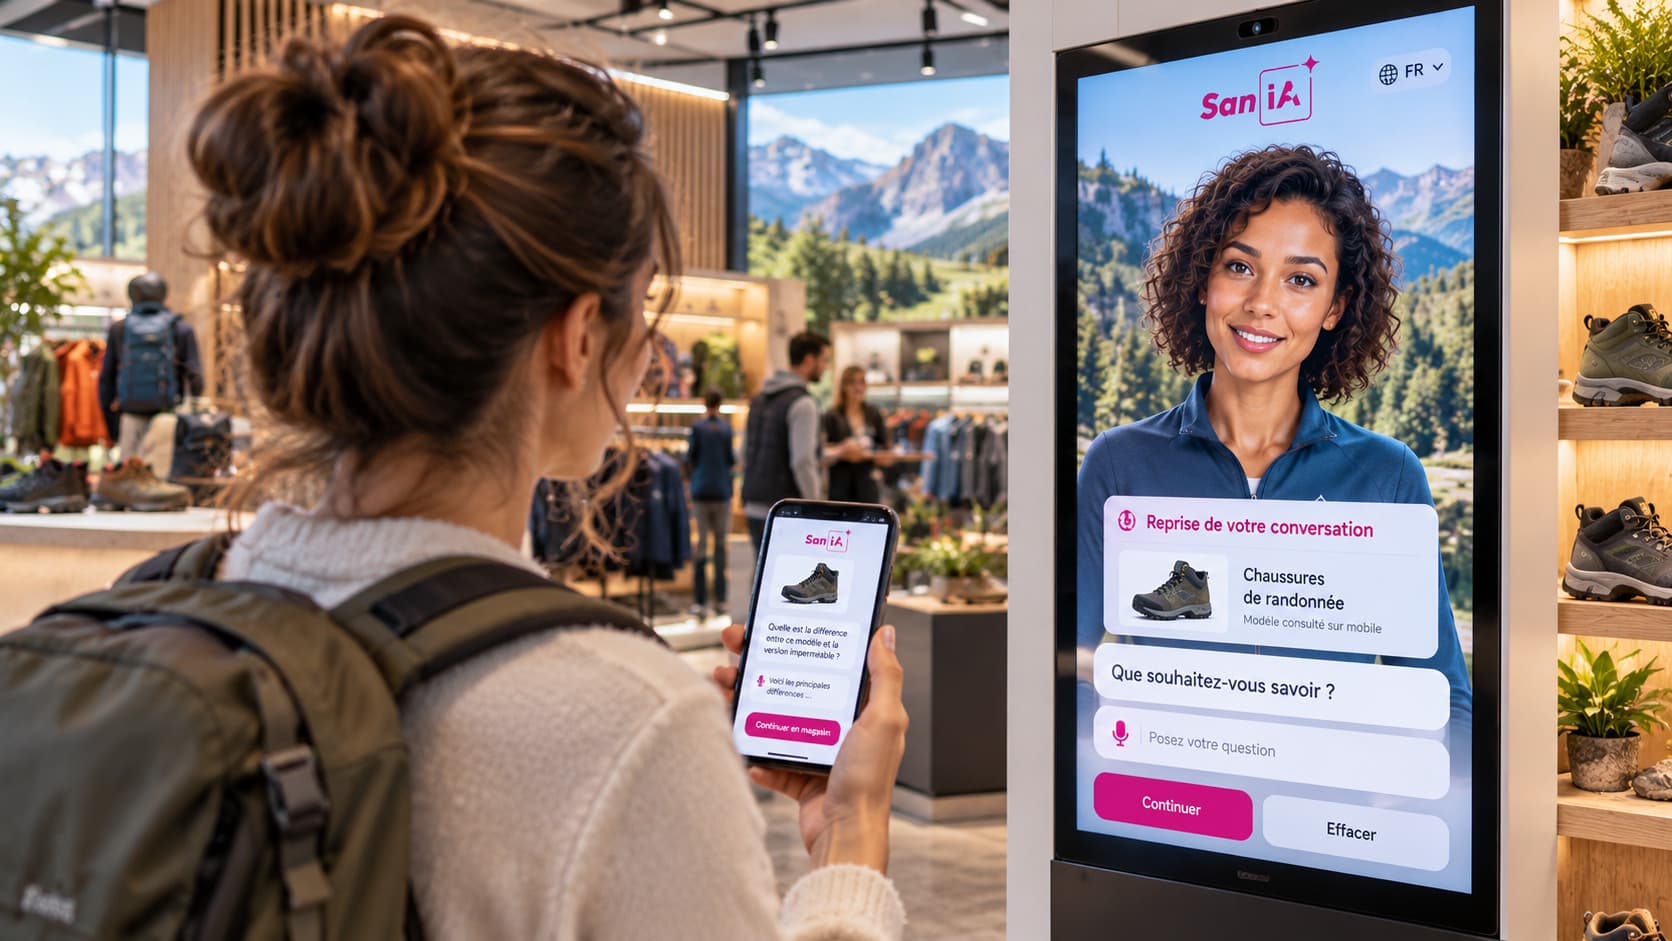
SANIA puede desplegarse en pantalla o kiosco interactivo, funcionar por voz y/o táctil y apoyarse en una base de conocimiento propia de la organización. Para estudiar con precisión cómo estas elecciones afectan su TCO en su contexto (arquitectura edge vs cloud, orquestación multi‑LLM, TTS/ASR), puede solicitar una demostración y un presupuesto adaptado a su red de sitios.