Korte inleiding: de juiste afweging hangt af van uw prioriteiten
De keuze tussen edge, cloud of een hybride architectuur voor de inzet van een AI‑avatar op een kiosk of scherm is geen technologische trend maar een afweging van reële beperkingen: spraakketenlatentie, bescherming van bedrijfsdocumenten die in zoekopdrachten gebruikt worden, exploitatiekosten voor meerdere locaties, 24/7‑beheer en toleranties voor netwerkstoringen. Deze gids biedt een pragmatisch besliskader, concrete architectuurpatronen die compatibel zijn met gebruikelijke OS‑ en SoC‑families (Samsung Tizen, Android, Windows afhankelijk van configuratie), scenario’s en een kant‑en‑klare pilot‑checklist.
Criteria‑matrix om architecturen te vergelijken
Voordat u kiest, positioneer uw prioriteiten in een eenvoudige matrix met de volgende dimensies: gebruikerslatentie (ASR, LLM, TTS), privacy en datalocatie (RAG en bedrijfsdocumenten), totale eigendomskosten over meerdere locaties, exploitability en 24/7‑onderhoud, schaalbaarheid en mogelijkheid om model‑ of contentupdates uit te rollen.
Voor elke dimensie bepaalt u of het een must, een acceptabel compromis of een secundaire prioriteit is. Als bijvoorbeeld realtime spraakontvangst zonder merkbare vertraging essentieel is, wordt latentie prioritair en werkt dat in het voordeel van een edge‑first of hybride aanpak met lokale spraakverwerking. Als vertrouwelijkheid van interne documenten voorop staat, geeft u de voorkeur aan het verwerken van embeddings en zoekopdrachten binnen een gecontroleerde infrastructuur (edge of private cloud, volgens beleid).
Drie operationele architectuurpatronen
1) Edge‑first: prioriteit voor lokale spraakverwerking en RAG. In dit patroon draaien ASR en TTS lokaal op de kiosk (of op een nabijgelegen lokale server) om de door gebruikers ervaren latentie te minimaliseren. Gevoelige documentzoekfuncties (creatie van embeddings en semantische zoekacties) worden lokaal of in een gecontroleerd netwerkomgeving gehost. Generatieve LLMs kunnen lokaal draaien als hardware en licenties dat toelaten, of voor complexere verzoeken in de cloud worden aangeroepen met een lokale filterpolicy.
2) Cloud‑first: centralisatie en schaalbaarheid. ASR, LLM, TTS en de RAG‑kennisbasis draaien in de cloud. Dit model vereenvoudigt onderhoud, maakt modelupdates makkelijker en ontlast de kiosken. Het kan echter extra latentie inbrengen en vraagt om robuuste netwerkgaranties en contractuele waarborgen voor de vertrouwelijkheid van data die naar de cloud gaan.
3) Hybride partitionering: pragmatische balans. De hybride aanpak verdeelt componenten naar gevoeligheid en verwachte latentie. Bijvoorbeeld ASR en audiopreprocessing op edge voor snelle spraakopname, embeddings en RAG lokaal of in een private cloud om bedrijfscontent te beschermen, en het generatieve LLM in de cloud om te profiteren van grotere capaciteit en frequente updates. Dit patroon maakt gedeeltelijke offline‑resilientie mogelijk: bij uitval van de cloud kan het avatar standaardgevallen blijven beantwoorden met lokaal aanwezige kennis.
Zakelijke scenario’s en praktische aanbevelingen
Retail in stedelijke gebieden: winkels met veel bezoekers willen vloeiende, meertalige interactie. Als spraak het hoofdgebruik is en latentie gevoelig is, kies dan voor een hybride patroon met ASR/TTS op edge en LLM in de cloud. Bescherm gevoelige commerciële content (productfiches, promoties) via RAG‑segmentatie en versleuteling.
Publieke ontvangst en administratie: vertrouwelijkheid van documenten is hier vaak leidend. Een edge‑first of hybride architectuur met lokale documentbeheer beperkt uitgaande data‑stromen en behoudt een acceptabele spraakervaring.
Evenementen en tijdelijke contexten: snelle uitrol, eenvoud van onderhoud en kosten spreken vaak voor een cloud‑first oplossing, eventueel gecombineerd met lokale caching om gecontroleerde degradatie bij netwerkverlies te waarborgen.
Gedistribueerde multizites: bij grootschalige, heterogene uitrols moet u rekening houden met lokale netwerkmogelijkheden, de diversiteit aan OS/SoC en data‑governance. Het hybride patroon vergemakkelijkt functionele uniformiteit en laat plaatselijke configuraties toe die bij de beperkingen van elke locatie passen.
Impact op RAG en embeddings: privacy, actualiteit en corpusgrootte
De locatie van de RAG‑service heeft directe gevolgen voor privacy en de mogelijkheid actuele antwoorden te garanderen. Het lokaal hosten van het embeddings‑index vermindert overdracht van gevoelige documenten, maar vergt gedistribueerde refresh‑ en onderhoudsprocessen. Embeddings in de cloud vergemakkelijken updates en industrialisatie, maar vereisen contractuele garanties en versleutelingsmaatregelen tijdens overdracht.
De strategie voor het actualiseren van embeddings moet operationeel worden vastgelegd: wie kan een update triggeren, welke menselijke validatie is nodig en hoe wordt teruggedraaid bij regressie. Deze regels staan los van de edge/cloud‑keuze, maar de uitvoering varieert afhankelijk van de gekozen architectuur.
Updates van LLM, TTS en ASR in productie: governance en uitrol
Het updaten van modellen en componenten vereist een helder workflow. Benoem rollen die verantwoordelijk zijn voor modelkeuze, kwaliteitscontroles en productie‑plaatsing. Voor cloud‑first componenten kunnen updates centraal en snel worden uitgerold. Voor edge‑deployments plan je distributie van binaries of containers naar kiosken, gefaseerde tests en een rollback‑mechanisme.
In hybride patronen verdient het de voorkeur blue/green of canary‑benaderingen te gebruiken om regressierisico’s in een heterogene omgeving te beperken. Documenteer welke tests voorafgaand aan uitrol nodig zijn: waargenomen latentie, ASR‑kwaliteit in doeltalen, TTS‑consistentie en de inhoudelijke juistheid van de gegenereerde antwoorden.
Runbook voor degradatie en strategieën voor graceful fallback
Anticipeer op netwerkstoringen of onbeschikbaarheid van cloud‑diensten met duidelijke degradatiegedragingen. Voorbeelden: bij verminderde LLM‑connectiviteit overschakelen naar voorgeconfigureerde antwoorden of een lokaal FAQ‑subset; als de ASR‑cloud niet bereikbaar is, een vereenvoudigd lokaal model gebruiken of aanraden om via touch te interacteren; als het RAG‑index niet bereikbaar is, de gebruiker informeren dat het avatar algemene antwoorden blijft geven en andere kanalen voor gevoelige vragen te adviseren.
Het runbook moet alarmsequenties voor de exploitatie, herstelchecks en de vereiste handmatige acties specificeren. Vermijd te beweren dat er automatisch wordt overgeschakeld naar een menselijke agent zonder de juiste integraties en processen: beschrijf liever wanneer het avatar de gebruiker naar personeel doorverwijst en hoe het team de opvolging uitvoert.
Operationele pilot‑checklist vóór industrialisatie
Voer vóór opschaling een gestructureerde pilot uit die de volgende punten dekt. De checklist houdt rekening met meertaligheid, doel‑OS/SoC en 24/7‑betrieb:
Prioriteiten op de matrix latentie/privacy/kosten/exploitability vastleggen.
Architectuurpattern kiezen (edge‑first, cloud‑first, hybride) en componentpartitionering (ASR, TTS, LLM, RAG) documenteren.
RAG‑pipeline valideren: herkomst van documenten, eventuele anonimisering, refresh‑frequentie van embeddings en rollback‑procedure.
Latentie‑ en ASR/TTS‑kwaliteitstests in doel‑talen onder realistische achtergrondgeluiden plannen.
Runbook voor degradatie en alarm‑playbooks voor 24/7‑operatie opzetten.
Updateproces voor modellen definiëren en testcriteria voorafgaand aan productie voor edge en cloud vastleggen.
Aanvullende operationele aspecten: kosten, onderhoud en OS/SoC
De totale eigendomskosten hangen sterk af van de parkgrootte en het gekozen patroon. Cloud‑first architecturen kunnen de lokale onderhoudscomplexiteit verkleinen maar terugkerende kosten genereren door modelaanroepen en gecentraliseerde opslag. Edge‑first‑oplossingen verhogen lokale hardware‑ en softwareonderhoudsbehoefte, maar kunnen operationele kosten door minder netwerkverkeer verlagen en de latentie verbeteren.
Controleer praktisch de compatibiliteit met de OS‑omgevingen en platforms die uw project ondersteunt. SANIA kan worden uitgerold op professionele Samsung‑schermen binnen het SoC/Tizen‑ecosysteem, via een Android‑app op bepaalde compatibele platforms of in aangepaste Windows‑omgevingen. Die keuze beïnvloedt het packaging van updates en operationele restricties.
Conclusie en praktische vervolgstappen
De juiste keuze hangt af van een combinatie van prioriteiten: als spraaklatentie en bescherming van documenten cruciaal zijn, kies dan voor edge‑first of een hybride aanpak met lokale verwerking van gevoelige stromen; waardeert u eenvoudige exploitatie en schaalbaarheid meer, dan kan cloud‑first passender zijn. In de meeste multisite‑gevallen biedt een hybride partitionering een praktisch evenwicht.
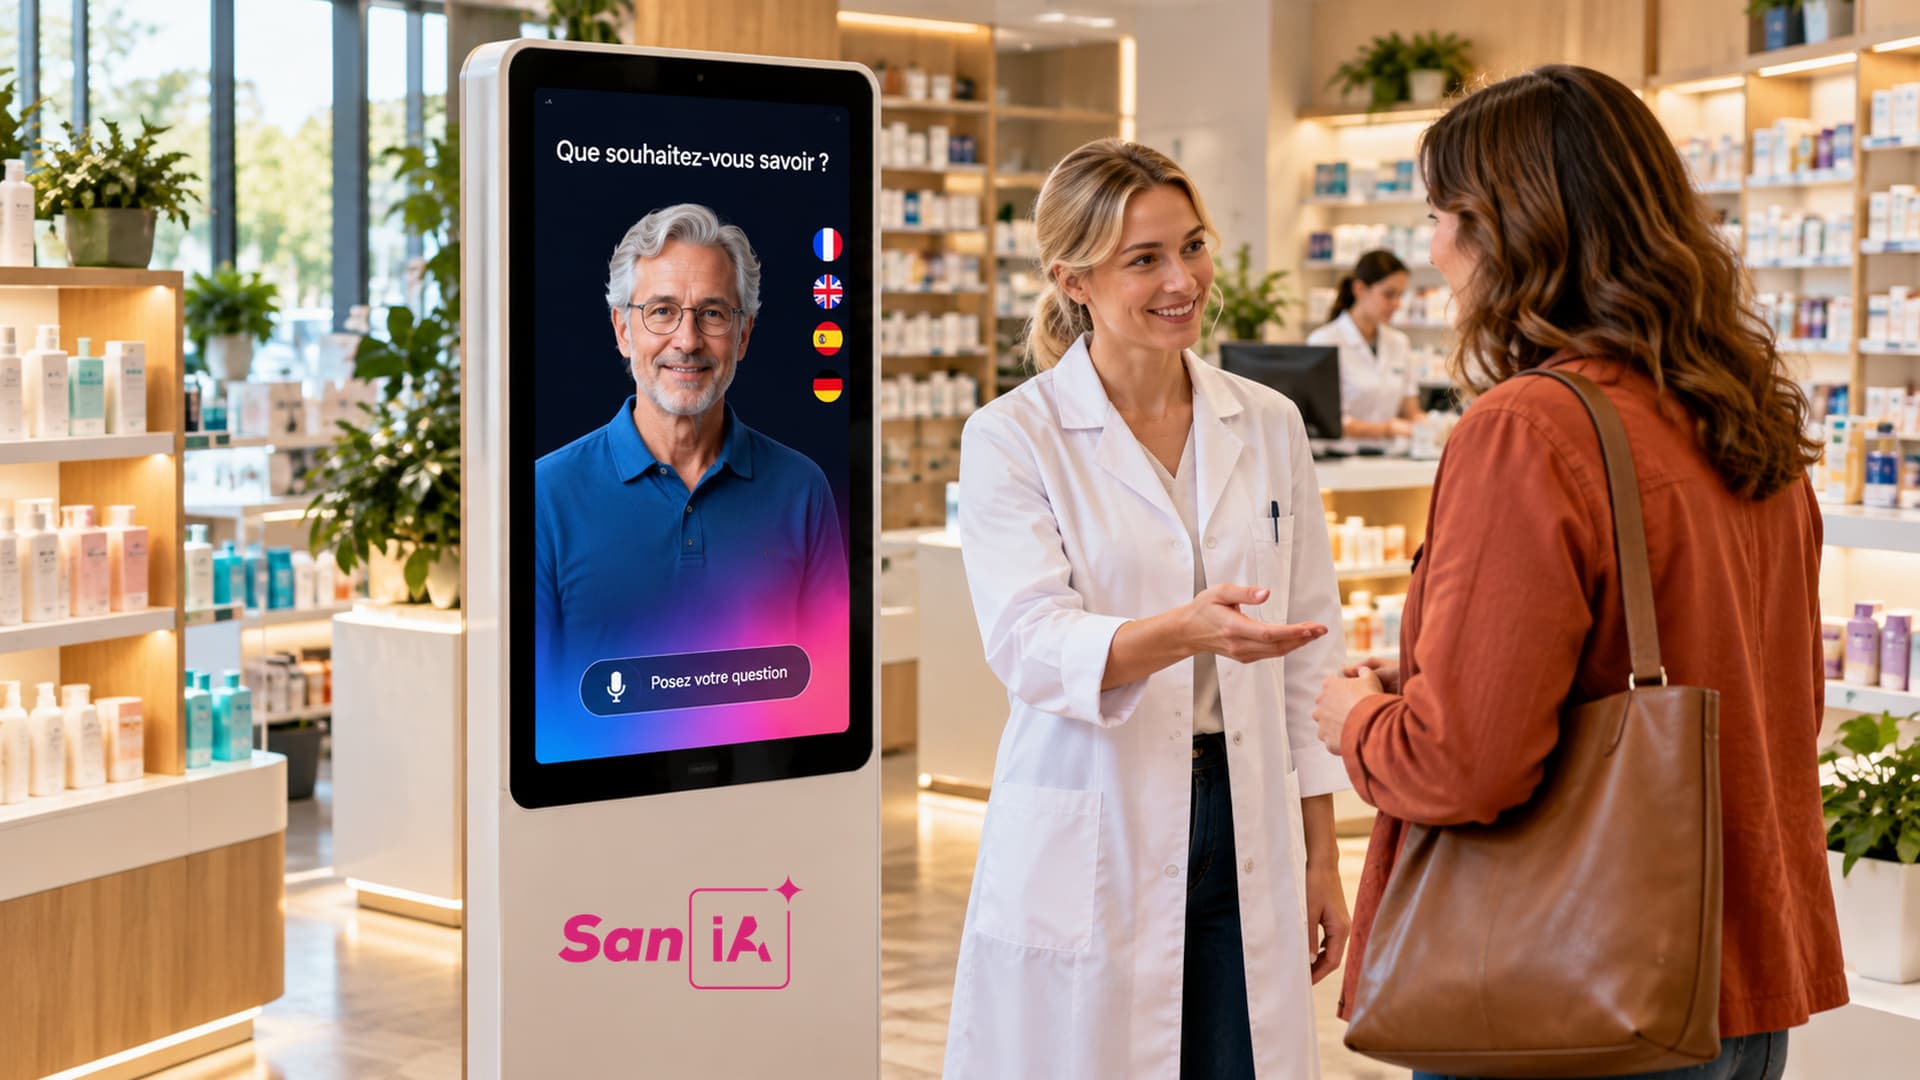
SANIA levert een professioneel conversatief AI‑avatar voor schermen of interactieve kiosken met spraak‑ en tactile interactie afhankelijk van configuratie, 24/7 beschikbaar en in staat om in meer dan 100 talen te communiceren. Vraag een demonstratie aan om de best passende architectuur voor uw park, de impact op RAG/embeddings en een op maat gemaakt pilotplan te verkennen.