
Introduction : pourquoi une observabilité pensée SRE pour un avatar IA physique
Een AI‑avatar die op een scherm of kiosk draait, opereert in een gedistribueerde omgeving met lokale componenten (touch‑UI, audio I/O, randapparatuur) en cloud‑ of on‑premise‑diensten (ASR, LLM, TTS, RAG, bedrijfsintegraties). Het garanderen van 24/7‑beschikbaarheid en het snel detecteren van degradaties vereist een observability‑benadering die is ontworpen voor exploitatie, niet alleen ontwikkeling.
Deze gids biedt een operationeel playbook om geschikte SLO’s en SLA’s te definiëren, end‑to‑end synthetische tests op te zetten die touch‑ en spraakpaden omvatten, privacy‑veilige en traceerbare logs te ontwerpen, actionabele dashboards en alerts in te richten en runbooks en on‑call te organiseren. De aanbevelingen zijn toepasbaar op een SANIA‑deployment op scherm of kiosk en houden rekening met hardware‑ en integratiespecificaties van het project.
Définir SLO et SLA pertinents avant toute supervision
SLO’s (Service Level Objectives) vertalen wat een acceptabele service is voor gebruikers en de organisatie naar meetbare criteria. SLA’s zijn contractuele of interne verplichtingen die op deze SLO’s steunen. Voor een AI‑avatar in een publieke omgeving is het belangrijk om SLO/SLA af te stemmen op businessverwachtingen en de werkelijke technische mogelijkheden.
In plaats van geïsoleerde technische metrics op te leggen, structureer de doelen rond de gebruikservaring: beschikbaarheid van spraak‑ en touch‑services op locatie, door de gebruiker waarneembare responstijd, vermogen om relevante antwoorden te geven via de documentatiebasis, en tolerantie voor degradaties van realtime‑integraties.
Breng kritische paden in kaart (bv. bezoekersbegeleiding, productinformatie, betaalscenario indien aanwezig) en bepaal welke componenten voor elk pad gemeten moeten worden.
Vertaal businessverwachtingen naar observeerbare meetpunten: beschikbaarheid, ervaren latentie, fallback‑percentage naar foutmelding of menselijke hulp, actualiteit van RAG‑content.
Documenteer externe afhankelijkheden (ASR, LLM, TTS, bedrijfs‑APIs) en geef aan welke serviceniveaus contractueel zijn en welke alleen operationeel worden gemonitord.
Concevoir des tests synthétiques end-to-end qui couvrent tactile et vocal
Synthetic monitoring maakt het mogelijk regressies te detecteren voordat ze veel gebruikers treffen. Voor een interactief kiosk moet een testplan touch‑flows, volledige spraakinteracties (ASR -> LLM -> TTS) en scenario’s omvatten die de RAG‑documentatiebasis of externe APIs aanspreken.
Synthetische tests kunnen vanuit de cloud, een on‑premise agent of vanaf apparaten op locatie worden uitgevoerd. Ze moeten de volledige interactieketen realistisch nabootsen en niet alleen technisch succes controleren, maar ook minimale functionele kwaliteit (bijv. niet‑lege respons, geen technische fout, acceptabele latentie) verifiëren.
Touch‑tests: welkomstflow, menu‑navigatie, schermovergangen, validatie van knoppen en visuele weergave.
End‑to‑end spraaktests: injectie van een audiobestand of gesimuleerde spraak, controle van ASR‑transcriptie, beoordeling van de door LLM/RAG gegenereerde respons, TTS‑weergave en check van de audio‑output.
Realtime integratietests: gesimuleerde oproepen naar bedrijfs‑APIs, controle van foutcodes en gedragingen bij onbeschikbaarheid (gecontroleerde degradatie).
RAG‑actualiteitstests: gerichte queries op recent bijgewerkte documenten om te verifiëren dat de teruggegeven documentbasis coherent is.
Concevoir des logs privacy-safe et traçables
Kwalitatieve logs zijn essentieel voor het diagnosticeren van incidenten. Tegelijkertijd moet de vertrouwelijkheid van gesprekken gewaarborgd en wettelijke verplichtingen nageleefd worden. Ontwerp logs die bruikbaar blijven voor SRE‑teams en tegelijkertijd persoonsgegevens minimaliseren.
Hanteer duidelijke principes: scheid operationele metadata van gebruikersinhoud, gebruik niet‑omkeerbare correlatie‑identifiers en pas anonimiserings‑ of pseudonimiseringsbeleid toe afhankelijk van het datatypes en de projectconfiguratie.
Neem systematisch een globale correlation id op voor een sessie (corrigeerbaar tussen lokale UI, ASR, LLM, TTS en API‑calls).
Log nuttige diagnose‑metadata: tijdstempels, latenties per stap, foutcodes, LLM‑modelversie, deployment‑ en machine‑IDs.
Voorkom het opslaan van volledige transcripties of ruwe audio zonder gerechtvaardigde operationele noodzaak. Als bewaring nodig is voor analyse, pas dan robuuste anonimiseringsmaatregelen toe en minimaliseer de retentieduur in overeenstemming met de AVG‑besluiten van het project.
Bewaar systeemactie‑traces en RAG‑verwerkingsstappen (welke documentbron is geraadpleegd) zonder gevoelige inhoud bloot te stellen.
Corrélation multi-composants pour diagnostiquer ASR, LLM, TTS et intégrations
Een ogenschijnlijk globaal incident kan van één component afkomstig zijn: een verslechterd ASR, een LLM met performanceproblemen, netwerklatentie naar een bedrijfs‑API of een lokaal probleem op de kiosk. Daarom is correlatie van traces tussen componenten onmisbaar om snel de oorzaak te isoleren.
Ontwerp log‑ en tracepipelines die een volledige sessie kunnen reconstrueren. Gebruik correlation ids die door elke call worden doorgegeven en bewaar metadata die het uitgevoerde pad en de latenties per stap aangeven.
Volg de gebruikersinvoer, de naar ASR verzonden aanvraag, de doorsturing naar LLM/RAG, de TTS‑aanvraag en de uiteindelijke weergave, met latentie en status voor elke stap.
Neem model‑ of configuratieversie‑IDs op (ASR model vX, LLM‑routing, RAG‑index) om rollbacks of regressieanalyse na deployments te vergemakkelijken.
Bewaar externe API‑request‑IDs en responsecodes om integratieincidenten te beoordelen zonder per se de payload op te slaan.
Dashboards et alerting actionnables pour les équipes Ops
Dashboards moeten een samenvatting van de service status bieden om snelle besluitvorming mogelijk te maken. Ze moeten actiegericht zijn en gekoppeld aan duidelijke alerts, ruis vermijden en helpen bij het prioriteren van incidenten.
Ontwerp gedifferentieerde alerts: die welke onmiddellijke interventie vereisen en die welke een geplande nadere analyse vragen. Documenteer het verwachte impactniveau voor elk type alert ter ondersteuning van on‑call.
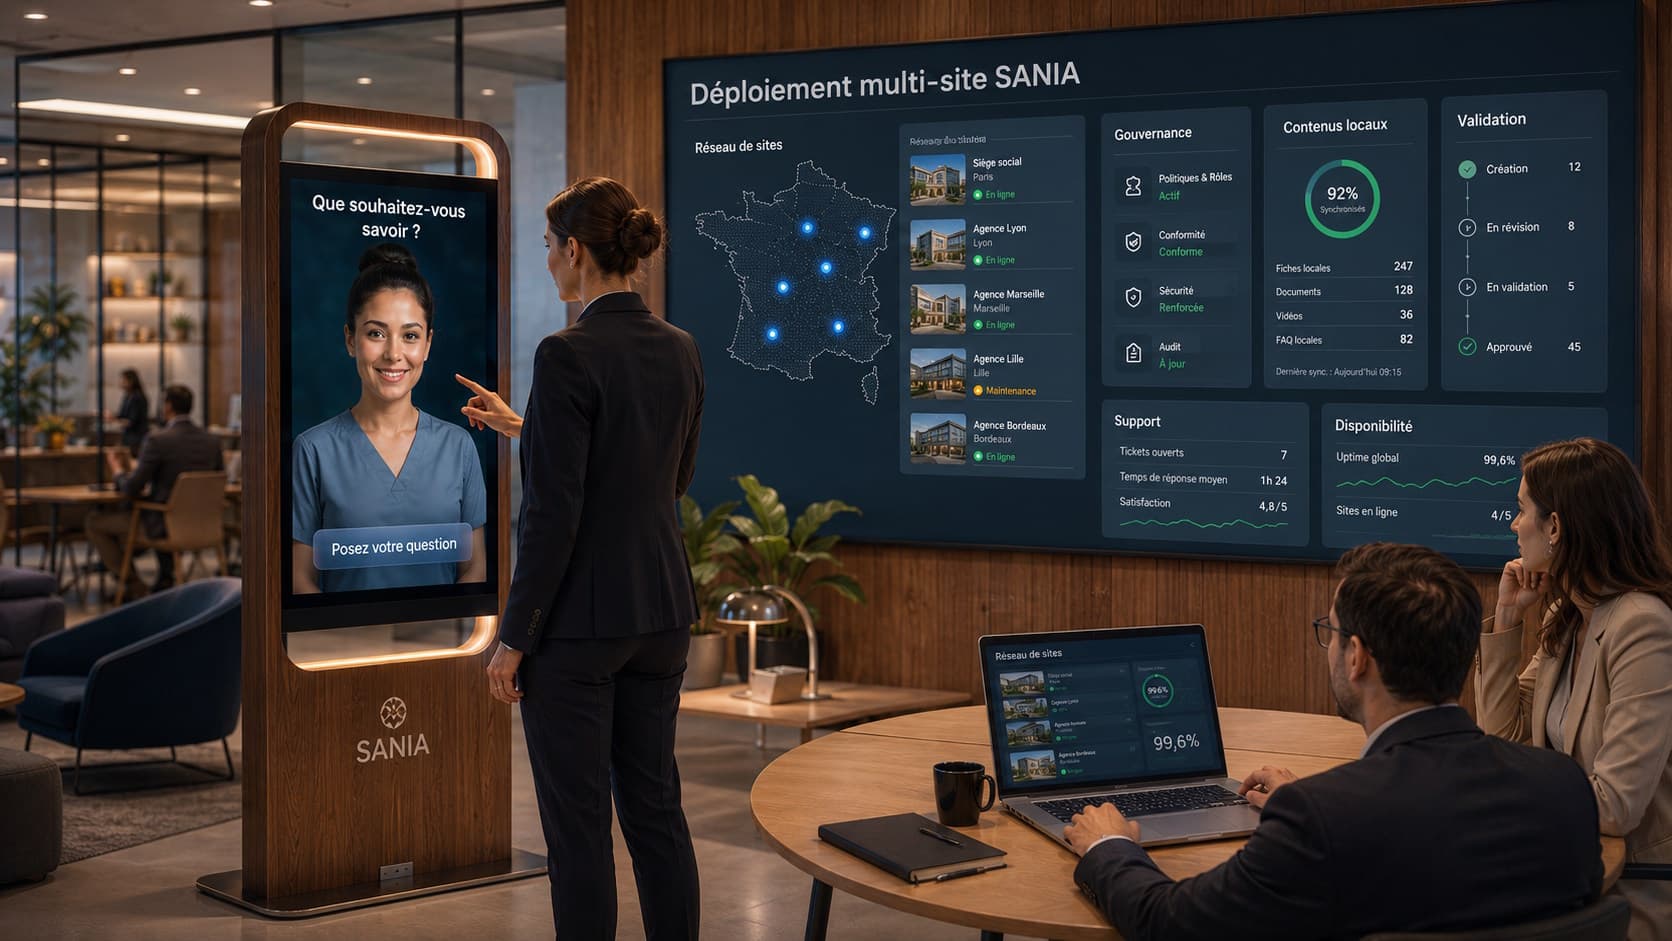
Voorbeelden van dashboardweergaven: kaart met locaties en kioskstatussen, gemiddelde latentie per component, geaggregeerde ASR/LLM/TTS‑fouttraces, functionele fallback‑rate.
Aanbevolen alerts: uitval van een kritieke dienst (ASR/LLM/TTS), aanhoudende stijging van integratiefouten, merkbare verslechtering van medialogentie, anomalieën in RAG‑actualiteit die op contentdrift wijzen.
Geef de voorkeur aan contextrijke alerts: gecorreleerde logs, getroffen stappen, laatste geslaagde/foutieve synthetische test en operationele suggesties uit het runbook.
Runbook, on-call et procédures d'escalade adaptées aux avatars IA
Een goed runbook is pragmatisch en symptoomgericht. Voor elk type alert of incident documenteert u snelle diagnostische stappen, controles ter plaatse en mogelijke mitigerende acties.
De on‑call organisatie moet duidelijke rollen voorzien: wie beheert de lokale infrastructuur, wie bevraagt de clouddiensten, wie beheert de bedrijfsintegraties. Vertrouw niet op ongedefinieerde automatische overdrachten; documenteer contactpunten en communicatiewijzen.
Structuur van een incident‑runbook: symptoomomschrijving, eerste controles, te raadplegen consoles/commando’s, methode voor log‑correlatie, tijdelijke mitigaties, criteria voor terugval en escalatie.
Neem procedures op voor snelle tests op locatie (gecontroleerde herstart, netwerkoverschakeling, controle van audio/touch‑hardware) en scripts voor het extraheren van gecorreleerde logs.
Plan regelmatige oefeningen om runbooks te valideren en de reactietijd van teams op peil te houden.
Stratégies de déploiement et pattern canary pour limiter les risques
Deployments van kritieke componenten (nieuw LLM‑model, ASR‑update, verandering in RAG‑pipeline) moeten het risico minimaliseren dat de volledige vloot wordt beïnvloed. Canary‑deployment is een bruikbaar patroon: deploy naar een beperkt bereik, monitor kernindicatoren en rol geleidelijk uit als geen degradatie optreedt.
Documenteer de validatiecriteria voor een canary en de rollback‑voorwaarden. Dit omvat resultaten van synthetische tests, waargenomen foutpercentages en het ontbreken van gedragsalerts.
Plan validatiefasen: pre‑deployment in testomgeving, canary op klein bereik, geleidelijke uitrol met versterkt monitoring.
Definieer stopcriteria: duidelijke alarmtekens die rollback of stoppen van de rollout triggeren.
Bereid eenvoudige, geteste rollback‑mechanismen voor om indien nodig naar een stabiele versie terug te keren.
Checklist opérationnelle avant et après mise en production
Hieronder een operationele checklist om de go‑live voor te bereiden en de continue exploitatiestabiliteit te waarborgen. Deze verzamelt aspecten van monitoring, privacy, tests en menselijke procedures.
Pas deze checklist aan op de projectcontext, de gekozen architectuur en lokale regelgevingsvereisten. Ze dient als basis om te verifiëren dat de avatar klaar is voor 24/7‑operatie.
Valideer SLO/SLA en vertaal deze naar observeerbare metrics.
Zet synthetische tests op die touch‑ en spraakpaden dekken en verifieer hun geautomatiseerde uitvoering.
Configureer propagatie van correlation ids en scheiding van metadata/inhoud in logs.
Bepaal het anonimiserings‑ en retentiebeleid voor logs in overeenstemming met de AVG‑besluiten van het project.
Creëer operationele dashboards en configureer actionabele alerts met bijbehorend runbook.
Organiseer on‑call en voer een incident‑oefening uit om diagnose‑ en rollbackprocedures te valideren.
Questions fréquentes (FAQ) : aspects pratiques
Q : Moet men altijd audio of transcriptie opnemen om een incident te diagnosticeren? A : Niet per se. Metadata, statuscodes en geanonimiseerde transcripties volstaan voor de meeste diagnoses. Volledige opname mag alleen worden bewaard als een specifieke analyse dit vereist en na goedkeuring van juridische en privacyaspecten.
Q : Levert SANIA van zichzelf observability‑metrics? A : Afhankelijk van de projectconfiguratie kan SANIA worden geïntegreerd met monitoringtools en bedrijfsdocumenten (PDF, DOCX, XLSX, TXT, CSV of NDJSON voor specifieke workflows) gebruiken. Nuttige metrics moeten worden geëxposeerd of verzameld via de inzetcomponenten en gekozen integraties.
Q : Hoe controleert u de actualiteit van RAG‑inhoud? A : Implementeer gerichte synthetische queries op recent bijgewerkte documenten en monitor zowel de antwoorden als de RAG‑logs die aangeven welke bronnen zijn geraadpleegd, om bij drift of ontbrekende actuele documenten te waarschuwen.
Pour aller plus loin
Het opzetten van een volledige observability‑oplossing voor een AI‑avatar vraagt nauwe samenwerking tussen product, infrastructuur, security en exploitatie. Pas dit playbook aan op de technische scope en projectverplichtingen en geef prioriteit aan korte iteraties om SLO’s geleidelijk te stabiliseren.
SANIA kan ingezet worden op scherm of interactief kiosk met touch‑ en/of spraakinteractie en kan een bedrijfsdocumentatiebasis voor RAG‑scenario’s integreren. Om de aanpassing van dit playbook aan uw deployment te bespreken en een operationele demo te ontvangen, kunt u een presentatie van SANIA en onze exploitatie‑workflows aanvragen.