Introductie: waarom een specifiek UAT‑protocol voor avatar‑AI in de winkel
Een pilot met een avatar‑AI op een kiosk of scherm moet onder reële omstandigheden aantonen dat de ervaring de zakelijke doelstellingen haalt: ontvangst, informatie, oriëntatie en begeleiding. Een gestructureerd gebruikers‑ en acceptatieprotocol (UAT) voorkomt misleidende conclusies uit geïsoleerde technische tests en zorgt ervoor dat de avatar werkt met echte spraak‑ en touchinteracties, in meerdere talen en met de bedrijfsdocumentatie.
Dit document biedt een direct inzetbaar protocol: doeldefinitie, standaard testscenario's, methode voor meertalige werving, observeerbare scripts, kwalitatieve en kwantitatieve indicatoren om te volgen, technische checklists en operationele go/no‑go criteria. Relevante SANIA‑elementen worden duidelijk aangegeven waar ze tijdens de pilot gecontroleerd moeten worden.
Definieer de zakelijke doelstellingen en de reikwijdte van de pilot
Formuleer vóór elke test de concrete doelstellingen van de pilot. Deze moeten gekoppeld zijn aan concrete gebruiksscenario's: productinformatie, oriëntatie in de winkel, antwoord op veelgestelde vragen, meertalige toegang of begeleiding naar een dienst. Elk doel vertaalt zich in geprioriteerde use‑cases die als basis voor de testscenario's dienen.
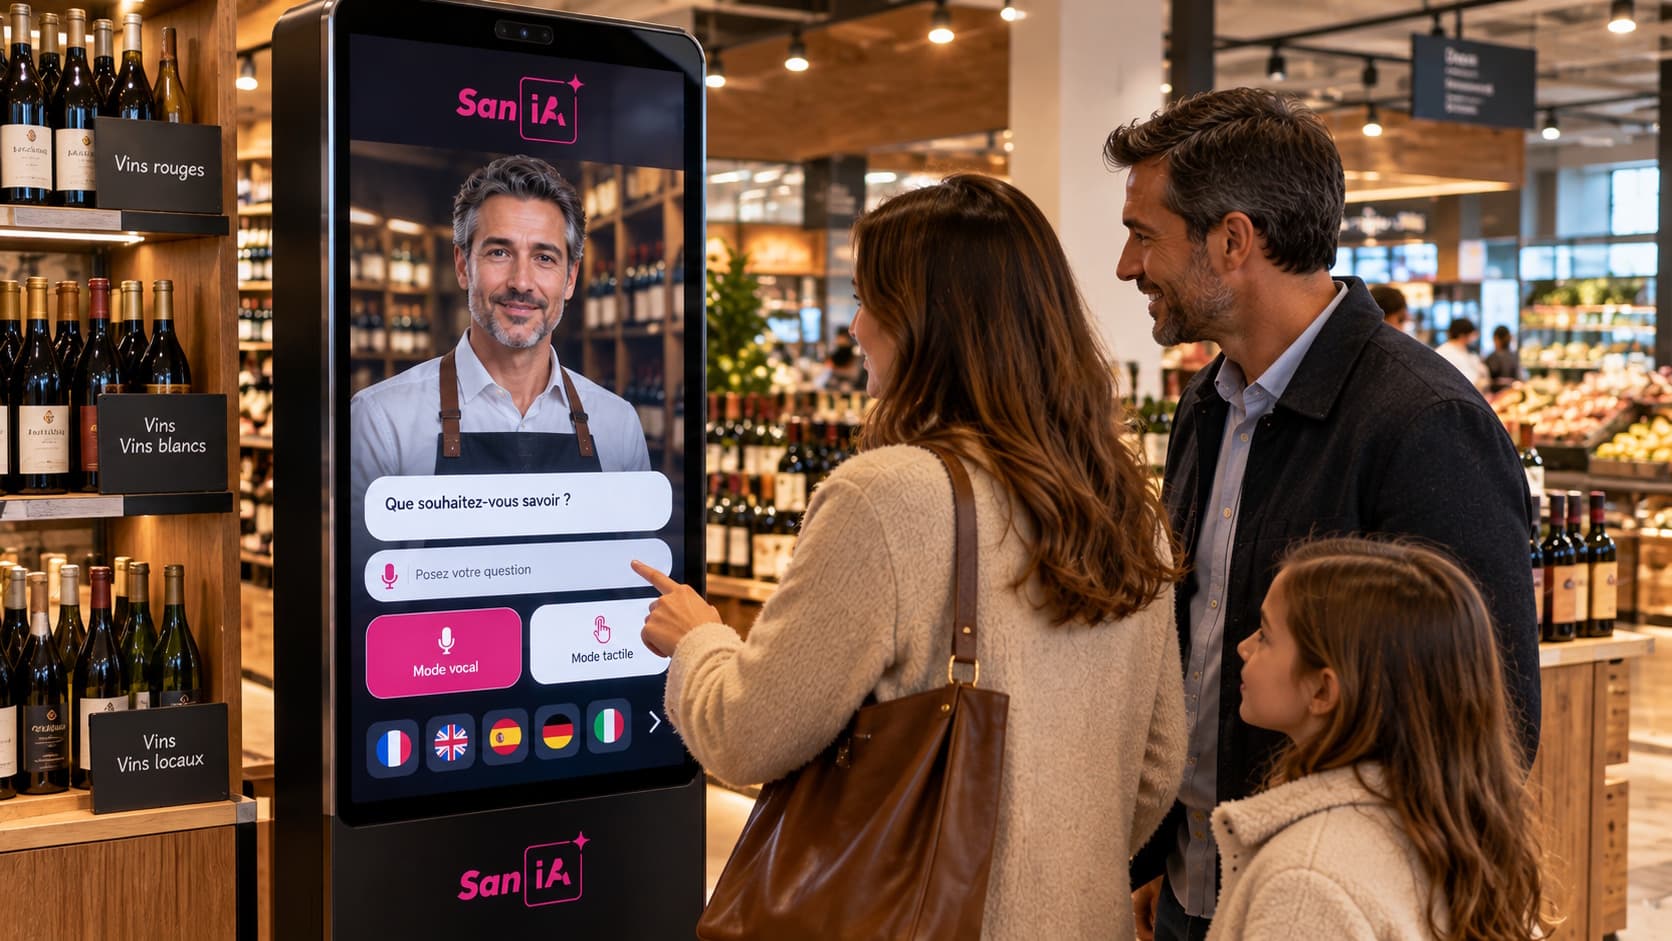
Specificeer de technische en operationele reikwijdte: ingeschakelde interactiemodi (spraak, touch of beide), te dekken talen, eventueel beschikbare integraties (voorraad, openingstijden, dynamische displays), omgevingsbeperkingen (lawaai, verlichting, looproutes). Belangrijk onderscheid: wat is een native capaciteit van de avatar en wat vereist een specifieke integratie.
Typische gebruikersscenario's: spraak, touch en meertaligheid
Stel een set scenario's op die de meest voorkomende paden en foutsituaties dekken. Elk scenario moet het gebruikersdoel, de context, vereisten (taal, beschikbaarheid van een integratie), het gebruikersscript en de uitkomstcriteria bevatten. Varieer de scenario's naar: puur spraakinteractie, alleen touch, gemengde touch‑dan‑spraak flows en het wisselen van taal tijdens een sessie.
Voorbeelden van zakelijke cases: productinformatie opvragen, een afdeling of een op voorraad zijnd product vinden, openingstijden en services opvragen, een eenvoudige regelgevende of veiligheidsvraag, en verzoeken die moeten doorverwijzen naar personeel. Voor meertalige tests neem zowel moedertaalsprekers als niet‑moedertaalsprekers op om de robuustheid van ASR en de formulering van antwoorden te evalueren.
Observeerbare testscripts en observatieraster
Elke testsessie moet worden uitgevoerd met een precies script en een raster dat door de tester in realtime wordt ingevuld. Het raster documenteert de volgende objectieve elementen: initiatie (tijd tot het begin van de interactie), ASR‑begrip (heeft de avatar de vraag correct getranscribeerd?), relevantie van het antwoord, vocale helderheid en volume van TTS, touch‑ergonomie (menu's, labels), waargenomen latency, noodzaak tot escalatie en door de gebruiker gerapporteerde tevredenheid.
Vul deze observaties aan met kwalitatieve aantekeningen over intonatie, terugkerende verwarringen en onvoorziene gebruikersuitingen. Het doel is bruikbare sporen te genereren om de kennisbank te corrigeren, prompts en microcopy aan te passen of ASR/TTS‑parameters te verbeteren.
Velden in het observatieraster: test‑ID, scenario, taal, modus (spraak/touch), waargenomen ASR‑transcriptie, gegeven antwoord, duur van de interactie, menselijke interventie nodig, status succes/fout, opmerkingen.
Werving van deelnemers en steekproefomvang
De werving moet representativiteit van echte bezoekers nastreven: demografische profielen, vertrouwdheid met de tool, gesproken talen en gebruiksvoorkeuren (touch of spraak). Geef prioriteit aan diversiteit boven puur volume om problematische gebruikssituaties en taalkundige of culturele vooringenomenheid te signaleren.
In plaats van een vast aantal op te leggen, organiseer de tests in iteraties tot het punt van kwalitatieve verzadiging: wanneer dezelfde terugkerende problemen naar voren komen en weinig nieuwe observaties worden toegevoegd, kan de initiële testfase als dekkend worden beschouwd. Dit principe vermijdt een willekeurige drempel en past zich aan de bezoekersfrequentie en complexiteit van de geteste scope aan.
Testuitvoering in de winkel: logistiek en best practices
Plan sessies in representatieve drukke tijden. Bereid de omgeving voor: duidelijke aanduiding dat het een test is, instructies voor vertrouwelijkheid en toestemmingen als opnames worden gemaakt. Herinner eraan dat de verwerking van persoonsgegevens moet voldoen aan de toepasselijke wetgeving en dat de SANIA‑configuratie afhangt van de door de organisatie gekozen bewaarbeleidopties.
Beperk tijdens de sessie de interventies van de tester om gedrag niet te vertekenen. Leg geanonimiseerde voorbeelden van interacties vast indien de pilotconfiguratie dit toestaat en er toestemming is gegeven. Gebruik het observatieraster om objectieve metingen en directe kwalitatieve feedback te verzamelen.
KPI's en go/no‑go criteria: wat te meten en hoe beslissen
Selecteer een beperkte set kwantitatieve en kwalitatieve indicatoren die aansluiten bij de zakelijke doelen. Voorbeelden van nuttige dimensies: door testers waargenomen oplossingspercentage, escalatiepercentage naar menselijke tussenkomst volgens observatie, ASR‑begripskwaliteit in de geteste talen, gemiddelde waargenomen latency en direct gemelde gebruikerstevredenheid. Specificeer de methoden voor verzameling: observatieraster, aparte korte enquête na de interactie of externe instrumentatie afhankelijk van beschikbare integraties.
Voor go/no‑go criteria kiest u bij voorkeur leesbare operationele regels: als kernzakelijke verzoeken niet betrouwbaar worden opgelost in de prioritaire talen, als ASR onder reële omstandigheden systematisch faalt, of als de touch‑interface de toegang tot essentiële functies belemmert, kan de pilot niet worden goedgekeurd voor de volgende fase. Vermijd universele numerieke drempels zonder context: deze criteria moeten worden aangepast aan de ambitie en de kritikaliteit van het project.
Technische checklist om tijdens de pilot te valideren
Valideer tijdens de UAT de technische elementen die de ervaring beïnvloeden. Controleer met name de robuustheid van ASR in de geactiveerde talen, de kwaliteit en verstaanbaarheid van TTS, de relevantie van antwoorden uit de RAG‑documentatie, fallback‑gedrag wanneer de documentatie onvoldoende is, en de waargenomen latency bij LLM‑aanroepen of realtime integraties.
Voor SANIA controleert u tijdens de pilot: de mogelijkheid om te schakelen tussen spraak en tekst volgens configuratie, behoud van conversatiecontext binnen een sessie, geconfigureerde meertaligheid en passendheid van de door de organisatie geleverde kennisbase. Specifieke integraties met externe systemen moeten als aparte ontwikkelingen worden behandeld en getest.
Korte checklist: ASR (tests in reële omstandigheden per taal), TTS (verstaanbaarheid, volume), RAG (relevantie en geciteerde bronnen), fout‑ en fallbackbeheer, latency van LLM‑aanroepen, kritische integraties getest, 24/7‑beschikbaarheid gesimuleerd.
Escalatieproces en omgaan met storingen in productie
Definieer vooraf de situaties waarin de avatar de gebruiker moet vragen contact op te nemen met personeel. De pilot moet deze gevallen documenteren om onderbroken ervaringen te voorkomen: gevoelige reglementaire vragen, veiligheidsproblemen, verzoeken die toegang tot beveiligde systemen nodig hebben, of aanhoudende onbegrip na meerdere pogingen.
Ga niet uit van een automatisch overdrachtsmechanisme: voorzie standaardberichten, hoe de avatar de gebruiker informeert en de aanbevelingslogica naar een menselijke gesprekspartner. Het playbook 'Overschakelen naar een menselijke agent vanaf een avatar‑AI' kan als referentie dienen om deze operationele regels te formaliseren.
Exporteerbare templates: scenario's, observatieraster en acceptatierapport
Om de uitvoering te vergemakkelijken, volgen hier sjablonen die u in een spreadsheet of een verzamelttool kunt reproduceren:
Scenario‑template: ID | Naam scenario | Doel | Taal | Modus (spraak/touch) | Voorwaarde | Gebruikersscript | Verwacht gedrag van de avatar | Succes/Fail criterium | Opmerkingen.
Observatieraster‑template: Test‑ID | Scenario | Deelnemer (profiel) | Taal | Start interactie | ASR‑transcriptie | Gegeven antwoord | Duur | Menselijke interventie | Status | Gedetailleerde opmerkingen.
Acceptatierapport‑template: Pilotcontext | Geteste scope | Samenvatting kwalitatieve resultaten | Samenvatting technische resultaten | Blocking punten | Vereiste verbeteringen | Lijst prioritaire acties | Operationele aanbeveling (Go / Go met voorbehoud / No‑Go).
SANIA‑specifieke aandachtspunten voor de pilot
Controleer bij de SANIA‑mogelijkheden tijdens de pilot: de geconfigureerde meertalige communicatie voor relevante talen, spraak‑ en touchinteractie volgens de gekozen configuratie, vermogen om context tijdens een sessie te behouden en het gebruik van de door uw organisatie geleverde kennisbasis. Deze onderdelen zijn native of configureerbare componenten waarvan de kwaliteit onder reële omstandigheden geverifieerd moet worden.
Als uw project specifieke integraties bevat (voorraad, openingstijden, POS), behandel deze dan als aparte ontwikkeltrajecten en test ze dienovereenkomstig. Evenzo is het gebruik van gepersonaliseerde stemmen of voice‑cloning alleen mogelijk als rechten en configuratie worden aangeleverd en moet dit tijdens de pilot gevalideerd worden.
Korte FAQ
Hoe meet je tevredenheid zonder native instrumentatie? Een organisatie kan directe tevredenheid verzamelen via een korte aparte enquête na de interactie of via het observatieraster dat door een tester wordt ingevuld. Deze methoden moeten vóór de pilot worden vastgesteld.
Moet de volledige documentatie worden vertaald naar elke taal? Nee. SANIA kan, wanneer geconfigureerd, in meer dan 100 talen communiceren. Prioriteit moet liggen bij kernzakelijke informatie en de kwaliteit daarvan in de talen die relevant zijn voor uw publiek. De lokalisatiestrategie hangt af van uw doelen en middelen.