Introductie: waarom een nauwkeurige TCO onmisbaar is
Besluiten over een pilot of een multi‑locatie uitrol van een AI‑avatar op een interactieve kiosk vereist een geloofwaardig cijfer dat door directie en IT wordt geaccepteerd. De kosten beperken zich niet tot de aanschaf van de kiosk: ze omvatten hardware‑infrastructuur, LLM‑licenties, spraaksynthese en spraakherkenning, connectiviteit, integratie met bedrijfssystemen, 24/7 exploitatie en content‑governance.
Dit artikel biedt een direct toepasbare methode om deze posten te ontleden, het tokenverbruik te schatten en scenario’s voor pilot / 10 / 100 locaties op te bouwen. Doel: concrete handvatten geven voor budgettering, contractonderhandelingen en het bepalen van optimalisatiehefbomen.
De kostenposten die u moet meenemen
Voor een volledige TCO groepeert u uitgaven in CAPEX (initiële investeringen) en OPEX (lopende kosten). Elke onderstaande post moet in uw budgetspreadsheet voorkomen.
Hardware en installatie (CAPEX): scherm of interactieve kiosk, fysieke bevestiging, audio‑behuizing, geschikte microfoons en luidsprekers, eventuele fysieke bescherming en netwerkinstallatie op locatie. Denk aan transport‑ en installatiekosten per locatie.
Software en licenties (OPEX/CAPEX afhankelijk van contract): licentie voor de avatar‑software, toegangskosten tot LLM‑engines (token‑tarief of abonnement), TTS‑ en ASR‑licenties indien apart gefactureerd, OS‑ of kiosk‑applicatielicenties.
Integraties en ontwikkeling (CAPEX / initiële OPEX): aanpassing van de kennisbank, API‑ontwikkeling voor koppeling met POS, voorraad of CRM, configuratie van RAG en meertalige tests. Neem waar nodig juridische validatie van content op voor gevoelige zakelijke antwoorden. Deze posten omvatten ook UAT‑tests en UX‑aanpassingen (spraak/touch) vóór lokale productie of pilot‑uitrol.
Terugkerende operationele kosten die u moet budgetteren
Het exploiteren van een AI‑avatar brengt vaak onderschatte terugkerende kosten met zich mee. Identificeer en begroet duidelijk:
LLM‑kosten: facturatie per token of via abonnement. De kosten hangen af van het aantal verzoeken, de gemiddelde grootte van prompts en antwoorden en het prijsbeleid van de leverancier. Afhankelijk van de configuratie kunnen meerdere LLM’s worden ingezet om kwaliteit en kosten te balanceren.
Spraak‑kosten: TTS en ASR kunnen per minuut, per verzoek of via een abonnement worden gefactureerd. Spraakherkenning in lawaaiige omgevingen kan het aantal verzoeken (hertransmissies, retries) vergroten; houd hier rekening mee.
Connectiviteit en data: bandbreedte voor API‑calls, kosten van redundante verbindingen voor beschikbaarheid, eventueel opslag‑ en transferkosten voor embeddings als de oplossing vectoren opslaat in de cloud of on‑premise, afhankelijk van de gekozen RAG‑configuratie.
Stap‑voor‑stap methode om LLM‑verbruik te schatten (operationele formule)
In plaats van cijfers te verzinnen, definieer meetbare variabelen en pas een eenvoudige formule toe. Volg deze stappen en formule in uw spreadsheet:
1. Meet of schat verkeer: gemiddeld aantal interacties per kiosk per dag, onderscheid makend tussen touch‑ en spraakinteracties. 2. Schat gemiddelde token‑grootte per interactie: gebruikersprompt + context naar het LLM + gegenereerd antwoord. 3. Vermenigvuldig tokens per interactie met het aantal interacties over de gewenste periode (maand/jaar). 4. Pas de leverancierstarief toe, uitgedrukt per 1.000 tokens (of andere eenheid).
Samenvattende formule voor implementatie: LLM‑kosten (periode) = (interacties/dag x dagen) x (gem. tokens per interactie / 1000) x (prijs per 1000 tokens).
Zelfde logica voor TTS/ASR: schat de gemiddelde audio‑duur per interactie en vermenigvuldig met het leverancierstarief (per minuut of per verzoek).
Scenario’s opbouwen: pilot, 10 locaties, 100 locaties (aanpasbaar rekenmodel)
In plaats van bedragen te noemen, structureert u drie scenario’s in uw spreadsheet met dezelfde variabelen als hierboven. Voor elk scenario vult u in: aantal units (kiosken), geschat verkeer per kiosk, meertaligheidsvereisten (aantal talen), of spraak actief is, architectuur (edge, cloud, hybride) en verwacht SLA‑niveau.
CAPEX‑kosten schalen lineair met het aantal units voor hardware en installatie, terwijl sommige OPEX‑posten schaalvoordelen kunnen hebben (bijv. centrale licenties, gedeelde hosting, gecentraliseerde monitoring). Vul kolommen voor: unit, hoeveelheid, eenheidsprijs (leverancier), periodiciteit, periodetotaal en geannualiseerd totaal.
Voeg een kolom toe voor “unieke integratiekosten” per locatie en een andere voor “gecentraliseerde run‑kosten” (support, content‑updates, hosting van embeddings). Voorzie ook een cel voor onvoorzien en een sensitiviteitsscenario bij wijzigingen in verkeer of stijgende tokentarieven.
Concrete optimalisatiehefbomen
Verschillende technische en operationele keuzes hebben grote invloed op de TCO. Hieronder staan hefbomen die u kunt testen of bedingen:
Edge versus cloud: lokaal bepaalde verzoeken verwerken vermindert LLM‑calls en latency, maar verhoogt CAPEX en lokaal onderhoud. Een hybride aanpak kan complexe verzoeken naar de cloud delegeren en veelvoorkomende FAQ’s lokaal afhandelen.
Cache en pre‑generatie: veelvoorkomende antwoorden cachen of statische content vooraf genereren vermindert het tokenvolume naar het LLM.
Multi‑LLM‑orchestration: eenvoudige verzoeken naar economisch gunstigere modellen routeren en premiummodellen reserveren voor complexe gevallen.
Gelokaliseerde TTS: voor frequente interacties kan het gebruik van lokale stemmen (edge‑TTS) de TTS‑kosten verlagen, mits de hardware‑ en onderhoudskosten worden gedragen.
Prompt‑ en RAG‑optimalisatie: structureer de kennisbank om de hoeveelheid context naar het LLM te beperken. Een goed beheerde semantische zoeklaag kan onnodige tokens reduceren, maar brengt opslag‑ en actualiseringskosten voor embeddings met zich mee (on‑prem of cloud afhankelijk).
Contractclausules en SLA’s om te onderhandelen
Contracten met LLM‑leveranciers, TTS/ASR‑leveranciers, avatar‑uitgever of integrator moeten specifieke punten dekken om uw budget en serviceniveau te beveiligen:
Prijzen en facturatie‑granulariteit: specificeer de gefactureerde eenheid (tokens, verzoeken, minuten), tariefschalen en overage‑mechanismen.
Beschikbaarheids‑SLA en boetes: definieer het beschikbaarheidscommitment voor de API en eventuele boetes bij storingen die de kioskservice beïnvloeden.
Prestatiebeloftes: verwachte gemiddelde latency voor antwoorden en TTS, en maximaal aanvaardbare tijden bij degradatie.
Support en uren: supportniveau (kantoortijden vs 24/7), responstijden, escalatieproces en vaste contactpersoon.
Beveiliging en gegevensverwerking: verplichtingen rond opslag, verwijdering, datalocatie en gebruiksvoorwaarden voor aangeleverde bedrijfscontent (RAG, embeddings).
Exit‑ en portabiliteitsclausules: beëindigingsvoorwaarden, toegang tot exporteerbare data en modaliteiten om de kennisbank over te nemen bij leverancierwisseling.
Inkoopchecklist en rekenmodeltemplates ter voorbereiding op RfP
Voordat u een RfP start of in onderhandeling treedt, stelt u een gestructureerd dossier samen met uw businessvariabelen en technische eisen:
Beschrijving van prioritaire use cases en verwacht volume per kiosk (spraak / touch), uitgesplitst per periode.
Lijst van benodigde integraties (POS, voorraad, CRM) en authenticatievereisten.
Meertaligheidsvereisten en gewenste kwaliteit van stemmen (TTS) per taal.
Gewenst beschikbaarheidsniveau en frequentie van updates van de kennisbank.
Methodologie voor kostenraming die u van de leverancier verwacht (deel uw variabelenspreadsheet om uniforme vergelijkingen te krijgen).
Niet‑onderhandelbare contractpunten: minimum‑SLA, dataveiligheid en recovery‑modaliteiten bij exit.
Veelgestelde vragen (FAQ) nuttig voor het stuurgroep
V: Hoe rechtvaardigt u het verschil tussen hoge CAPEX en lagere OPEX op lange termijn? A: Toon meerdere tijdshorizonten (geannualiseerde totale kost) en benadruk de belangrijkste terugkerende kosten (LLM, TTS, support). De stuurgroep moet het break‑even punt en de beïnvloedingshefbomen begrijpen.
V: Moet men Edge verkiezen om LLM‑kosten te reduceren? A: Edge vermindert bepaalde betaalde modelaanroepen maar vereist hogere hardwareinvesteringen en lokaal onderhoud. Een hybride strategie is vaak het meest pragmatisch: lokale afhandeling van laagwaardige interacties en cloud voor complexe gevallen.
Verdere stappen en volgende actie
Om deze gids naar concrete cijfers te vertalen, download of maak een spreadsheet met de genoemde variabelen en nodig uw leveranciers uit hun eenheidsprijzen in te vullen op basis van uw geschatte usage. Test minimaal één pilotlocatie om gemiddelde tokens per interactie te meten en pas de 10/100‑scenario’s aan.
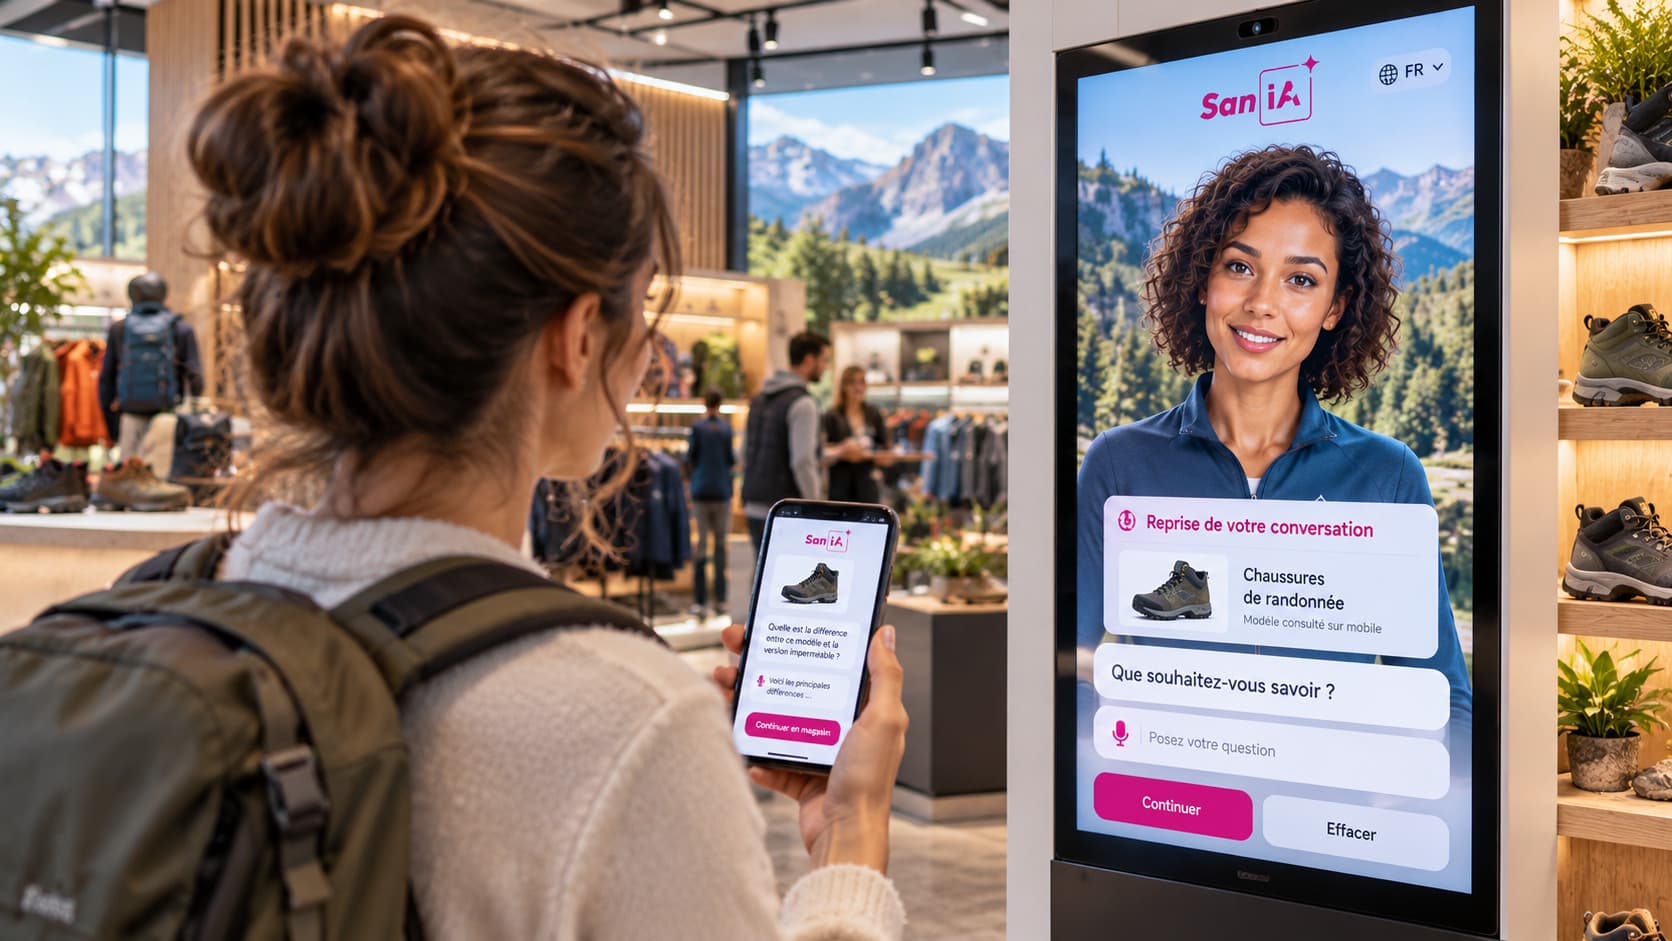
SANIA kan worden uitgerold op scherm of interactieve kiosk, werken via spraak en/of touch en steunen op een organisatie‑specifieke kennisbasis. Om precies te onderzoeken hoe deze keuzes uw TCO beïnvloeden in uw context (Edge vs Cloud, Multi‑LLM‑orchestratie, TTS/ASR), kunt u een demonstratie en een op uw netwerk afgestemde prijsopgave aanvragen.