Introdução rápida: o bom compromisso depende das suas prioridades
A escolha entre edge, cloud ou uma arquitetura híbrida para implementar um avatar IA num quiosque ou ecrã não é uma moda tecnológica, mas uma arbitragem entre restrições reais: latência da cadeia de voz, proteção dos documentos métier usados em pesquisa documental, custo operacional multi‑site, capacidades de manutenção 24/7 e tolerância a falhas de rede. Este guia propõe um quadro decisório pragmático, padrões arquiteturais concretos compatíveis com famílias de OS e SoC comuns (Samsung Tizen, Android, Windows conforme configuração), cenários métier e uma checklist piloto pronta a usar.
Matriz de critérios para comparar arquiteturas
Antes de decidir, posicione as suas prioridades numa matriz simples que agrupa as seguintes dimensões: latência para o utilizador (ASR, LLM, TTS), privacidade e localização dos dados (RAG e documentos métier), custo total de propriedade multi‑site, operacionalidade e manutenção 24/7, escalabilidade e capacidade de distribuir atualizações de modelos ou conteúdos.
Para cada dimensão, identifique se é um imperativo, um compromisso aceitável ou uma prioridade secundária para a sua organização. Por exemplo, se a receção vocal em tempo real e sem atraso perceptível for imperativa, a latência torna‑se prioritária e favorece uma arquitetura edge‑first ou híbrida com processamento vocal local. Se a confidencialidade de documentos internos for determinante, prefira processar embeddings e pesquisa documental numa infraestrutura controlada (edge ou cloud privada conforme políticas).
Três padrões arquiteturais operacionais
1) Edge‑first: prioridade para processamento vocal e RAG local. Neste padrão, ASR e TTS podem correr localmente no quiosque (ou num servidor local próximo) para minimizar a latência percebida pelo utilizador. A pesquisa documental sensível (criação de embeddings e busca semântica) é hospedada localmente ou num perímetro de rede controlado. Os LLMs de geração podem ser hospedados localmente se o hardware e as licenças permitirem, ou chamados na cloud para pedidos mais complexos aplicando uma política de filtragem local.
2) Cloud‑first: centralização e escalabilidade. A cloud aloja ASR, LLM, TTS e a base de conhecimento RAG. Este modelo simplifica a manutenção, facilita atualizações de modelos e reduz a carga nos quiosques. Contudo, pode introduzir latência adicional e exige garantias robustas de rede e proteções contratuais sobre a confidencialidade dos dados em trânsito para serviços cloud.
3) Híbrido particionado: equilíbrio pragmático. A abordagem híbrida distribui componentes segundo sensibilidade e latência esperada. Exemplo: ASR e pré‑processamento de áudio no edge para captar a fala rapidamente, embeddings e pesquisa RAG no edge ou numa cloud privada para proteger conteúdos métier, e o LLM de geração na cloud para beneficiar de maiores capacidades e atualizações frequentes. Este padrão facilita resiliência offline parcial: quando o acesso à cloud está indisponível, o avatar pode continuar a responder casos comuns a partir do conhecimento local.
Cenários métier e recomendações práticas
Retail em zona urbana: lojas com grande afluência procuram interação fluida e multilingue. Se o uso principal for vocal em loja e a latência for sensível, privilegie um padrão híbrido com ASR/TTS no edge e LLM na cloud. Proteja conteúdos comerciais sensíveis (fichas de produto, promoções) por segmentação RAG e encriptação.
Receção pública e administração: a confidencialidade dos documentos costuma ser prioritária. Uma arquitetura edge‑first ou híbrida com gestão documental local permite limitar fluxos de saída mantendo uma experiência vocal aceitável.
Eventos e contextos temporários: a rápida implantação, simplicidade de manutenção e custo podem favorecer uma solução cloud‑first, eventualmente combinada com cache local para assegurar degradação controlada em caso de perda de rede.
Multi‑sites distribuídos: se pretende implementar num parque heterogéneo e alargado, considere capacidades de rede locais, variedade de OS/SoC e governança dos dados. O padrão híbrido facilita uniformização funcional e autoriza configurações locais adaptadas às restrições de cada site.
Impactos no RAG e embeddings: privacidade, frescura e tamanho do corpus
A localização do serviço RAG tem impacto direto na privacidade e na capacidade de garantir respostas atualizadas. Hospedar o índice de embeddings localmente reduz transferências de documentos sensíveis, mas impõe processos de refresh e manutenção distribuída. Colocar os embeddings na cloud simplifica atualizações e industrialização, mas exige garantias contratuais e medidas de cifragem durante as transferências.
A estratégia de atualização dos embeddings deve ser pensada operacionalmente: defina quem pode desencadear uma atualização, que validação humana é necessária e como reverter para uma versão anterior se for detetada uma regressão. Estas regras são independentes da escolha edge/cloud, mas a sua implementação operacional varia conforme a arquitetura escolhida.
Atualizações de LLM, TTS e ASR em produção: governação e deploy
A atualização de modelos e componentes exige um workflow claro. Identifique os papéis responsáveis pela escolha do modelo, testes de qualidade e colocação em produção. Para componentes cloud‑first, as atualizações podem ser centralizadas e desdobradas rapidamente. Para o edge, preveja um processo de distribuição de binários ou contentores para os quiosques, testes progressivos e um mecanismo de rollback.
Numa arquitetura híbrida, privilegie abordagens blue/green ou canary para limitar o risco de regressão num parque heterogéneo. Documente os testes a realizar antes do deploy: latência percebida, qualidade do ASR nas línguas alvo, coerência do TTS e adequação das respostas geradas à base métier.
Runbook de degradação e estratégias de graceful fallback
Antecipe falhas de rede ou indisponibilidades cloud definindo comportamentos de degradação claros. Regras operacionais exemplo: quando a ligação ao serviço LLM estiver degradada, mudar para respostas predefinidas ou para um subconjunto local de FAQ; quando o ASR cloud não for acessível, usar um modelo local simplificado ou propor interação tátil; se o índice RAG não estiver disponível, indicar ao utilizador que o avatar continua a fornecer respostas gerais e sugerir outros canais para pedidos sensíveis.
O runbook deve especificar as sequências de alerta para a operação, verificações de recuperação e ações humanas a executar. É importante não alegar um encaminhamento automático para um agente humano sem integrações e processos adequados: preveja antes os casos em que o avatar encaminhará o utilizador para a equipa e descreva como a equipa fará o seguimento.
Checklist piloto operacional antes da industrialização
Antes de alargar o despliegue, valide um piloto estruturado que cubra os seguintes pontos. Esta checklist tem em conta restrições multilingues, OS e SoC alvo e exploração 24/7:
Definir prioridades na matriz latência/privacidade/custo/exploitabilidade.
Escolher o padrão arquitetural (edge‑first, cloud‑first, híbrido) e documentar o particionamento dos componentes (ASR, TTS, LLM, RAG).
Validar o pipeline RAG: proveniência dos documentos, eventual anonimização, frequência de refresh dos embeddings e procedimento de rollback.
Planear testes de latência e qualidade ASR/TTS nas línguas alvo em condições reais de ruído.
Implementar o runbook de degradação e playbooks de alerta para exploração 24/7.
Definir o processo de atualização dos modelos e critérios de teste antes da produção para edge e cloud.
Aspectos operacionais complementares: custo, manutenção e OS/SoC
O custo total de posse depende fortemente do tamanho do parque e do padrão escolhido. Arquiteturas cloud‑first podem reduzir a complexidade de manutenção local, mas gerar custos recorrentes associados a chamadas de modelos e armazenamento centralizado. Arquiteturas edge‑first aumentam a manutenção de hardware e software no local, mas podem reduzir custos operacionais relacionados com tráfego e melhorar a latência.
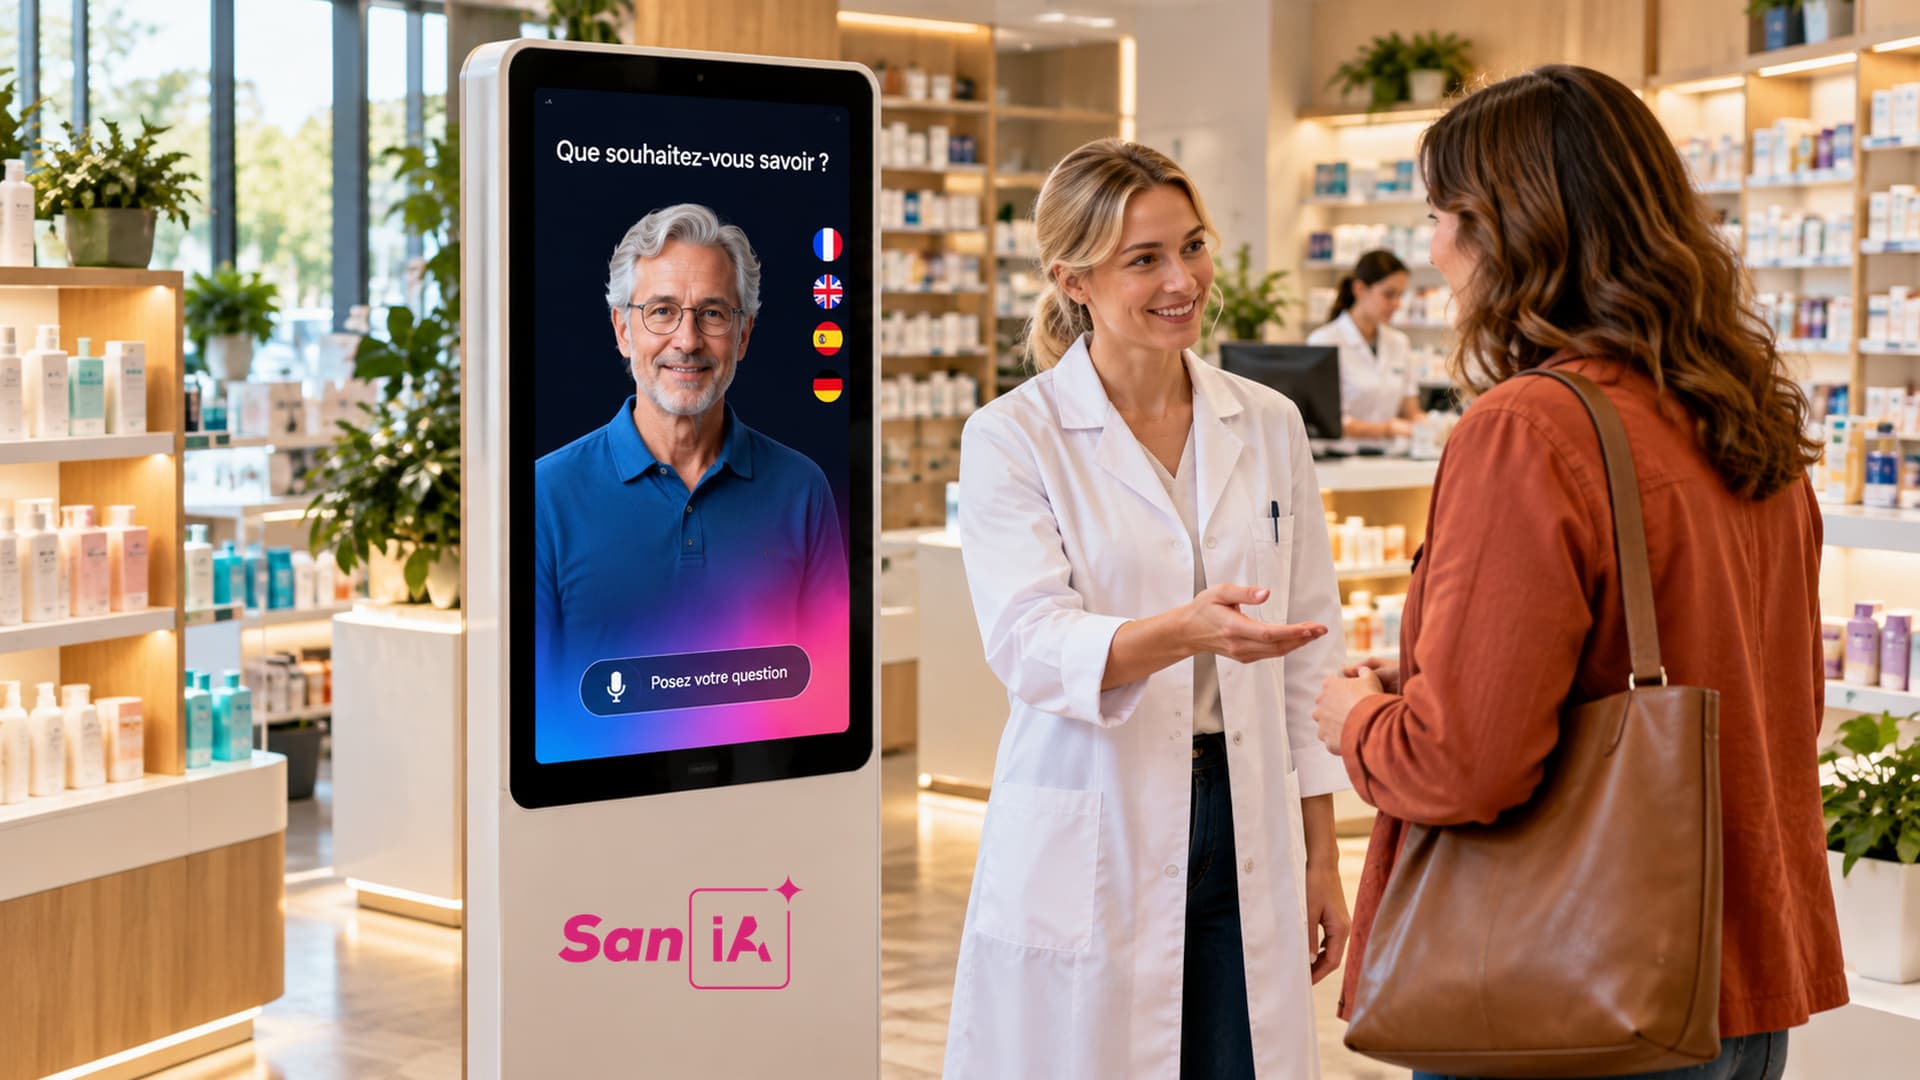
Na prática, verifique a compatibilidade com os OS e ambientes suportados pelo seu projeto. A SANIA pode ser implantada em ecrãs profissionais Samsung no seu ambiente SoC/Tizen, através de uma aplicação Android em plataformas compatíveis ou em ambientes Windows adaptados. A escolha influencia o packaging das atualizações e as restrições de operação.
Conclusão e próximos passos práticos
A escolha correta depende de uma combinação de prioridades: se a latência vocal e a proteção dos documentos forem críticas, favoreça uma abordagem edge‑first ou híbrida com processamento local dos fluxos sensíveis; se privilegiar simplicidade de operação e escalabilidade, uma arquitetura cloud‑first pode ser preferível. Na maioria dos casos multisite, a arquitetura híbrida particionada oferece um compromisso operacional interessante.
A SANIA disponibiliza um avatar IA conversacional profissional utilizável em ecrã ou quiosque interativo, com interacção vocal e tátil conforme configuração, disponível 24/7 e capaz de comunicar em mais de 100 idiomas. Para avaliar concretamente a arquitetura mais adequada ao seu parque, solicite uma demonstração para explorar os padrões de integração, os impactos em RAG/embeddings e um plano piloto à medida.