
Introduction : pourquoi une observabilité pensée SRE pour un avatar IA physique
Um avatar IA implantado num ecrã ou quiosque opera numa arquitetura distribuída que combina componentes locais (UI táctil, I/O áudio, periféricos) e serviços cloud ou on‑premise (ASR, LLM, TTS, RAG, integrações de negócio). Garantir disponibilidade 24/7 e detetar rapidamente degradações exige uma abordagem de observabilidade pensada para a exploração operacional, não apenas para o desenvolvimento.
Este guia apresenta um playbook operacional para definir SLO e SLA apropriados, construir testes sintéticos end‑to‑end que incluam percursos táctil e vocal, conceber logs rastreáveis e privacy‑safe, montar dashboards e alertas acionáveis e organizar runbooks e on‑call. As recomendações aplicam‑se a um deploy SANIA em ecrã ou quiosque, tendo em conta especificidades de hardware e integrações do projeto.
Définir SLO et SLA pertinents avant toute supervision
Os SLO (objetivos de nível de serviço) traduzem o que constitui um serviço aceitável para os utilizadores e para a organização em critérios operacionais. Os SLA são compromissos contratuais ou internos assentes nesses SLO. Para um avatar IA em espaço público, é importante alinhar SLO/SLA com as expectativas de negócio e as capacidades técnicas reais.
Em vez de impor métricas técnicas isoladas, estruture os objetivos à volta da experiência: disponibilidade do serviço de voz e táctil no local, latência percebida pelo utilizador, capacidade de fornecer resposta pertinente via base documental e tolerância a degradações de integrações em tempo real.
Mapear os percursos críticos (ex. orientação de visitante, informação de produto, fluxo de pagamento se existir) e definir quais os componentes a medir para cada percurso.
Transpor expectativas de negócio em medidas observáveis: disponibilidade, latência percebida, taxa de fallback para mensagem de erro ou assistência humana, atualidade dos conteúdos RAG.
Documentar dependências externas (ASR, LLM, TTS, APIs de negócio) e especificar que níveis de serviço são contratuais e quais são alvo de monitorização operacional.
Concevoir des tests synthétiques end-to-end qui couvrent tactile et vocal
O synthetic monitoring permite detetar regressões antes de afetarem massivamente os utilizadores. Para um quiosque interativo, um plano de testes sintéticos deve cobrir percursos tácteis, interações vocais completas (ASR -> LLM -> TTS) e cenários que recorram à base documental RAG ou APIs externas.
Os testes sintéticos podem ser executados a partir da cloud, por um agente on‑premise ou por dispositivos no local. Devem reproduzir fielmente a cadeia completa de interação e verificar não só o sucesso técnico, mas também uma qualidade funcional mínima (por exemplo, resposta não vazia, ausência de erro técnico, latência aceitável).
Testes tácteis: fluxo de boas‑vindas, navegação de menus, encadeamento de ecrãs, validação de botões e renderização visual.
Testes vocais end‑to‑end: injeção de ficheiro áudio ou síntese vocal simulada, verificação da transcrição ASR, avaliação da resposta produzida pelo LLM/RAG, restituição TTS e verificação da saída áudio.
Testes de integração em tempo real: chamadas a APIs de negócio simuladas, verificação de códigos de erro e comportamento em caso de indisponibilidade (degradação controlada).
Testes de atualidade RAG: queries direcionadas a documentos recentemente atualizados para verificar que a base documental retornada é coerente.
Concevoir des logs privacy-safe et traçables
A qualidade dos logs é essencial para diagnosticar um incidente. Em paralelo, é necessário garantir a confidencialidade das conversas e cumprir obrigações legais. Construa logs que continuem exploráveis pelas equipas SRE, minimizando os dados pessoais armazenados.
Adote princípios claros: separar metadados operacionais do conteúdo do utilizador, usar identificadores de correlação não reversíveis e aplicar políticas de anonimização ou pseudonimização adequadas conforme a natureza dos dados e a configuração do projeto.
Incluir sistematicamente um correlation id global para uma sessão (correlacionável entre UI local, ASR, LLM, TTS e chamadas API).
Registar metadados úteis ao diagnóstico: timestamps, latências por etapa, códigos de erro, versão do modelo LLM, identificadores de deployment e da máquina.
Evitar armazenar a transcrição completa ou o áudio bruto sem necessidade operacional justificada. Quando a conservação for necessária para análise, aplicar medidas robustas de anonimização e minimizar o período de retenção em conformidade com as decisões RGPD do projeto.
Manter traços de ações do sistema e de etapas de processamento RAG (que fonte documental foi solicitada) sem expor o conteúdo sensível em si.
Corrélation multi-composants pour diagnostiquer ASR, LLM, TTS et intégrations
Um incidente aparentemente global pode originar‑se num único componente: um ASR degradado, um motor LLM com degradação, latência de rede numa API de negócio ou um problema local no quiosque. A correlação das traces entre componentes é, portanto, indispensável para isolar rapidamente a causa raiz.
Projete pipelines de logs e traces que permitam reconstruir uma sessão completa. Utilize correlation ids propagados através de cada chamada e conserve metadados que indiquem o caminho executado e as latências por etapa.
Monitorizar a entrada do utilizador, a requisição enviada ao ASR, a transmissão para LLM/RAG, a requisição TTS e a restituição final, com latência e estado para cada etapa.
Incluir o ID de versão dos modelos ou configurações (ASR model vX, LLM routing, index RAG) para facilitar rollbacks ou análise de regressões pós‑deploy.
Conservar identificadores das requisições a APIs externas e códigos de resposta para avaliar incidentes de integração sem necessariamente armazenar a payload.
Dashboards et alerting actionnables pour les équipes Ops
Os dashboards devem sintetizar o estado do serviço para permitir tomada de decisão rápida. Devem ser orientados para a ação e ligados a alertas claros, evitando ruído e favorecendo a priorização de incidentes.
Conceba alertas diferenciados: os que exigem intervenção imediata e os que pedem investigação planeada. Documente o nível de impacto esperado para cada tipo de alerta, para orientar o on‑call.
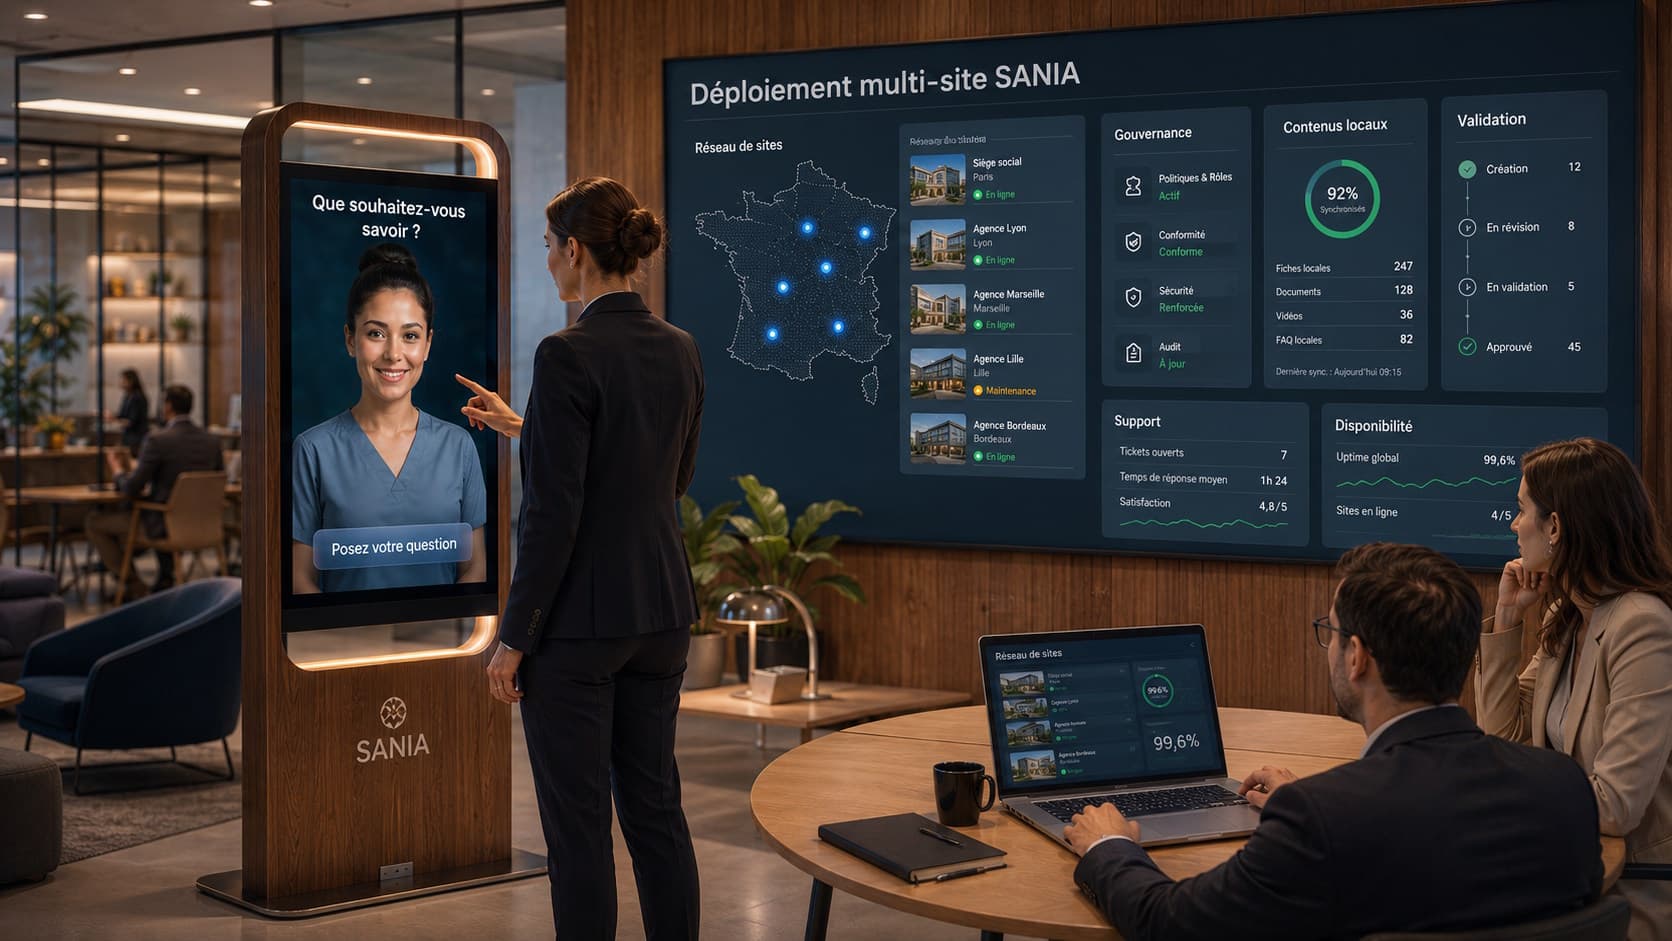
Exemplos de vistas de Dashboard: mapeamento de sites e estado dos quiosques, latência média por componente, traces agregadas de erros ASR/LLM/TTS, taxa funcional de fallback.
Alertas recomendadas: indisponibilidade de um serviço crítico (ASR/LLM/TTS), aumento sustentado de erros de integração, degradação perceptível da latência de media, anomalias na atualidade RAG indicando drift de conteúdos.
Privilegiar alertas com contexto enriquecido: logs correlacionados, etapas afetadas, último teste sintético falhado e sugestões operacionais do runbook.
Runbook, on-call et procédures d'escalade adaptées aux avatars IA
Um bom runbook deve ser pragmático e centrado nos sintomas observáveis. Para cada alerta ou tipo de incidente, documente os passos de diagnóstico rápido, as verificações a realizar no local e as ações de mitigação possíveis.
A organização on‑call deve prever papéis claros: quem opera a infraestrutura local, quem interroga os serviços cloud, quem gere as integrações de negócio. Evite depender de transferências automáticas não definidas no projeto; documente pontos de contacto e modos de comunicação.
Estrutura de um runbook de incidente: descrição do sintoma, verificações iniciais, comandos ou consolas a consultar, método de correlação de logs, ações temporárias de mitigação, critérios de fallback e de escalonamento.
Incluir procedimentos para testes rápidos no local (reinício controlado, comutação de rede, verificação de hardware áudio/táctil) e scripts de extração de logs correlacionados.
Prever exercícios regulares para validar os runbooks e manter a prontidão das equipas.
Stratégies de déploiement et pattern canary pour limiter les risques
Os deployments de componentes críticos (novo modelo LLM, atualização de ASR, alteração do pipeline RAG) devem minimizar o risco de impactar todo o parque. O canary deployment é um padrão útil: implantar numa área limitada, monitorizar os indicadores chave e alargar progressivamente se não houver sinais de degradação.
Documente critérios de validação de um canary e condições de rollback. Isto inclui resultados de testes sintéticos, taxas de erro observadas e ausência de alertas comportamentais.
Planear fases de validação: pré‑deploy em ambiente de teste, canary num pequeno âmbito, deployment progressivo com monitorização reforçada.
Definir critérios de paragem: sinais de alerta claros que disparem rollback ou interrompam o rollout.
Preparar mecanismos de rollback simples e testados para regressar a uma versão estável, se necessário.
Checklist opérationnelle avant et après mise en production
Segue uma lista de verificação operacional para preparar a entrada em produção e estabilizar a operação contínua. Agrupa aspetos de monitoring, privacidade, testes e procedimentos humanos.
Esta checklist deve ser adaptada ao contexto do projeto, à arquitetura escolhida e às obrigações regulatórias locais. Serve de base para validar que o avatar está pronto para operar 24/7.
Validar os SLO/SLA definidos e traduzi‑los em métricas observáveis.
Implementar testes sintéticos que cubram os percursos táctil e vocal e verificar a sua execução automatizada.
Configurar a propagação de correlation ids e a separação metadados/conteúdos nos logs.
Definir a política de anonimização e retenção de logs em conformidade com as decisões RGPD do projeto.
Criar dashboards operacionais e configurar alertas acionáveis com runbook associado.
Organizar o on‑call e realizar um exercício de incidente para validar procedimentos de diagnóstico e rollback.
Questions fréquentes (FAQ) : aspects pratiques
Q : É sempre necessário gravar o áudio ou a transcrição para diagnosticar um incidente? R : Não necessariamente. Metadados, códigos de estado e transcrições anonimizadas podem ser suficientes para a maioria das análises. A gravação completa só deve ser conservada se uma análise específica o exigir e após validação dos aspetos jurídicos e de confidencialidade.
Q : A SANIA fornece nativamente métricas de observabilidade? R : Consoante a configuração do projeto, a SANIA pode ser integrada em ferramentas de monitoring e explorar documentos de negócio (PDF, DOCX, XLSX, TXT, CSV ou NDJSON para workflows específicos). As métricas úteis devem ser expostas ou recolhidas através dos componentes deployados e das integrações escolhidas.
Q : Como verificar a atualidade dos conteúdos RAG? R : Configure queries sintéticas direcionadas a documentos recentes e monitorize as respostas bem como os logs RAG que indiquem quais as fontes solicitadas, de modo a alertar em caso de drift ou falta de documentos atualizados.
Pour aller plus loin
A implementação de um dispositivo completo de observabilidade para um avatar IA exige colaboração estreita entre equipas de produto, infraestruturas, segurança e operação. Adapte este playbook ao âmbito técnico e às obrigações do projeto e privilegie iterações curtas para estabilizar progressivamente os SLO.
A SANIA pode ser explorada em ecrã ou quiosque interativo com interação táctil e/ou vocal conforme a configuração, e integrar uma base documental de negócio para cenários RAG. Para estudar a adaptação deste playbook ao seu deployment e receber uma demonstração operacional, pode solicitar uma apresentação da SANIA e dos nossos workflows de exploração.