Introdução: por que um protocolo UAT dedicado a avatars IA na loja
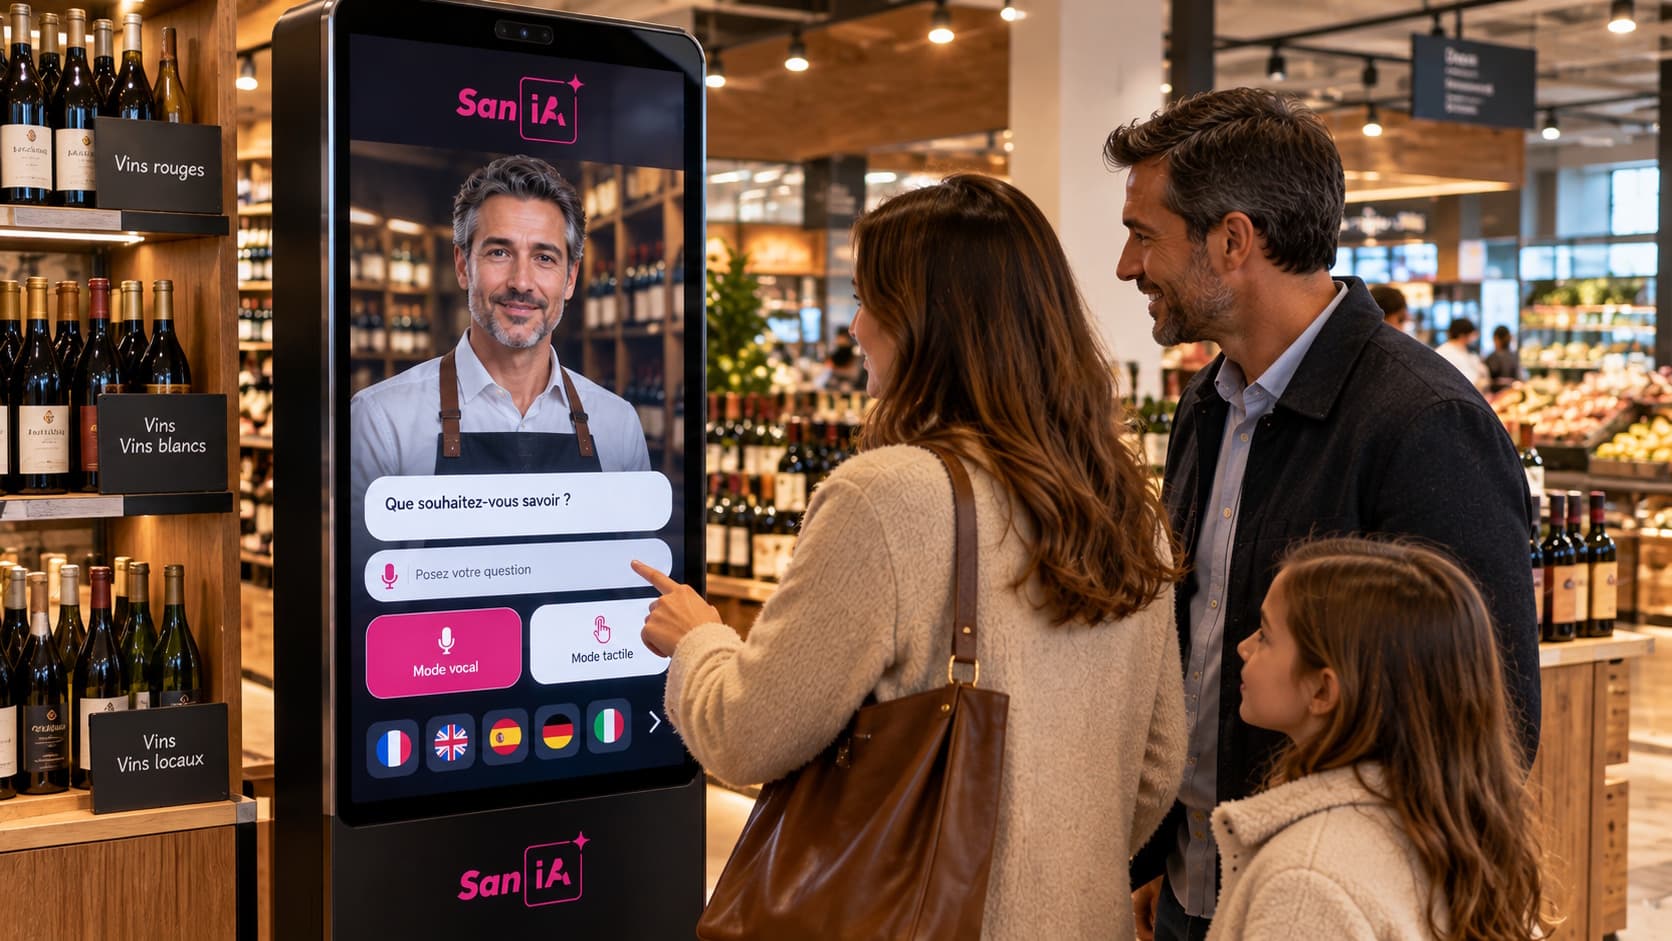
Um piloto de avatar IA num posto ou ecrã deve provar em condições reais que a experiência cumpre os objetivos de negócio: acolhimento, informação, orientação e encaminhamento. Um protocolo estruturado de teste de utilizador e aceitação (UAT) evita ilusões geradas por testes técnicos isolados e assegura que o avatar funciona com interações reais de voz e táteis, em várias línguas e com a base documental da área.
Este documento propõe um protocolo pronto a usar: definição de objetivos, cenários de teste tipo, método de recrutamento multilingue, scripts observáveis, indicadores qualitativos e quantitativos a acompanhar, checklists técnicas e critérios operacionais de go/no‑go. Os pontos SANIA relevantes são assinalados onde devem ser verificados durante o piloto.
Definir os objetivos de negócio e o âmbito do piloto
Antes de qualquer teste, formalize os objetivos concretos do piloto. Devem estar ligados a usos precisos: pedido de informação de produto, orientação na loja, resposta a perguntas frequentes, acesso multilingue ou encaminhamento para um serviço. Cada objetivo traduz‑se em casos de uso priorizados que servirão de base aos cenários de teste.
Especifique o âmbito técnico e operacional: modos de interação ativados (voz, tátil, ou ambos), línguas a cobrir, integrações eventualmente disponíveis (inventário, horários, ecrãs dinâmicos), restrições de ambiente (ruído, luminosidade, circulação). Distinção importante: o que é uma capacidade nativa do avatar e o que exigirá uma integração específica.
Cenários de utilizador tipo: voz, tátil e multilingue
Construa um conjunto de cenários que cubram os percursos mais frequentes e as situações de falha. Cada cenário deve incluir o objetivo do utilizador, o contexto, os pré‑requisitos (língua, disponibilidade de uma integração), o guião do utilizador e os critérios de resultado. Varie os cenários entre: interações puramente de voz, interação tátil só, percursos mistos tátil depois voz, e troca de língua durante a sessão.
Exemplos de casos de negócio a incluir: pedido de informação de produto, pesquisa de uma secção ou de um produto em stock, pedido de horários e serviços, questão regulamentar ou de segurança simples, e pedido que exija encaminhamento para um elemento humano. Para testes multilingues, inclua falantes nativos e não‑nativos para avaliar a robustez do ASR e a formulação das respostas.
Guiões de teste observáveis e grelha de observação
Cada sessão de teste deve ser conduzida com um guião preciso e uma grelha de observação preenchida em tempo real pelo testador. A grelha documenta os elementos objetivos seguintes: iniciação (tempo até iniciar a interação), compreensão ASR (o avatar transcreveu corretamente o pedido?), pertinência da resposta, clareza vocal e volume do TTS, ergonomia tátil (menus, rótulos), tempo de latência percebido, necessidade de escalonamento e satisfação declarada pelo utilizador.
Complete estas observações com notas qualitativas sobre entoação, confusões recorrentes e expressões de utilizador não previstas. O objetivo é produzir vestígios exploráveis para corrigir a base documental, ajustar prompts e microcopy ou melhorar parâmetros ASR/TTS.
Campo da grelha de observação: ID teste, cenário, língua, modo (voz/tátil), transcrição ASR observada, resposta fornecida, duração da interação, intervenção humana necessária, estado sucesso/insucesso, comentários.
Recrutamento dos participantes e tamanho da amostra
O recrutamento deve visar a representatividade dos visitantes reais: perfis demográficos, níveis de familiaridade com a ferramenta, línguas faladas e comportamentos de uso (preferência tátil ou vocal). Priorize a diversidade em vez do volume bruto para identificar casos problemáticos e enviesamentos linguísticos ou culturais.
Em vez de impor um número fixo, organize os testes por iterações até ao ponto de saturação qualitativa: quando surgem os mesmos problemas recorrentes e poucas observações novas são acrescentadas, a fase inicial de testes pode ser considerada abrangente. Este princípio evita um limiar arbitrário e adapta‑se à afluência e à complexidade do âmbito testado.
Execução dos testes na loja: logística e boas práticas
Planeie sessões em intervalos representativos de afluência. Prepare o ambiente: sinalética clara indicando que se trata de um teste, instruções de confidencialidade e autorizações caso sejam feitas gravações. Lembre‑se de que a recolha de dados pessoais deve ser tratada conforme a legislação aplicável e que a configuração da SANIA dependerá das opções de retenção escolhidas pela organização.
Durante a sessão, limite as intervenções do testador para não enviesar o comportamento. Registe exemplos anonimizados das interações se a configuração do piloto o permitir e se for obtido consentimento. Utilize a grelha de observação para recolher medidas objetivas e feedback qualitativo imediato.
KPIs e critérios go/no‑go: o que medir e como decidir
Selecione um conjunto limitado de indicadores quantitativos e qualitativos alinhados com os objetivos de negócio. Exemplos de dimensões úteis: taxa de resolução percebida pelos testadores, taxa de escalonamento para intervenção humana identificada pela observação, qualidade da compreensão ASR nas línguas testadas, latência média percebida e satisfação do utilizador declarada a quente. Especifique os métodos de recolha: grelha de observação, inquérito pós‑interação separado, ou instrumentação externa conforme integrações disponíveis.
Para os critérios go/no‑go, prefira critérios operacionais legíveis: se os pedidos principais do negócio não forem resolvidos de forma fiável nas línguas prioritárias, se o ASR falhar sistematicamente em contexto real, ou se a interface tátil impedir o acesso a funções essenciais, o piloto não pode ser validado para passagem à fase seguinte. Evite fixar limites numéricos universais sem contextualização: esses critérios devem ser adaptados à ambição do projeto e à criticidade do negócio.
Checklist técnica a validar durante o piloto
Durante o UAT, valide os elementos técnicos que impactam a experiência. Verifique nomeadamente a robustez do ASR nas línguas ativadas, a qualidade e inteligibilidade do TTS, a pertinência das respostas provenientes da RAG documental, os comportamentos de fallback quando a fonte documental não é suficiente, e a latência percebida nos pedidos ao LLM ou nas integrações em tempo real.
Para a SANIA, confirme os seguintes pontos na configuração do piloto: capacidade de alternar entre voz e texto conforme configuração, manutenção do contexto conversacional durante uma sessão, disponibilidade multilingue configurada e adequação da base de conhecimento fornecida pela organização. Integrações específicas com sistemas terceiros devem ser testadas como desenvolvimentos distintos.
Checklist técnica sintética: ASR (testes em condições reais por língua), TTS (inteligibilidade, volume), RAG (pertinência e fontes citadas), gestão de erros e fallback, latência de chamadas LLM, integrações críticas testadas, disponibilidade 24/7 simulada.
Processo de escalonamento e gestão de falhas em produção
Defina antecipadamente as situações em que o avatar deve convidar o utilizador a contactar um membro do pessoal. O piloto deve documentar esses casos para evitar rupturas de experiência: questões regulamentares sensíveis, problemas de segurança, pedidos que exigem acesso a sistemas protegidos, ou incompreensão persistente após várias tentativas.
Não presuma um mecanismo automático de transferência: preveja mensagens‑tipo, a forma como o avatar informa o utilizador e a lógica de recomendação para um interlocutor humano. O playbook 'Passar para um agente humano desde um avatar IA' pode servir de referência para formalizar estas regras operacionais.
Templates exportáveis: cenários, grelha de observação e relatório de aceitação
Para facilitar a execução, aqui estão modelos que pode reproduzir numa folha de cálculo ou numa ferramenta de recolha:
Template de cenário: ID | Nome do cenário | Objetivo | Língua | Modo (voz/tátil) | Pré‑condição | Guião do utilizador | Ações esperadas do avatar | Critério sucesso/insucesso | Observações.
Template grelha de observação: ID teste | Cenário | Participante (perfil) | Língua | Início interação | Transcrição ASR | Resposta fornecida | Duração | Intervenção humana | Estado | Comentários detalhados.
Template relatório de aceitação: Contexto do piloto | Âmbito testado | Síntese de resultados qualitativos | Síntese de resultados técnicos | Pontos bloqueantes | Melhorias necessárias | Lista de ações prioritárias | Recomendação operacional (go / go com reservas / no‑go).
Pontos específicos SANIA a verificar no piloto
Entre as capacidades confirmadas da SANIA, verifique durante o piloto: a comunicação multilingue configurada para as línguas pertinentes, a interação vocal e tátil conforme a configuração escolhida, a capacidade de manter o contexto ao longo de uma sessão e a exploração da base de conhecimento profissional fornecida pela sua organização. Estes elementos são componentes nativos ou configuráveis cuja qualidade deve ser validada em condições reais.
Se o seu projeto incluir integrações específicas (inventário, horários, POS), trate‑as como desenvolvimentos distintos e teste‑as como tal. Da mesma forma, a gestão de vozes personalizadas ou clonagem vocal só é possível se os direitos e a parametrização forem fornecidos e devem ser validados durante o piloto.
FAQ rápida
Como medir a satisfação sem instrumentação nativa? Uma organização pode recolher a satisfação imediata através de uma breve pesquisa separada após a interação, ou através da grelha de observação preenchida por um testador. Estes métodos devem ser decididos antes do piloto.
É preciso traduzir toda a base documental para cada língua? Não. A SANIA pode comunicar em mais de 100 línguas quando configurada. A prioridade deve recair sobre a informação empresarial chave e a sua qualidade nas línguas realmente relevantes para o seu público. A estratégia de localização dependerá dos seus objetivos e recursos.