Introdução: por que um TCO preciso é indispensável
Decidir por um piloto ou por uma implementação multi‑local de um avatar IA em quiosque interativo exige um número credível, aceite pela direção e pela equipa de TI. O custo não se limita à compra do quiosque: cobre infraestrutura de hardware, licenças LLM, síntese e reconhecimento de voz, conectividade, integração com sistemas métier, operação 24/7 e governação de conteúdo.
Este artigo propõe um método acionável para decompor essas parcelas, estimar o consumo de tokens e construir cenários piloto / 10 / 100 locais. O objetivo é fornecer referências concretas para redigir um orçamento, negociar contratos e definir alavancas de otimização.
As parcelas de custo a considerar
Para construir um TCO completo, agrupe as despesas em CAPEX (investimentos iniciais) e OPEX (custos recorrentes). Cada parcela abaixo deve constar na sua folha de cálculo de orçamento.
Hardware e instalação (CAPEX): ecrã ou quiosque interativo, suporte físico, caixa de áudio, microfones e altifalantes adequados, eventual proteção física e instalação de rede no local. Considere custos de transporte e instalação em cada local.
Software e licenças (OPEX/CAPEX conforme contrato): licença da solução avatar, custos de acesso aos motores LLM (cobrança por tokens ou subscrição), licenças TTS (síntese vocal) e ASR (reconhecimento) se faturadas separadamente, licenças de SO ou de aplicação de quiosque.
Integrações e desenvolvimento (CAPEX / OPEX inicial): adaptação da base de conhecimento, desenvolvimento de APIs para ligar POS, inventário ou CRM, configuração do RAG e testes multilíngues. Inclua validação jurídica de conteúdos quando necessário para respostas sensíveis ao negócio. Estes custos cobrem também testes UAT e ajustes de UX voz/tátil antes da produção local ou do piloto multi‑local.
Custos operacionais recorrentes a orçar
Operar um avatar IA implica custos recorrentes frequentemente subestimados. Identifique e orce claramente:
Custos LLM: faturação por token ou por subscrição. O custo dependerá do volume de pedidos, do tamanho médio de prompts e respostas, e da política de preços do fornecedor. Conforme a configuração, podem ser orquestrados múltiplos motores LLM para equilibrar qualidade e custos.
Custos de voz: TTS e ASR podem ser cobrados por minuto, por pedido ou via subscrição. O reconhecimento em ambientes ruidosos pode aumentar o volume de pedidos (retransmissões, retries), pelo que deve ser considerado.
Conectividade e dados: largura de banda para chamadas API, custo de ligações redundantes para garantir disponibilidade, eventuais custos de armazenamento e transferência para embeddings se a solução armazenar vetores na cloud ou on‑premise segundo a configuração escolhida para o RAG.
Método passo a passo para estimar o consumo LLM (fórmula operacional)
Em vez de inventar números, defina variáveis mensuráveis e aplique uma fórmula simples. Seguem os passos e a fórmula a integrar na sua folha de cálculo:
1. Medir ou estimar o tráfego: número médio de interações por quiosque por dia, distinguindo interações táteis e por voz. 2. Estimar o tamanho médio de uma interação em tokens: prompt do utilizador + contexto enviado ao LLM + resposta gerada. 3. Multiplicar tokens por interação pelo número de interações no período desejado (mês/ano). 4. Aplicar a tarifa do fornecedor expressa por custo por 1.000 tokens (ou outra unidade).
Fórmula sucinta a implementar: Custo LLM (período) = (interações/dia x dias) x (tokens médios por interação / 1000) x (preço por 1000 tokens).
Mesma lógica para TTS/ASR: estime o tempo médio de áudio gerado ou processado por interação e multiplique pelo preço do fornecedor (por minuto ou por pedido).
Construir cenários: piloto, 10 locais, 100 locais (modelo de cálculo adaptável)
Em vez de anunciar montantes, estruture três cenários na sua folha de cálculo usando as mesmas variáveis anteriores. Para cada cenário, indique: número de unidades (quiosques), tráfego estimado por unidade, exigências multilíngues (número de línguas ativadas), modo de voz ativo ou não, arquitetura (edge, cloud, híbrida) e nível de SLA esperado.
Os custos CAPEX multiplicam‑se pelo número de unidades para hardware e instalação, enquanto alguns custos OPEX podem beneficiar de economias de escala (por exemplo licença central, alojamento partilhado, monitorização centralizada). Preencha colunas: unidade, quantidade, preço unitário (fornecedor), periodicidade, total por período e total anualizado.
Inclua uma coluna para “custos únicos de integração” por local e outra para “custos de operação centralizados” (suporte, atualização de conteúdos, alojamento de embeddings). Por fim, preveja uma célula para imprevistos e um cenário de sensibilidade baseado em variações de tráfego ou aumento dos preços de tokens.
Alavancas concretas de otimização económica
Diversas decisões técnicas e operacionais influenciam fortemente o TCO. Eis as alavancas que pode testar ou negociar:
Edge vs cloud: processar algumas solicitações localmente reduz chamadas ao LLM e a latência, mas aumenta o CAPEX e a manutenção local. Uma abordagem híbrida permite externalizar solicitações complexas e tratar localmente FAQs frequentes.
Cache e pré‑geração: armazenar em cache respostas frequentes ou pré‑gerar conteúdos estáticos diminui o volume de tokens pedidos ao LLM.
Orquestração multi‑LLM: direcionar pedidos de baixo custo para modelos mais económicos e reservar modelos premium para casos que exijam respostas mais elaboradas.
TTS localizado: usar vozes locais (edge TTS) para interações frequentes pode reduzir a fatura de TTS, desde que se suporte o custo de hardware e manutenção.
Otimização de prompts e do RAG: estruturar a base de conhecimento para limitar a quantidade de contexto enviada ao LLM. O uso de uma pesquisa semântica bem gerida pode reduzir tokens desnecessários, mas implica custo de armazenamento e atualização de embeddings conforme a configuração escolhida (on‑prem ou cloud).
Cláusulas contratuais e SLAs a negociar
Os contratos com fornecedores de LLM, TTS/ASR, editor do avatar ou integrador devem cobrir pontos precisos para assegurar o seu orçamento e o nível de serviço:
Tarificação e granularidade das unidades: especificar a unidade faturada (tokens, pedidos, minutos), escalões de preços e mecanismos de overage.
SLA de disponibilidade e penalizações: definir o compromisso de disponibilidade para a API e eventuais penalizações associadas a indisponibilidades que afetem o serviço no quiosque.
Compromissos de desempenho: latência média esperada para respostas e para o TTS, e tempo máximo aceitável em caso de degradação.
Suporte e horários: nível de suporte (horário comercial vs 24/7), prazos de resposta, processo de escalonamento e contacto dedicado.
Segurança e tratamento de dados: obrigações sobre conservação, eliminação, localização dos dados e condições de uso dos conteúdos métier fornecidos (RAG, embeddings).
Cláusulas de saída e portabilidade: condições de rescisão, acesso a dados exportáveis e modalidades para retomar a base de conhecimento em caso de mudança de fornecedor.
Checklist procurement e template de cálculo a preparar antes do RfP
Antes de lançar um RfP ou entrar em negociação, prepare um dossiê estruturado contendo as suas variáveis métier e exigências técnicas:
Descrição dos usos prioritários e volume esperado por quiosque (interações voz / tátil), por período.
Lista das integrações necessárias (POS, inventário, CRM) e exigências de autenticação.
Exigências multilíngues e qualidade de vozes (TTS) esperada para cada idioma.
Nível de disponibilidade desejado e ritmo de atualizações da base de conhecimento.
Metodologia de estimativa de custos que espera do fornecedor (forneça a sua folha de cálculo de variáveis para obter comparativos homogéneos).
Pontos contratuais não negociáveis: SLA mínimo, segurança dos dados e recuperação em caso de saída.
Perguntas frequentes (FAQ) úteis para o comité de pilotagem
P: Como justificar a diferença entre elevado CAPEX e OPEX reduzido a longo prazo? R: Apresente vários horizontes de comparação (custo total anualizado) e destaque os principais custos recorrentes (LLM, TTS, suporte). O comité deve compreender o ponto de equilíbrio e as alavancas para o alterar.
P: Deve‑se privilegiar o edge para reduzir a despesa com LLM? R: O edge reduz algumas chamadas a modelos pagos, mas exige investimento em hardware e maior manutenção local. Uma estratégia híbrida é frequentemente a mais pragmática: tratar localmente interações de baixo valor e delegar para a cloud os casos complexos.
Para ir mais longe e próximo passo
Para transformar este guia em números concretos, descarregue ou crie uma folha de cálculo com as variáveis mencionadas e convide os seus fornecedores a preencherem os seus preços unitários com base nos seus usos estimados. Teste pelo menos um piloto num local para medir os tokens médios por interação e ajustar os cenários 10/100 locais.
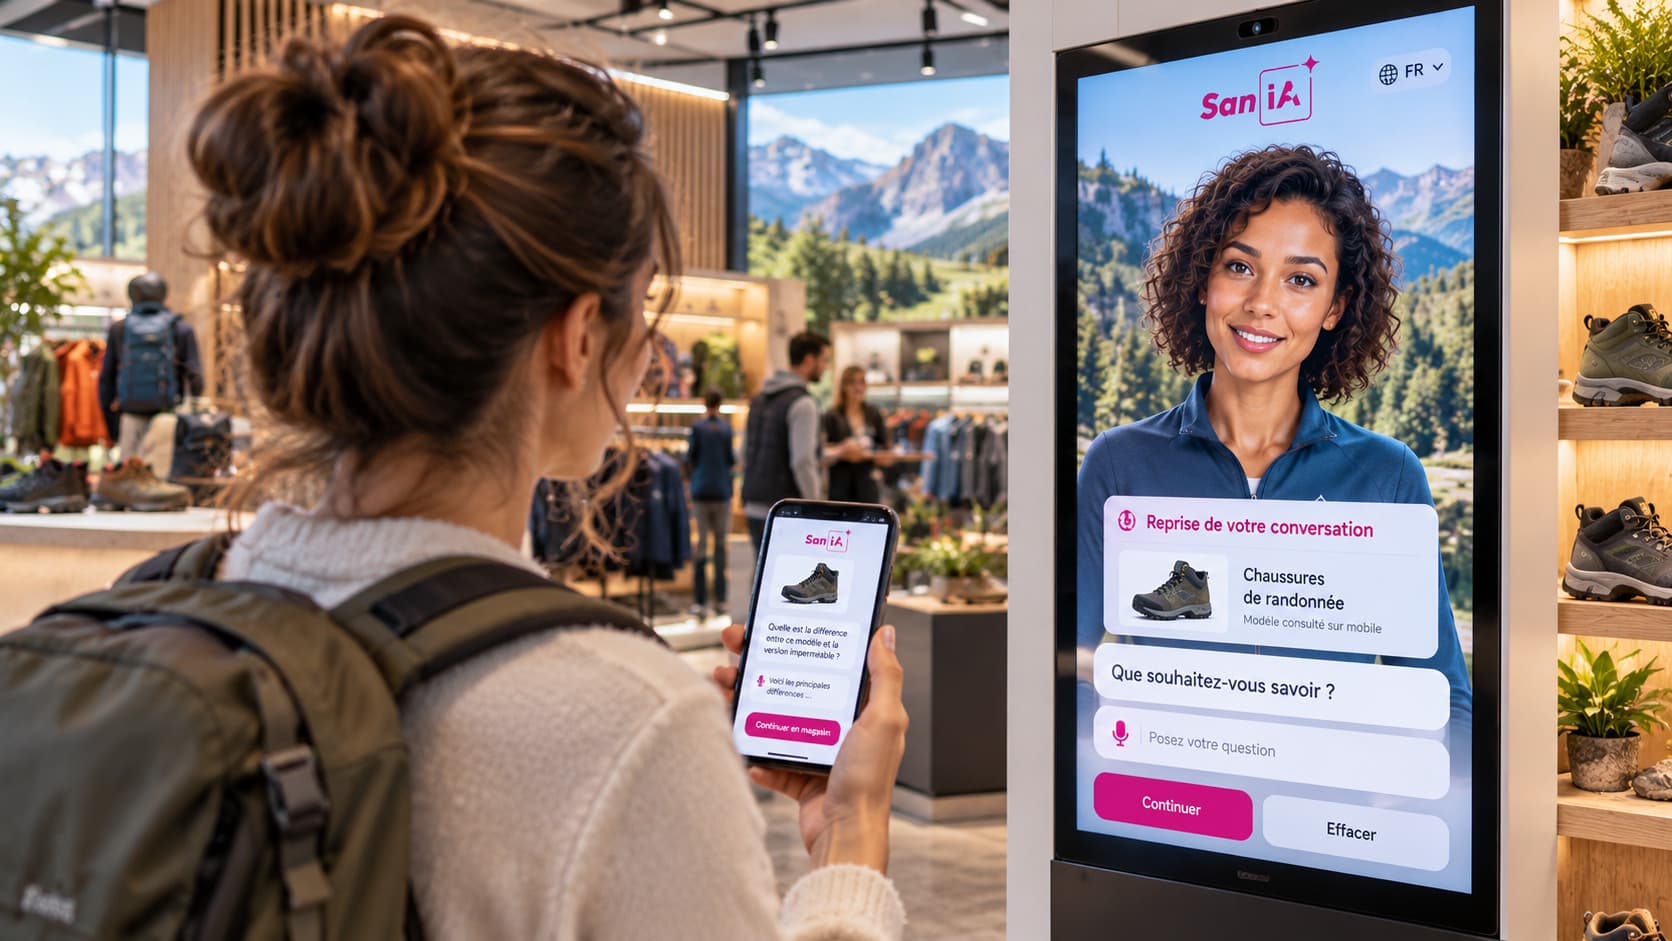
A SANIA pode ser implementada em ecrã ou quiosque interativo, funcionar por voz e/ou toque e apoiar‑se numa base de conhecimento própria da organização. Para estudar com precisão como essas escolhas impactam o seu TCO no seu contexto (arquitetura edge vs cloud, orquestração multi‑LLM, TTS/ASR), pode pedir uma demonstração e um orçamento adaptado à sua rede de locais.