Kurze Einführung: Der richtige Kompromiss hängt von Ihren Prioritäten ab
Die Entscheidung zwischen Edge, Cloud oder einer hybriden Architektur zur Bereitstellung eines KI‑Avatars auf einem Kiosk oder Bildschirm ist keine technische Modefrage, sondern ein Abwägen realer Restriktionen: Latenz der Sprachkette, Schutz der betrieblichen Dokumente, Betriebskosten über mehrere Standorte, 24/7‑Wartungsfähigkeit und Netzwerk‑Ausfalltoleranz. Dieser Leitfaden bietet einen pragmatischen Entscheidungsrahmen, konkrete Architektur‑Patterns, die mit gängigen OS‑ und SoC‑Familien (Samsung Tizen, Android, Windows je nach Konfiguration) kompatibel sind, praxisnahe Szenarien und eine einsatzbereite Pilot‑Checkliste.
Kriterienmatrix zum Vergleich der Architekturen
Bevor Sie wählen, priorisieren Sie Ihre Anforderungen in einer einfachen Matrix mit folgenden Dimensionen: Benutzerlatenz (ASR, LLM, TTS), Datenschutz und Datenlokalisierung (RAG und betriebliche Dokumente), Total Cost of Ownership über mehrere Standorte, Betriebsfähigkeit und 24/7‑Wartung, Skalierbarkeit und Fähigkeit, Modell‑ oder Inhaltsupdates auszurollen.
Für jede Dimension legen Sie fest, ob sie ein Muss, ein akzeptabler Kompromiss oder eine nachgeordnete Priorität ist. Wenn beispielsweise eine verzögerungsfreie Sprachbegrüßung zwingend ist, wird die Latenz zur Priorität und spricht für ein Edge‑first oder ein hybrides Modell mit lokalem Sprach‑Processing. Steht der Schutz interner Dokumente im Vordergrund, bevorzugen Sie die Verarbeitung von Embeddings und die Suche in einer kontrollierten Infrastruktur (Edge oder privates Cloud‑Setup, je nach Richtlinie).
Drei operationale Architektur‑Patterns
1) Edge‑first: Priorität für lokale Sprachverarbeitung und RAG. In diesem Pattern laufen ASR und TTS lokal auf der Station (oder auf einem lokalen Server), um die vom Nutzer wahrgenommene Latenz zu minimieren. Sensible Dokumentensuche (Erzeugung von Embeddings und semantische Suche) wird lokal oder in einem kontrollierten Netzsegment gehostet. Generative LLMs können lokal betrieben werden, sofern Hardware und Lizenzen dies erlauben, oder für komplexere Anfragen in die Cloud ausgelagert werden, wobei lokal eine Filter‑Policy greift.
2) Cloud‑first: Zentralisierung und Skalierbarkeit. ASR, LLM, TTS und die RAG‑Wissensbasis liegen im Cloud‑Backend. Dieses Modell vereinfacht Wartung, erleichtert Modell‑Updates und entlastet die Kioske. Es kann jedoch zusätzliche Latenz einführen und verlangt robuste Netzwerkgarantien sowie vertragliche Schutzmaßnahmen für Daten, die in die Cloud übertragen werden.
3) Hybride Partitionierung: pragmatischer Ausgleich. Die hybride Variante verteilt Komponenten nach Sensitivität und erwarteter Latenz. Beispiel: ASR und Audio‑Preprocessing am Edge, Embeddings und RAG lokal oder in einer privaten Cloud zur Schutz sensibler Inhalte, und das generative LLM in der Cloud, um von höheren Kapazitäten und häufigen Updates zu profitieren. Dieses Pattern erlaubt teilweise Offline‑Resilienz: bei Cloud‑Ausfall kann das Avatar weiterhin Standardfälle aus lokalem Wissen beantworten.
Geschäftsszenarien und praktische Empfehlungen
Retail in städtischen Gebieten: Geschäfte mit hohem Besucheraufkommen benötigen eine flüssige, mehrsprachige Interaktion. Wenn die Hauptnutzung sprachbasiert ist und Latenz kritisch, bevorzugen Sie ein hybrides Pattern mit ASR/TTS am Edge und LLM in der Cloud. Schützen Sie sensible Handelsinhalte (Produktdaten, Aktionen) durch RAG‑Segmentierung und Verschlüsselung.
Öffentliche Rezeption und Verwaltung: Hier hat die Vertraulichkeit der Dokumente oft Priorität. Ein Edge‑first oder hybrides Architekturmodell mit lokaler Dokumentenverwaltung reduziert ausgehende Datenflüsse und erhält dennoch eine akzeptable Sprachqualität.
Events und temporäre Kontexte: Schnelle Bereitstellung, einfache Wartung und Kosten sprechen oft für eine Cloud‑first‑Lösung, ergänzt durch lokalen Cache, um bei Netzverlust eine kontrollierte Degradation zu ermöglichen.
Verteilte Multistandorte: Bei großen heterogenen Deployments beachten Sie lokale Netzkapazitäten, die Vielfalt an OS/SoC und Data‑Governance‑Anforderungen. Das hybride Pattern erleichtert funktionale Vereinheitlichung und erlaubt zugleich standortspezifische Anpassungen.
Auswirkungen auf RAG und Embeddings: Datenschutz, Aktualität und Corpusgröße
Der Standort des RAG‑Services beeinflusst direkt Datenschutz und die Fähigkeit, aktuelle Antworten zu gewährleisten. Ein lokal gehostetes Embeddings‑Index reduziert den Transfer sensibler Dokumente, verlangt jedoch verteilte Refresh‑ und Wartungsprozesse. Embeddings im Cloud‑Backend vereinfachen Updates und Industrialisierung, erfordern aber vertragliche Zusicherungen und Verschlüsselungsmaßnahmen bei der Übertragung.
Die Strategie zur Aktualisierung von Embeddings muss operational definiert sein: wer kann ein Update auslösen, welche menschliche Validierung ist nötig und wie stellt man ein Rollback bei Regressionen sicher. Diese Regeln sind unabhängig von Edge/Cloud, ihre Umsetzung unterscheidet sich jedoch je nach Architektur.
Updates von LLM, TTS und ASR in Produktion: Governance und Rollout
Updates von Modellen und Komponenten brauchen einen klaren Workflow. Bestimmen Sie die Verantwortlichen für Modellauswahl, Qualitätsprüfungen und Go‑Live. Bei Cloud‑first lassen sich Updates zentral und schnell ausrollen. Für Edge‑Setups planen Sie Verteilung von Binaries oder Containern an die Stationen, gestufte Tests und einen Rollback‑Mechanismus.
In hybriden Umgebungen empfehlen sich Blue/Green‑ oder Canary‑Deployments, um Regressionsrisiken in heterogenen Parks zu begrenzen. Dokumentieren Sie zu testende Kriterien vor dem Rollout: wahrgenommene Latenz, ASR‑Qualität in Zielsprachen, TTS‑Kohärenz und fachliche Relevanz der generierten Antworten.
Runbook für Degradation und Strategien für Graceful Fallback
Planen Sie Ausfälle des Netzwerks oder Cloud‑Dienste durch klare Degradationsverhalten. Beispielregeln: bei verschlechterter LLM‑Verbindung auf vordefinierte Antworten oder ein lokales FAQ‑Subset umschalten; bei Nichterreichbarkeit des ASR‑Cloud‑Dienstes ein vereinfachtes lokales Modell einsetzen oder die Interaktion auf Touch umstellen; ist der RAG‑Index nicht erreichbar, informieren Sie den Nutzer, dass das Avatar allgemeine Antworten liefert und andere Kanäle für sensible Anfragen empfohlen werden.
Das Runbook muss Alarmsequenzen für den Betrieb, Wiederanlaufprüfungen und die erforderlichen manuellen Maßnahmen beschreiben. Vermeiden Sie die Behauptung eines automatischen Transfers zu einem menschlichen Agenten ohne passende Integrationen und Prozesse: definieren Sie stattdessen, wann das Avatar den Nutzer an Personal verweist und wie das Team den Vorgang übernimmt.
Betriebliche Pilot‑Checkliste vor Industrialisation
Validieren Sie vor einer Ausweitung einen strukturierten Pilotlauf, der die folgenden Punkte abdeckt. Die Checkliste berücksichtigt Mehrsprachigkeit, Ziel‑OS/SoC und 24/7‑Betrieb:
Prioritäten auf der Matrix Latenz/Datenschutz/Kosten/Betriebsfähigkeit definieren.
Architekturpattern wählen (edge‑first, cloud‑first, hybrid) und die Partionierung der Komponenten (ASR, TTS, LLM, RAG) dokumentieren.
RAG‑Pipeline validieren: Herkunft der Dokumente, gegebenenfalls Anonymisierung, Aktualisierungsfrequenz der Embeddings und Rollback‑Prozedur.
Latenz‑ und ASR/TTS‑Qualitätstests in den Zielsprachen unter realen Störgeräuschen planen.
Runbook für Degradation und Alarm‑Playbooks für den 24/7‑Betrieb einrichten.
Update‑Prozesse für Modelle definieren und Testkriterien vor Produktion für Edge und Cloud festlegen.
Komplementäre betriebliche Aspekte: Kosten, Wartung und OS/SoC
Der Total Cost of Ownership hängt stark von der Größe des Parks und dem gewählten Pattern ab. Cloud‑first‑Architekturen reduzieren die lokale Wartungskomplexität, können aber laufende Kosten durch Modellaufrufe und zentrales Storage verursachen. Edge‑first‑Setups erhöhen die lokale Hardware‑ und Softwarewartung, können jedoch Betriebskosten durch geringeren Netzwerktraffic reduzieren und die Latenz verbessern.
Praktisch prüfen Sie die Kompatibilität mit den vom Projekt unterstützten OS‑Umgebungen. SANIA lässt sich auf professionellen Samsung‑Displays im SoC/Tizen‑Umfeld bereitstellen, über eine Android‑App auf kompatiblen Plattformen oder in angepassten Windows‑Umgebungen. Die Wahl beeinflusst Packaging von Updates und Betriebsrestriktionen.
Fazit und praktischer Ausblick
Die richtige Wahl ergibt sich aus einer Kombination von Prioritäten: Sind Sprachlatenz und Dokumentenschutz kritisch, bevorzugen Sie ein Edge‑first oder hybrides Modell mit lokaler Verarbeitung sensibler Streams; legen Sie Wert auf einfache Betriebsführung und Skalierbarkeit, kann Cloud‑first geeigneter sein. Bei den meisten Multisite‑Szenarien stellt die hybride Partitionierung einen pragmatischen Kompromiss dar.
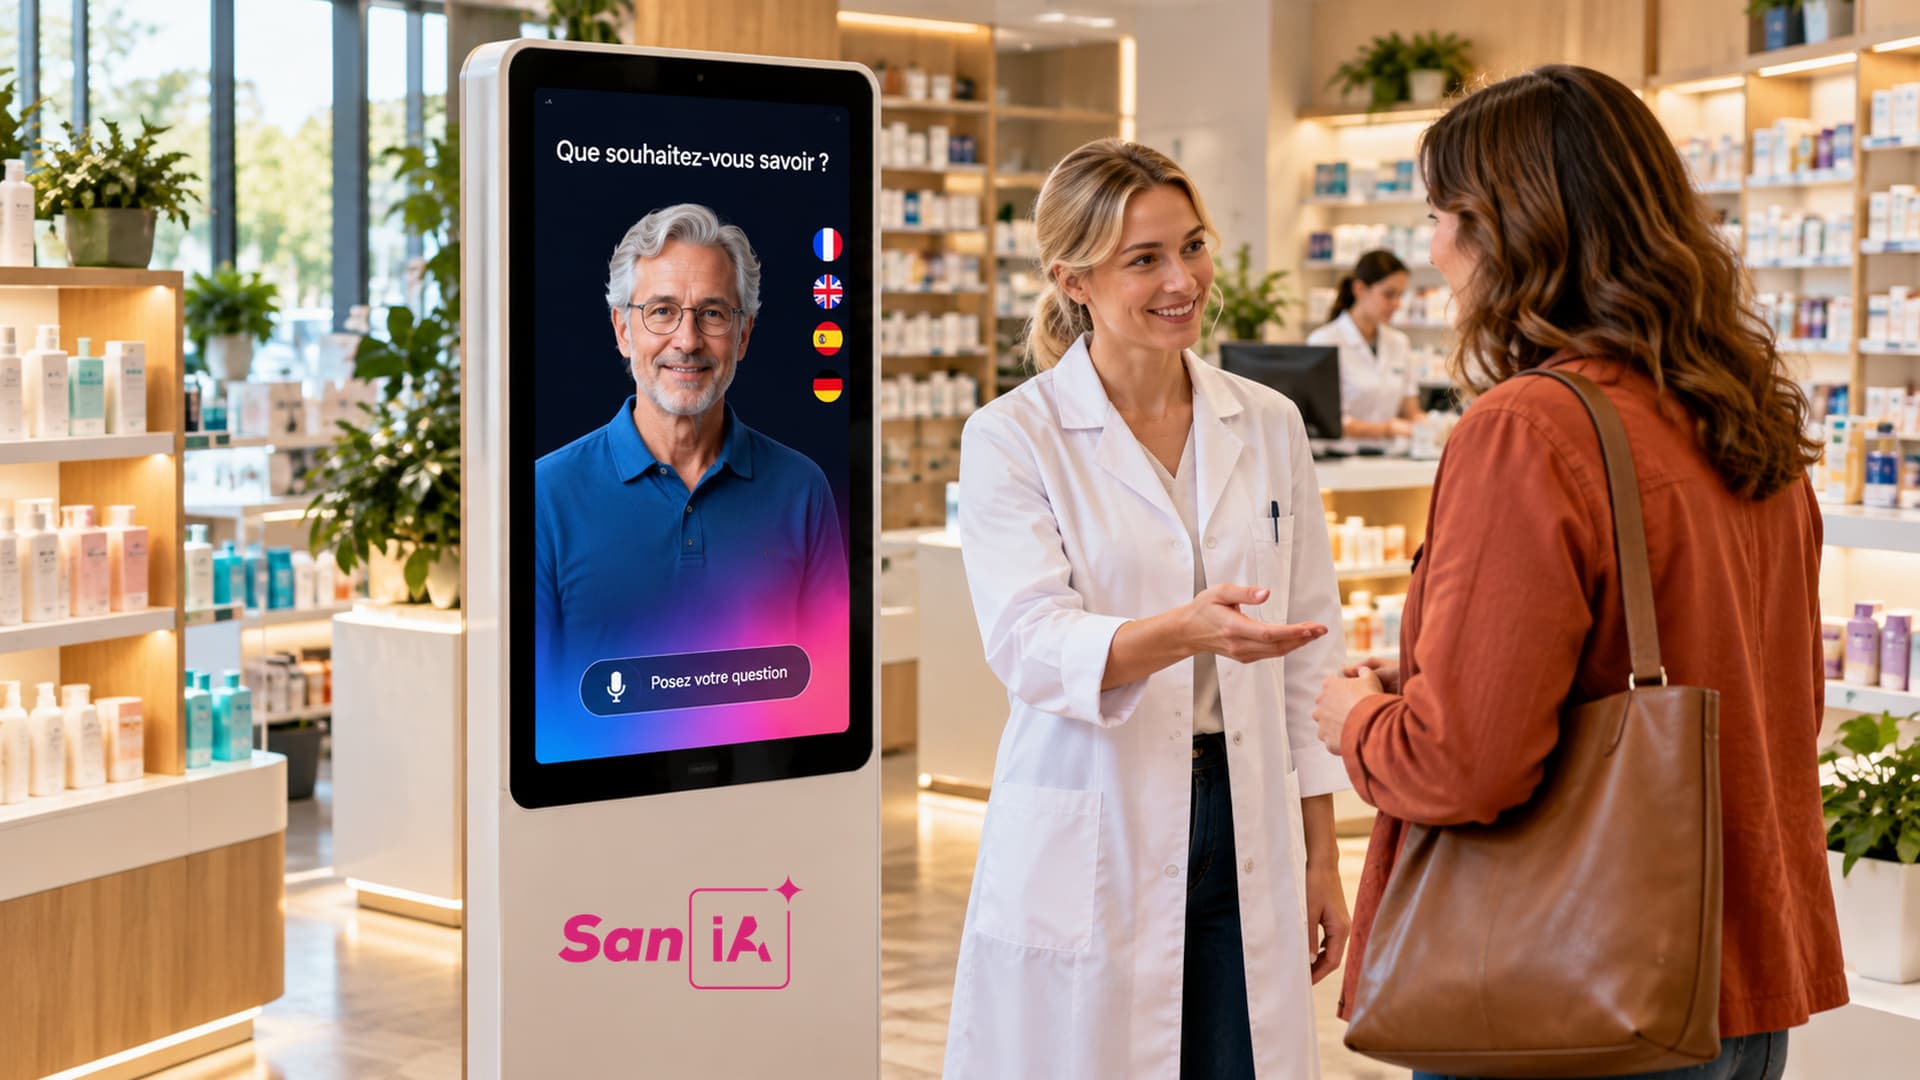
SANIA bietet ein professionelles konversationelles KI‑Avatar für Bildschirme oder interaktive Kioske mit sprachlicher und taktiler Interaktion je nach Konfiguration, verfügbar rund um die Uhr und fähig, in mehr als 100 Sprachen zu kommunizieren. Fordern Sie eine Demonstration an, um die für Ihren Bestand passende Architektur, die Folgen für RAG/Embeddings und einen maßgeschneiderten Pilotplan zu besprechen.