
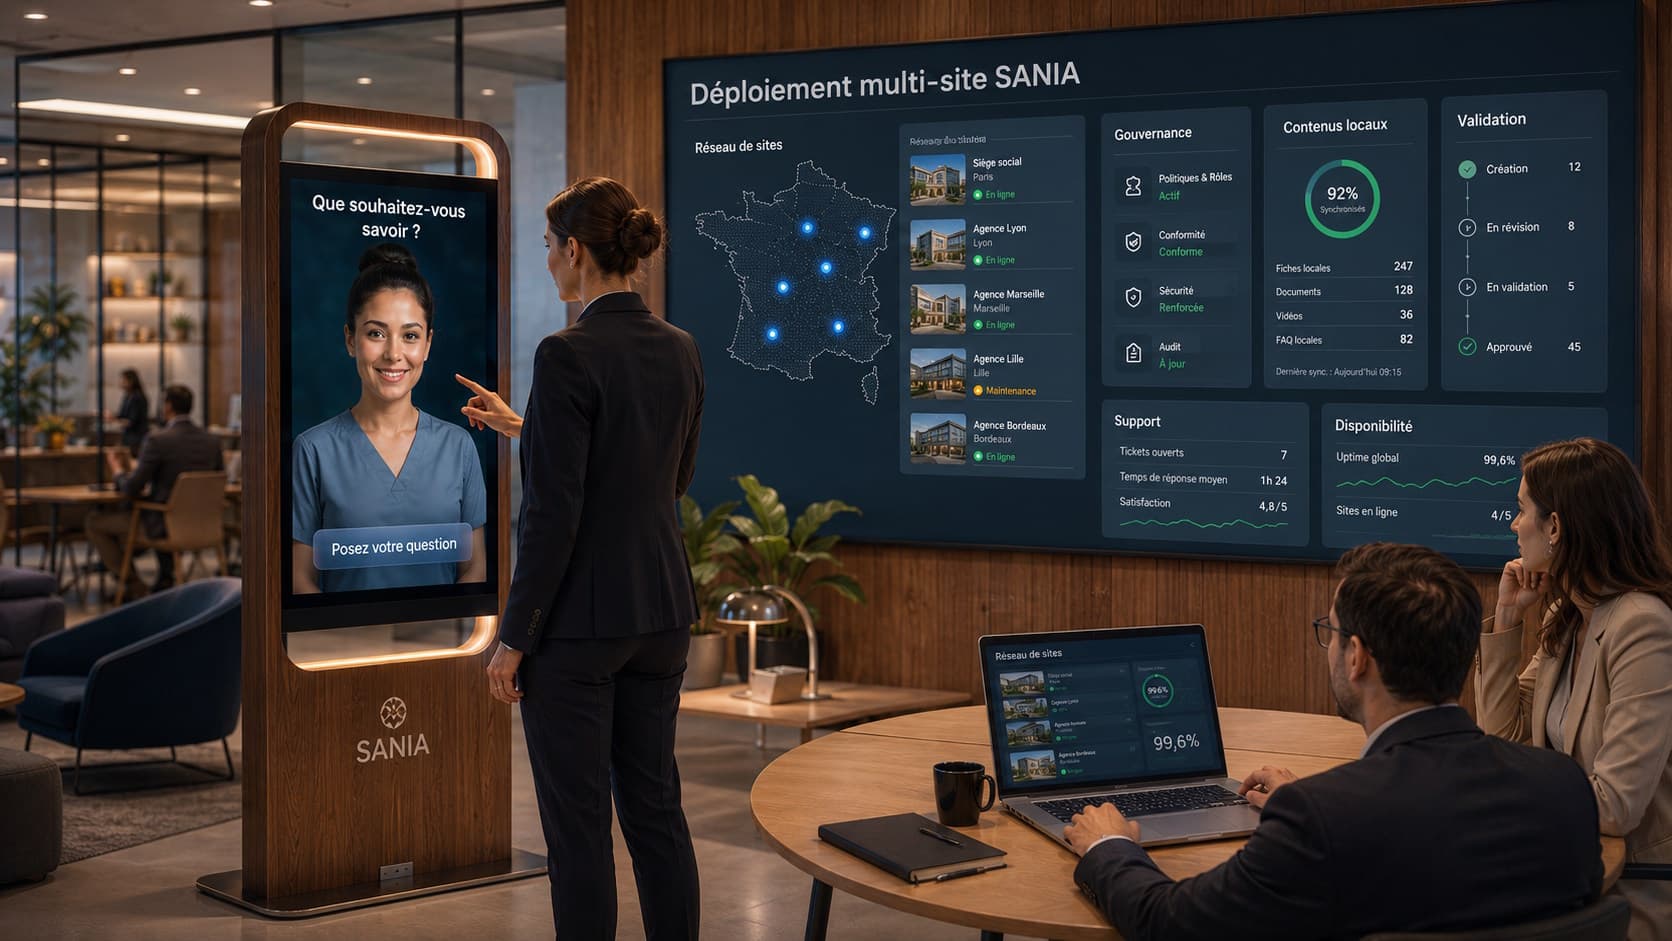
Introduction : pourquoi une observabilité pensée SRE pour un avatar IA physique
Ein auf einem Bildschirm oder Kiosk eingesetzter KI‑Avatar läuft in einer verteilten Umgebung, die lokale Komponenten (touch‑UI, Audio I/O, Peripheriegeräte) und Cloud‑ oder On‑Premise‑Dienste (ASR, LLM, TTS, RAG, fachliche Integrationen) kombiniert. Die Gewährleistung einer 24/7‑Verfügbarkeit und das rasche Erkennen von Leistungsverschlechterungen erfordern einen Observability‑Ansatz, der auf den Betrieb ausgerichtet ist, nicht nur auf die Entwicklung.
Dieses Handbuch bietet ein operatives Playbook zum Definieren geeigneter SLO und SLA, zum Aufbau end‑to‑end synthetischer Tests inklusive Touch‑ und Sprachpfaden, zum Design von nachvollziehbaren und privacy‑sicheren Logs, zum Einrichten actionabler Dashboards und Alerts sowie zur Organisation von Runbooks und On‑Call. Die Empfehlungen gelten für ein SANIA‑Deployment auf Bildschirm oder Kiosk und berücksichtigen projektspezifische Hardware‑ und Integrationsbesonderheiten.
Définir SLO et SLA pertinents avant toute supervision
SLO (Service Level Objectives) übersetzen, was ein für Nutzer und Organisation akzeptabler Service ist, in verwertbare Kriterien. SLA sind vertragliche oder interne Verpflichtungen, die auf diesen SLO aufbauen. Für einen KI‑Avatar im öffentlichen Raum ist es wichtig, SLO/SLA an die fachlichen Erwartungen und an die tatsächlichen technischen Möglichkeiten anzupassen.
Statt isolierte technische Metriken vorzugeben, strukturieren Sie die Ziele um die Nutzererfahrung: Verfügbarkeit des Sprach‑ und Touch‑Services vor Ort, vom Nutzer wahrnehmbare Antwortlatenz, Fähigkeit, über die Dokumentationsbasis eine relevante Antwort zu liefern, und Toleranz gegenüber Verschlechterungen bei Echtzeit‑Integrationen.
Kartieren Sie kritische Pfade (z. B. Besucherführung, Produktinformation, Zahlungsablauf falls vorhanden) und definieren Sie, welche Komponenten für jeden Pfad gemessen werden müssen.
Überführen Sie fachliche Erwartungen in beobachtbare Messgrößen: Verfügbarkeit, wahrgenommene Latenz, Rate an Fallbacks zu Fehlermeldungen oder zu menschlicher Hilfe, Aktualität der RAG‑Inhalte.
Dokumentieren Sie externe Abhängigkeiten (ASR, LLM, TTS, Fach‑APIs) und legen Sie fest, welche Servicelevel vertraglich sind und welche lediglich operativ überwacht werden.
Concevoir des tests synthétiques end-to-end qui couvrent tactile et vocal
Synthetic Monitoring ermöglicht das Erkennen von Regressionen, bevor sie viele Nutzer betreffen. Für ein interaktives Kiosk muss ein Testplan Touch‑Abläufe, vollständige Sprachinteraktionen (ASR -> LLM -> TTS) und Szenarien abdecken, die die RAG‑Dokumentenbasis oder externe APIs ansprechen.
Synthetische Tests können aus der Cloud, von einem On‑Prem‑Agent oder von Geräten vor Ort ausgeführt werden. Sie müssen die gesamte Interaktionskette realistisch nachbilden und nicht nur den technischen Erfolg prüfen, sondern auch eine minimale funktionale Qualität (z. B. nicht leere Antwort, keine technischen Fehler, akzeptable Latenz) verifizieren.
Touch‑Tests: Begrüßungsablauf, Menü‑Navigation, Bildschirmfolgen, Button‑Validierung und visuelle Darstellung.
End‑to‑end Sprachtests: Einspeisung einer Audiodatei oder simulierte Sprachausgabe, Überprüfung der ASR‑Transkription, Bewertung der vom LLM/RAG erzeugten Antwort, TTS‑Wiedergabe und Kontrolle der Audioausgabe.
Echtzeit‑Integrations‑Tests: Simulierte Aufrufe fachlicher APIs, Prüfung der Fehlercodes und des Verhaltens bei Nichtverfügbarkeit (kontrolliertes Degraden).
RAG‑Aktualitätstests: Gezielte Anfragen an kürzlich aktualisierte Dokumente, um zu prüfen, ob die zurückgegebene Dokumentbasis konsistent ist.
Concevoir des logs privacy-safe et traçables
Die Qualität der Logs ist entscheidend zur Diagnose eines Vorfalls. Gleichzeitig muss die Vertraulichkeit der Gespräche gewahrt und rechtliche Vorgaben eingehalten werden. Entwerfen Sie Logs, die für SRE‑Teams verwertbar bleiben und gleichzeitig personenbezogene Daten minimieren.
Verfolgen Sie klare Prinzipien: Trennen Sie betriebliche Metadaten von Benutzerinhalten, verwenden Sie nicht umkehrbare Korrelationskennungen und wenden Sie je nach Datenart und Projektkonfiguration geeignete Anonymisierungs‑ oder Pseudonymisierungsrichtlinien an.
Einen globalen Correlation‑ID für eine Session systematisch einbinden (korrelierbar zwischen lokaler UI, ASR, LLM, TTS und API‑Aufrufen).
Nützliche Diagnose‑Metadaten loggen: Zeitstempel, Latenzen pro Schritt, Fehlercodes, LLM‑Modellversion, Deployment‑ und Maschinen‑IDs.
Vermeiden, vollständige Transkripte oder Roh‑Audio ohne gerechtfertigten betrieblichen Bedarf zu speichern. Wenn Aufbewahrung für Analysen nötig ist, robuste Anonymisierungsmaßnahmen anwenden und die Aufbewahrungsdauer gemäß den DSGVO‑Entscheidungen des Projekts minimieren.
System‑Aktionsspuren und RAG‑Verarbeitungs‑Schritte (welche Dokumentquelle angefragt wurde) aufbewahren, ohne sensiblen Inhalt offenzulegen.
Corrélation multi-composants pour diagnostiquer ASR, LLM, TTS et intégrations
Ein scheinbar systemweiter Vorfall kann von einer einzelnen Komponente ausgehen: ein verschlechtertes ASR, ein LLM mit Performanceproblemen, Netzwerklatenz zu einer fachlichen API oder ein lokales Problem am Kiosk. Daher ist die Korrelation der Traces zwischen Komponenten unerlässlich, um die Root Cause schnell zu isolieren.
Entwerfen Sie Log‑ und Trace‑Pipelines, die eine vollständige Session‑Nachverfolgung ermöglichen. Nutzen Sie propagierte Correlation‑IDs in jedem Aufruf und speichern Sie Metadaten, die den ausgeführten Pfad und die Latenzen pro Schritt angeben.
Eingabe des Nutzers, an den ASR gesendete Anfrage, Weiterleitung an LLM/RAG, TTS‑Anfrage und finale Wiedergabe mit Latenz und Status für jeden Schritt nachverfolgen.
ID der Modell‑ oder Konfigurationsversionen (ASR model vX, LLM‑Routing, RAG‑Index) erfassen, um Rollbacks oder Regressionsanalysen nach Deployments zu erleichtern.
IDs externer API‑Anfragen und Antwortcodes aufbewahren, um Integrationsvorfälle bewerten zu können, ohne notwendigerweise die Nutzlast zu speichern.
Dashboards et alerting actionnables pour les équipes Ops
Dashboards müssen den Servicezustand verdichtet darstellen, um schnelle Entscheidungen zu ermöglichen. Sie sollten handlungsorientiert sein und mit klaren Alerts verknüpft werden, Lärm vermeiden und die Priorisierung von Vorfällen unterstützen.
Gestalten Sie differenzierte Alerts: solche, die sofortiges Eingreifen erfordern, und solche, die eine geplante Untersuchung auslösen. Dokumentieren Sie die erwartete Auswirkung für jeden Alert‑Typ zur Unterstützung des On‑Call.
Beispielansichten für Dashboards: Standort‑Kartierung und Kiosk‑Status, durchschnittliche Latenz pro Komponente, aggregierte ASR/LLM/TTS‑Fehlertraces, funktionaler Fallback‑Rate.
Empfohlene Alerts: Ausfall eines kritischen Dienstes (ASR/LLM/TTS), anhaltender Anstieg von Integrationsfehlern, wahrnehmbare Verschlechterung der Medienlatenz, Anomalien in der RAG‑Aktualität, die auf Content‑Drift hinweisen.
Bevorzugen Sie kontextreiche Alerts: korrelierte Logs, betroffene Schritte, letzter fehlgeschlagener synthetischer Test und operationelle Hinweise aus dem Runbook.
Runbook, on-call et procédures d'escalade adaptées aux avatars IA
Ein gutes Runbook ist pragmatisch und symptomzentriert. Für jeden Alert‑ oder Vorfalltyp dokumentieren Sie schnelle Diagnose‑Schritte, Prüfungen vor Ort und mögliche Maßnahmen zur Abschwächung.
Die On‑Call‑Organisation muss klare Rollen vorsehen: wer betreibt die lokale Infrastruktur, wer befragt Cloud‑Dienste, wer managt fachliche Integrationen. Verlassen Sie sich nicht auf unklare automatische Übergaben; dokumentieren Sie Kontaktpunkte und Kommunikationswege.
Aufbau eines Incident‑Runbooks: Symptombeschreibung, erste Prüfungen, zu konsultierende Konsolen/Kommandos, Methode zur Log‑Korrelation, temporäre Mitigationsmaßnahmen, Replikations‑ und Eskalationskriterien.
Prozeduren für schnelle Vor‑Ort‑Tests einbinden (kontrollierter Neustart, Netzwerkumschaltung, Prüfung der Audio/Touch‑Hardware) und Skripte zum Extrahieren korrelierter Logs.
Regelmäßige Übungen planen, um Runbooks zu validieren und die Reaktionsfähigkeit der Teams zu erhalten.
Stratégies de déploiement et pattern canary pour limiter les risques
Deployments kritischer Komponenten (neues LLM‑Modell, ASR‑Update, Änderung der RAG‑Pipeline) sollten das Risiko minimieren, den gesamten Bestand zu beeinträchtigen. Canary‑Deployment ist ein nützliches Muster: auf einem begrenzten Umfang deployen, Schlüsselindikatoren überwachen und schrittweise ausrollen, wenn keine Verschlechterung erkennbar ist.
Dokumentieren Sie Validierungskriterien für ein Canary und die Rollback‑Bedingungen. Dazu gehören Ergebnisse synthetischer Tests, beobachtete Fehlerquoten und das Ausbleiben verhaltensbezogener Alerts.
Validierungsphasen planen: Vorab‑Deployment im Testumfeld, Canary auf kleinem Umfang, progressiver Rollout mit verstärktem Monitoring.
Abbruchkriterien definieren: klare Alarmsignale, die Rollback oder Stopp des Rollouts auslösen.
Einfache, getestete Rollback‑Mechanismen vorbereiten, um bei Bedarf auf eine stabile Version zurückzukehren.
Checklist opérationnelle avant et après mise en production
Nachfolgend eine Checkliste zur Vorbereitung der Inbetriebnahme und zur Stabilisierung des laufenden Betriebs. Sie fasst Monitoring‑, Datenschutz‑, Test‑ und Verfahrensaspekte zusammen.
Diese Checkliste muss an das Projektkontext, die gewählte Architektur und die lokalen regulatorischen Vorgaben angepasst werden. Sie dient als Grundlage, um zu bestätigen, dass der Avatar für einen 24/7‑Betrieb bereit ist.
SLO/SLA validieren und in beobachtbare Metriken übersetzen.
Synthetische Tests einrichten, die Touch‑ und Sprachpfade abdecken, und deren automatisierte Ausführung prüfen.
Propagation von Correlation‑IDs und Trennung von Metadaten/Inhalten in den Logs konfigurieren.
Anonymisierungs‑ und Aufbewahrungsstrategie für Logs in Übereinstimmung mit den DSGVO‑Entscheidungen des Projekts definieren.
Operationelle Dashboards erstellen und actionbare Alerts mit zugehörigem Runbook konfigurieren.
On‑Call organisieren und eine Incident‑Übung durchführen, um Diagnose‑ und Rollback‑Prozeduren zu validieren.
Questions fréquentes (FAQ) : aspects pratiques
Q : Muss man stets Audio oder Transkription aufzeichnen, um einen Vorfall zu diagnostizieren? A : Nicht unbedingt. Metadaten, Statuscodes und anonymisierte Transkripte genügen für die Mehrheit der Diagnosen. Vollständige Aufzeichnungen sollten nur aufbewahrt werden, wenn eine spezifische Analyse dies erfordert und nach Prüfung rechtlicher und datenschutzbezogener Aspekte.
Q : Liefert SANIA von Haus aus Observability‑Metriken? A : Je nach Projektkonfiguration kann SANIA in Monitoring‑Tools integriert werden und fachliche Dokumente (PDF, DOCX, XLSX, TXT, CSV oder NDJSON für spezifische Workflows) nutzen. Nutzbare Metriken müssen durch die eingesetzten Komponenten und gewählten Integrationen exponiert oder gesammelt werden.
Q : Wie überprüft man die Aktualität von RAG‑Inhalten? A : Implementieren Sie gezielte synthetische Abfragen für kürzlich aktualisierte Dokumente und überwachen Sie sowohl die Antworten als auch die RAG‑Logs, die anzeigen, welche Quellen genutzt wurden, um bei Drift oder fehlender Aktualität zu alarmieren.
Pour aller plus loin
Der Aufbau einer kompletten Observability‑Lösung für einen KI‑Avatar erfordert enge Zusammenarbeit zwischen Produkt, Infrastruktur, Sicherheit und Betrieb. Passen Sie dieses Playbook an den technischen Umfang und die Projektauflagen an und bevorzugen Sie kurze Iterationen, um die SLO schrittweise zu stabilisieren.
SANIA lässt sich auf Bildschirm oder interaktivem Kiosk mit Touch‑ und/oder Sprachinteraktion einsetzen und kann eine fachliche Dokumentationsbasis für RAG‑Szenarien integrieren. Um die Anpassung dieses Playbooks an Ihr Deployment zu prüfen und eine operative Demo zu erhalten, können Sie eine Präsentation von SANIA und unseren Betriebs‑Workflows anfragen.