Einführung: warum ein präziser TCO unerlässlich ist
Die Entscheidung für einen Pilot oder ein Multi‑Site‑Rollout eines KI‑Avatars auf interaktivem Kiosk erfordert eine glaubwürdige Zahl, die von Geschäftsführung und IT akzeptiert wird. Die Kosten beschränken sich nicht auf den Kauf des Kiosks: sie umfassen Hardware‑Infrastruktur, LLM‑Lizenzen, Sprachsynthese und Spracherkennung, Konnektivität, Integration in Fachsysteme, 24/7‑Betrieb und Content‑Governance.
Dieser Beitrag bietet eine handlungsorientierte Methode zur Dekomposition dieser Kostenpositionen, zur Schätzung des Token‑Verbrauchs und zum Aufbau von Szenarien für Pilot / 10 / 100 Standorte. Ziel ist es, konkrete Orientierung für Budgetierung, Vertragsverhandlungen und Identifizierung von Optimierungshebeln zu liefern.
Die zu berücksichtigenden Kostenpositionen
Für einen vollständigen TCO bündeln Sie Ausgaben in CAPEX (Anschaffungen) und OPEX (laufende Kosten). Jede der folgenden Positionen sollte in Ihrer Budgettabelle erscheinen.
Hardware und Installation (CAPEX): Bildschirm oder interaktiver Kiosk, physische Halterung, Audio‑Gehäuse, geeignete Mikrofone und Lautsprecher, ggf. Schutzvorrichtungen und Netzwerkinstallation vor Ort. Berücksichtigen Sie Transport‑ und Installationskosten an den Standorten.
Software und Lizenzen (OPEX/CAPEX je nach Vertrag): Lizenz für die Avatar‑Software, Zugriffskosten auf LLM‑Engines (Token‑Abrechnung oder Abo), TTS‑ und ASR‑Lizenzen falls separat berechnet, Betriebssystem‑ oder Kiosk‑Anwendungs‑Lizenzen.
Integrationen und Entwicklung (CAPEX / initiales OPEX): Anpassung der Wissensbasis, API‑Entwicklung zur Anbindung von POS, Inventar oder CRM, Konfiguration des RAG und mehrsprachige Tests. Ziehen Sie juristische Inhaltsprüfungen für sensible fachliche Antworten mit ein. Diese Positionen decken auch UAT‑Tests und UX‑Anpassungen (Sprache/Touch) vor lokaler Produktion oder Pilot aus.
Laufende Betriebskosten, die zu budgetieren sind
Der Betrieb eines KI‑Avatars verursacht häufig unterschätzte laufende Kosten. Identifizieren und budgetieren Sie klar:
LLM‑Kosten: Abrechnung pro Token oder über Abonnement. Die Kosten hängen vom Anfragevolumen, der durchschnittlichen Prompt‑ und Antwortlänge sowie von der Preisstruktur des Anbieters ab. Je nach Architektur können mehrere LLMs orchestriert werden, um Qualität und Kosten auszutarieren.
Sprachkosten: TTS und ASR können per Minute, pro Anfrage oder per Abo berechnet werden. Spracherkennung in lauter Umgebung kann das Anfragevolumen (Re‑transmits, Retries) erhöhen — das ist zu berücksichtigen.
Konnektivität und Daten: Bandbreite für API‑Aufrufe, Kosten für redundante Verbindungen zur Sicherstellung der Verfügbarkeit, mögliche Speicher‑ und Transferkosten für Embeddings, wenn Vektoren cloud‑basiert oder on‑premises gespeichert werden, je nach RAG‑Konfiguration.
Schritt‑für‑Schritt‑Methode zur Schätzung des LLM‑Verbrauchs (operative Formel)
Statt Zahlen zu erfinden, definieren Sie messbare Variablen und wenden eine einfache Formel an. Die folgenden Schritte und die Formel sollten in Ihr Spreadsheet einfließen:
1. Verkehr messen oder schätzen: durchschnittliche Interaktionen pro Kiosk und Tag, getrennt nach Touch‑ und Sprachinteraktionen. 2. Durchschnittliche Token‑Größe einer Interaktion schätzen: Nutzer‑Prompt + Kontext an das LLM + generierte Antwort. 3. Tokens pro Interaktion multiplizieren mit Interaktionen über den gewünschten Zeitraum (Monat/Jahr). 4. Anbietertarif pro 1.000 Tokens (oder andere Einheit) anwenden.
Zusammenfassende Formel zur Implementierung: LLM‑Kosten (Periode) = (Interaktionen/Tag x Tage) x (durchschnittl. Tokens pro Interaktion / 1000) x (Preis pro 1000 Tokens).
Analog für TTS/ASR: die durchschnittliche Audiodauer pro Interaktion schätzen und mit dem Anbieterpreis (pro Minute oder pro Anfrage) multiplizieren.
Szenarien erstellen: Pilot, 10 Standorte, 100 Standorte (anpassbares Berechnungsmodell)
Statt konkreter Zahlen zu nennen, strukturieren Sie drei Szenarien in Ihrem Spreadsheet unter Verwendung der vorher definierten Variablen. Für jedes Szenario geben Sie an: Anzahl Einheiten (Kioske), geschätzter Traffic pro Kiosk, erforderliche Mehrsprachigkeit (Anzahl aktivierter Sprachen), Sprachmodus aktiv oder nicht, Architektur (Edge, Cloud, Hybrid) und erwartetes SLA‑Niveau.
CAPEX‑Kosten multiplizieren sich mit der Anzahl der Einheiten für Hardware und Installation, während bestimmte OPEX‑Posten Skaleneffekte aufweisen können (z. B. zentrale Lizenzen, gemeinsames Hosting, zentrales Monitoring). Tragen Sie in separaten Spalten ein: Einheit, Menge, Stückpreis (Anbieter), Periodizität, Perioden‑Total und annualisiertes Total.
Fügen Sie eine Spalte für „einmalige Integrationskosten“ pro Standort und eine für „zentralisierte Betriebskosten“ (Support, Inhalts‑Updates, Hosting der Embeddings) hinzu. Planen Sie zudem eine Zelle für Unvorhergesehenes und ein Sensitivitätsszenario bei Traffic‑Schwankungen oder Token‑Preissteigerungen ein.
Konkrete Hebel zur Kostenoptimierung
Mehrere technische und operative Entscheidungen beeinflussen den TCO deutlich. Die folgenden Hebel können Sie testen oder verhandeln:
Edge vs. Cloud: Lokale Verarbeitung bestimmter Anfragen reduziert LLM‑Aufrufe und Latenz, erhöht jedoch CAPEX und lokalen Wartungsaufwand. Ein hybrider Ansatz erlaubt es, komplexe Anfragen auszulagern und häufige FAQs lokal zu bedienen.
Cache und Vor‑Generierung: Häufige Antworten cachen oder statische Inhalte vorab generieren reduziert das Token‑Volumen beim LLM.
Multi‑LLM‑Orchestrierung: Anfragen mit geringer Komplexität an günstigere Modelle routen und Premium‑Modelle für anspruchsvolle Fälle reservieren.
Lokales TTS: Für häufige Interaktionen kann der Einsatz lokaler Stimmen (Edge‑TTS) die TTS‑Kosten senken, vorausgesetzt die Hardware‑ und Wartungskosten werden getragen.
Prompt‑ und RAG‑Optimierung: Die Wissensbasis so strukturieren, dass der an das LLM gesendete Kontext begrenzt wird. Eine gut gesteuerte semantische Suche kann unnötige Tokens reduzieren, bringt jedoch Speicher‑ und Aktualisierungskosten für Embeddings mit sich (on‑prem oder Cloud abhängig).
Vertragsklauseln und SLAs, die zu verhandeln sind
Verträge mit LLM‑Anbietern, TTS/ASR‑Anbietern, Avatar‑Herstellern oder Integratoren sollten spezifische Punkte abdecken, um Budget und Servicelevel abzusichern:
Preisstruktur und Abrechnungseinheit: Festlegung der fakturierten Einheit (Tokens, Anfragen, Minuten), Staffelpreise und Mechanismen für Overage.
Verfügbarkeitss‑SLA und Sanktionen: Definition des Verfügbarkeitsniveaus für die API und mögliche Sanktionen bei Ausfällen, die den Kiosk‑Service beeinträchtigen.
Leistungszusagen: Erwartete durchschnittliche Latenz für Antworten und TTS sowie maximal tolerierbare Zeiten bei Verschlechterung.
Support und Erreichbarkeit: Supportlevel (nur Geschäftszeiten vs. 24/7), Reaktionszeiten, Eskalationsprozesse und dedizierte Ansprechpartner.
Sicherheit und Datenverarbeitung: Pflichten zur Aufbewahrung, Löschung, Datenlokalisierung und Nutzungsbedingungen für bereitgestellte Fachinhalte (RAG, Embeddings).
Ausstiegs‑ und Portabilitätsklauseln: Kündigungsbedingungen, Zugriff auf exportierbare Daten und Modalitäten zur Übernahme der Wissensbasis bei Anbieterwechsel.
Beschaffungs‑Checkliste und zu erstellende Kalkulationstemplates vor RfP
Bevor Sie eine Ausschreibung starten oder Verhandlungen führen, bereiten Sie ein strukturiertes Dossier mit Ihren fachlichen Variablen und technischen Anforderungen vor:
Beschreibung der priorisierten Anwendungsfälle und erwartetes Volumen pro Kiosk (Stimme / Touch), zeitlich aufgeschlüsselt.
Liste notwendiger Integrationen (POS, Inventar, CRM) und Authentifizierungsanforderungen.
Mehrsprachigkeitsanforderungen und Qualitätsanforderungen an Stimmen (TTS) für jede Sprache.
Gewünschtes Verfügbarkeitsniveau und Frequenz der Wissensbasis‑Aktualisierungen.
Methodik zur Kostenschätzung, die Sie vom Anbieter erwarten (legen Sie Ihr Variablen‑Spreadsheet bei, um vergleichbare Angebote zu erhalten).
Nicht verhandelbare Vertragspunkte: Mindest‑SLA, Datensicherheit und Wiederanlauf im Austrittsfall.
Häufige Fragen (FAQ) für das Lenkungsgremium
F: Wie begründet man die Diskrepanz zwischen hohem CAPEX und niedrigeren OPEX auf lange Sicht? A: Stellen Sie mehrere Betrachtungshorizonte dar (annualisierter Gesamtkostenvergleich) und heben Sie die wichtigsten laufenden Kosten (LLM, TTS, Support) hervor. Das Gremium muss Break‑even‑Punkte und Hebel zur Veränderung verstehen.
F: Sollte man Edge bevorzugen, um LLM‑Kosten zu reduzieren? A: Edge kann bestimmte kostenpflichtige Modellaufrufe reduzieren, erfordert jedoch höhere Hardwareinvestitionen und lokalen Wartungsaufwand. Ein hybrider Ansatz ist oft pragmatischer: lokal einfache, wenig wertschöpfende Interaktionen verarbeiten und komplexe Fälle in die Cloud auslagern.
Weiterführende Schritte und nächste Maßnahmen
Um diesen Leitfaden in konkrete Zahlen zu überführen, laden Sie ein Spreadsheet mit den genannten Variablen herunter oder erstellen Sie eines und bitten Sie Ihre Anbieter, ihre Einheitspreise basierend auf Ihren geschätzten Nutzungsdaten auszufüllen. Testen Sie mindestens einen Pilotstandort, um durchschnittliche Tokens pro Interaktion zu messen und die 10/100‑Szenarien anzupassen.
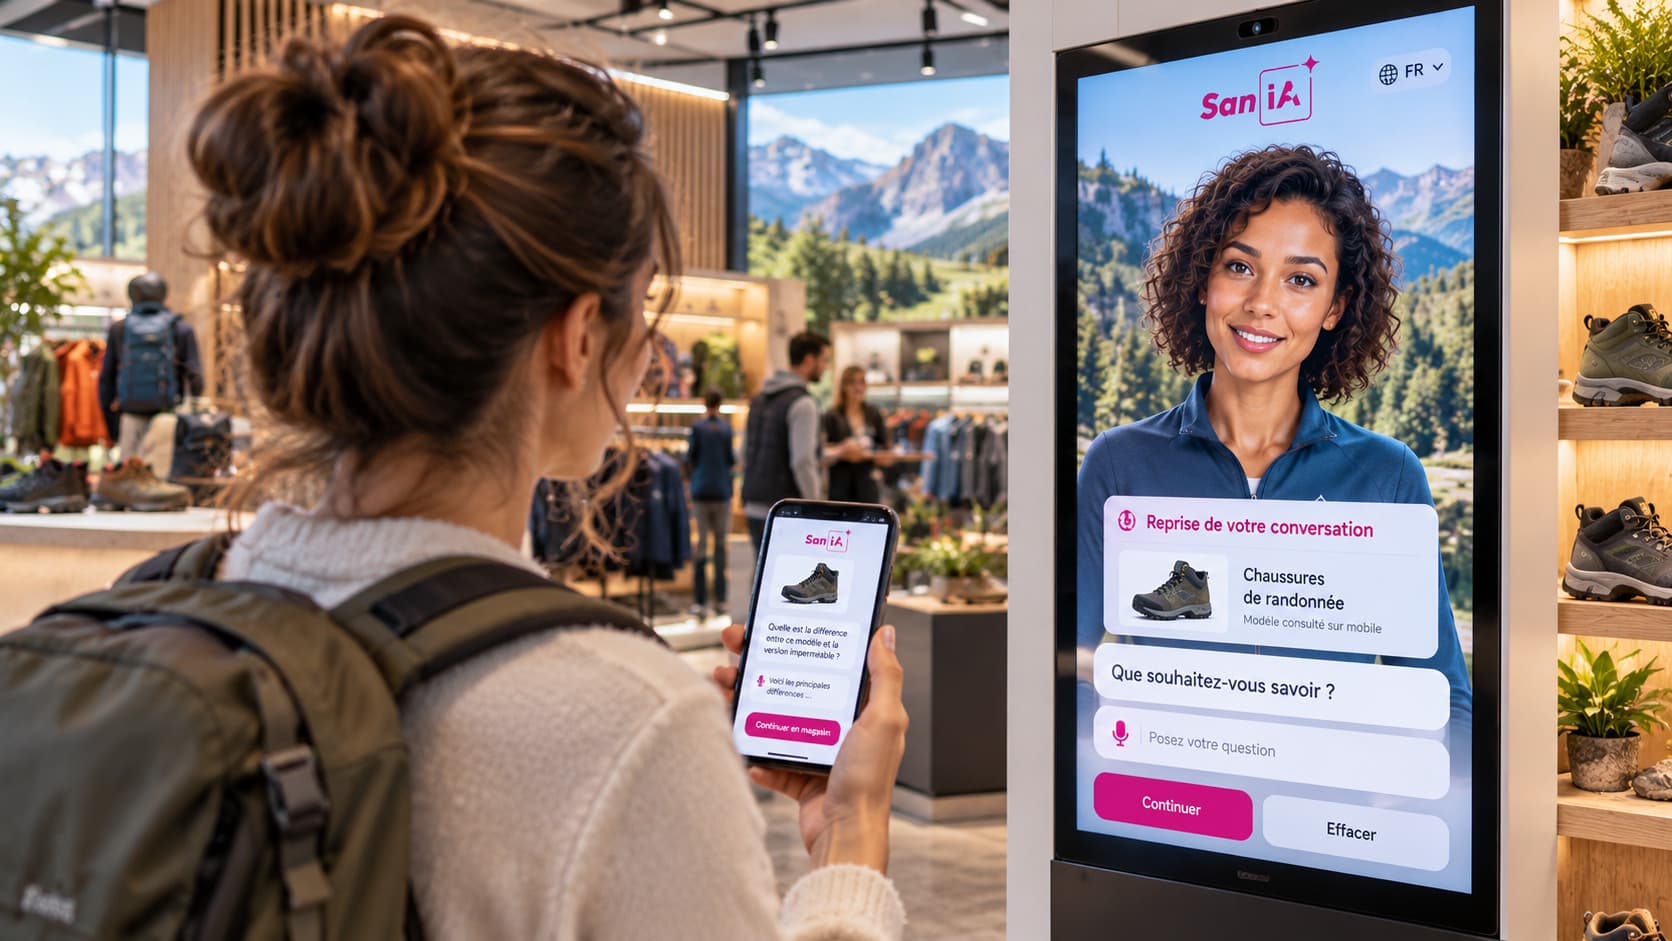
SANIA kann auf Bildschirm oder interaktivem Kiosk bereitgestellt werden, per Sprache und/oder Touch funktionieren und auf einer organisationsspezifischen Wissensbasis aufbauen. Um konkret zu prüfen, wie diese Entscheidungen Ihren TCO in Ihrem Kontext beeinflussen (Edge vs Cloud, Multi‑LLM‑Orchestrierung, TTS/ASR), können Sie eine Demonstration und ein auf Ihr Standortnetz zugeschnittenes Angebot anfordern.