Einleitung: Warum ein dediziertes UAT‑Protokoll für Avatar‑KI im Laden
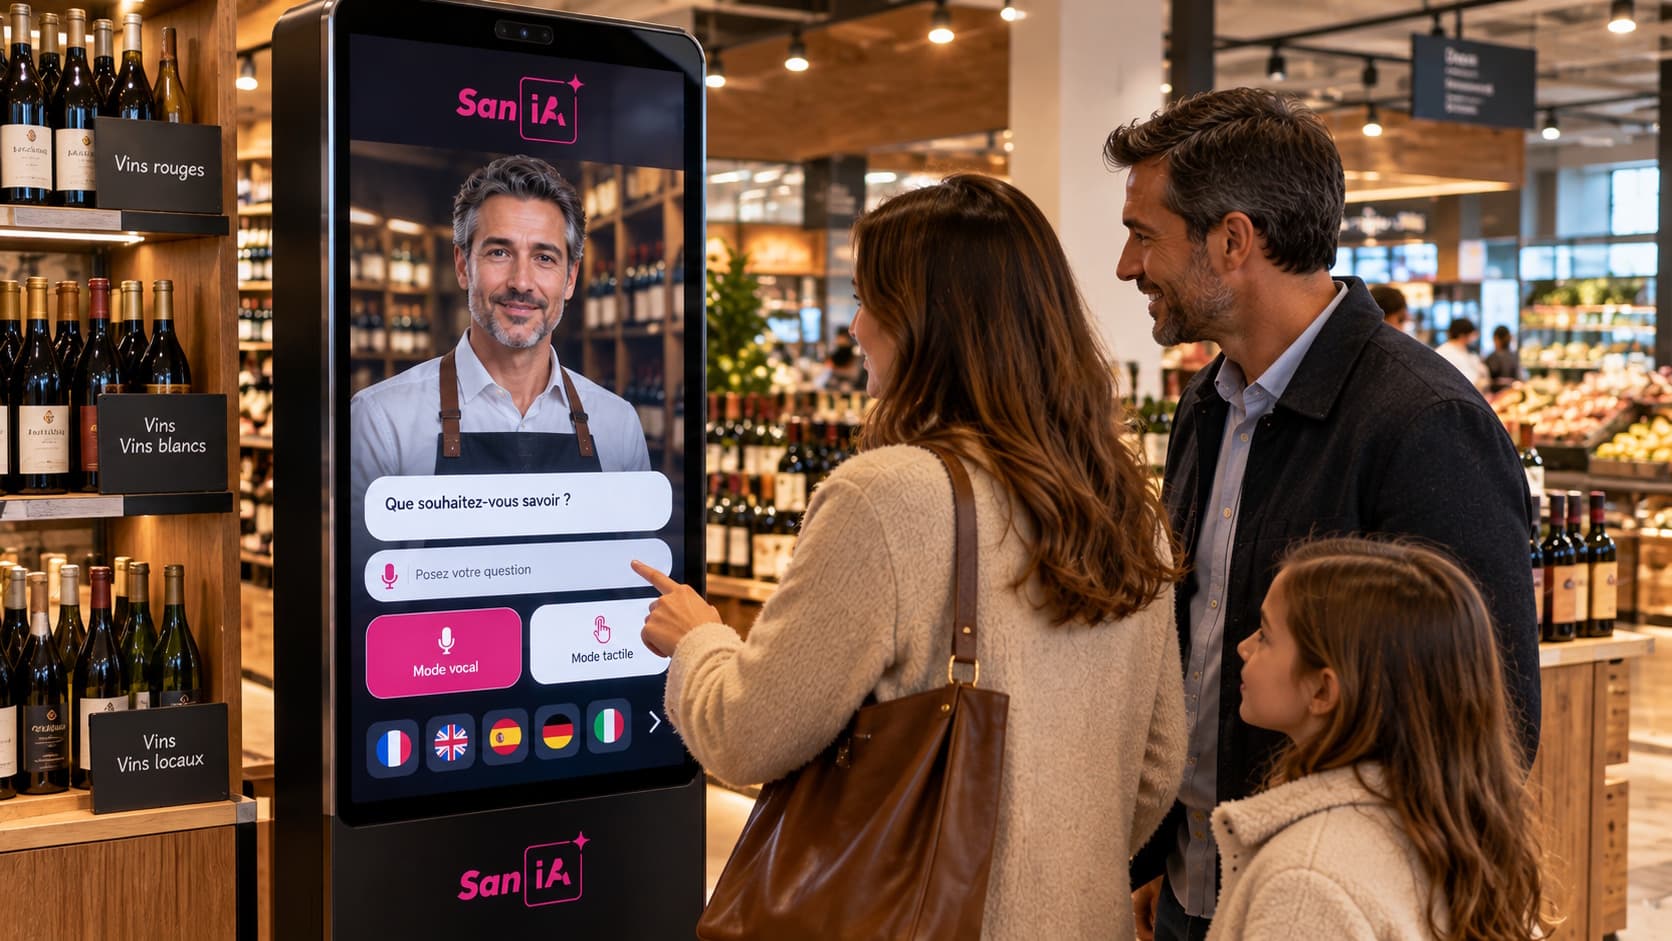
Ein Pilotprojekt mit einem Avatar‑KI an einem Kiosk oder Bildschirm muss unter realen Bedingungen nachweisen, dass das Erlebnis die geschäftlichen Ziele erfüllt: Empfang, Information, Orientierung und Wegweisung. Ein strukturiertes Benutzer‑ und Abnahmeprotokoll (UAT) verhindert Fehleinschätzungen durch isolierte technische Tests und stellt sicher, dass der Avatar mit echten Sprach‑ und Touch‑Interaktionen, in mehreren Sprachen und mit der fachlichen Dokumentationsbasis funktioniert.
Dieses Dokument schlägt ein sofort einsetzbares Protokoll vor: Definition von Zielen, typische Testszenarien, mehrsprachige Rekrutierungsmethode, beobachtbare Testskripts, qualitative und quantitative Kennzahlen, technische Checklisten und operationelle Go/No‑Go‑Kriterien. Relevante SANIA‑Punkte sind dort gekennzeichnet, wo sie im Pilot geprüft werden müssen.
Festlegung der geschäftlichen Ziele und des Umfangs des Piloten
Formalisieren Sie vor jedem Test die konkreten Ziele des Piloten. Diese müssen mit konkreten Nutzungsfällen verknüpft sein: Produktinformation, Orientierung im Laden, Beantwortung häufiger Fragen, mehrsprachiger Zugriff oder Weiterleitung an einen Service. Jedes Ziel wird in priorisierte Use Cases übersetzt, die die Grundlage für die Testszenarien bilden.
Präzisieren Sie den technischen und operativen Umfang: aktivierte Interaktionsmodi (Sprache, Touch oder beides), abzudeckende Sprachen, ggf. verfügbare Integrationen (Inventar, Öffnungszeiten, dynamische Anzeige), Umgebungsbedingungen (Lärm, Beleuchtung, Publikumsverkehr). Wichtige Unterscheidung: Was ist eine native Fähigkeit des Avatars und was erfordert eine spezifische Integration.
Typische Nutzerszenarien: Sprache, Touch und Mehrsprachigkeit
Erstellen Sie eine Reihe von Szenarien, die die häufigsten Wege und Fehlerfälle abdecken. Jedes Szenario muss das Nutzerziel, den Kontext, Voraussetzungen (Sprache, Verfügbarkeit einer Integration), das Nutzer‑Skript und die Kriterien für das Ergebnis enthalten. Variieren Sie die Szenarien nach: rein sprachlichen Interaktionen, reiner Touch‑Interaktion, gemischten Touch‑dann‑Sprache‑Abläufen und Sprachwechsel innerhalb einer Sitzung.
Beispiele für geschäftsrelevante Fälle: Produktinformation anfragen, eine Abteilung oder ein vorrätiges Produkt finden, Öffnungszeiten und Services erfragen, eine einfache regulatorische oder sicherheitsbezogene Frage sowie Anfragen, die eine Weiterleitung an Personal erfordern. Für mehrsprachige Tests sollten sowohl Muttersprachler als auch Nicht‑Muttersprachler einbezogen werden, um die Robustheit der ASR und die Formulierung der Antworten zu bewerten.
Beobachtbare Testskripts und Beobachtungsraster
Jede Testsitzung muss mit einem präzisen Skript durchgeführt werden und ein Beobachter füllt das Raster in Echtzeit aus. Das Raster dokumentiert folgende objektive Elemente: Initiierung (Zeit bis zum Beginn der Interaktion), ASR‑Verständnis (hat der Avatar die Anfrage korrekt transkribiert?), Relevanz der Antwort, Sprachklarheit und Lautstärke des TTS, Touch‑Ergonomie (Menüs, Bezeichnungen), wahrgenommene Latenz, Bedarf an Eskalation und vom Nutzer angegebene Zufriedenheit.
Ergänzen Sie diese Beobachtungen durch qualitative Notizen zu Intonation, wiederkehrenden Verwechslungen und unerwarteten Nutzeräußerungen. Ziel ist es, verwertbare Spuren zu erzeugen, um die Wissensbasis zu korrigieren, Prompts und Microcopy anzupassen oder ASR/TTS‑Parameter zu optimieren.
Felder des Beobachtungsrasters: Test‑ID, Szenario, Sprache, Modus (Sprache/Touch), beobachtete ASR‑Transkription, gegebene Antwort, Dauer der Interaktion, menschlicher Eingriff erforderlich, Status Erfolg/Fehler, Kommentare.
Rekrutierung der Teilnehmenden und Stichprobengröße
Die Rekrutierung sollte die Repräsentativität der tatsächlichen Besucher anstreben: demografische Profile, Vertrautheit mit dem Tool, gesprochene Sprachen und Nutzungspräferenzen (Touch oder Sprache). Priorisieren Sie Vielfalt statt reines Volumen, um problematische Nutzungsfälle und sprachliche oder kulturelle Verzerrungen zu erkennen.
Statt eine feste Zahl vorzuschreiben, organisieren Sie die Tests in Iterationen bis zum Punkt der qualitativen Sättigung: wenn dieselben wiederkehrenden Probleme auftauchen und kaum neue Beobachtungen hinzukommen, kann die initiale Testphase als abdeckend gelten. Dieses Prinzip vermeidet willkürliche Schwellenwerte und passt sich an die Besucherfrequenz und die Komplexität des getesteten Umfangs an.
Durchführung der Tests im Laden: Logistik und bewährte Vorgehensweisen
Planen Sie Sitzungen in Zeitfenstern mit repräsentativer Frequentierung. Bereiten Sie die Umgebung vor: deutliche Kennzeichnung des Tests, Hinweise zur Vertraulichkeit und Erlaubnisse, falls Aufnahmen gemacht werden. Erinnern Sie daran, dass die Erhebung personenbezogener Daten gemäß der geltenden Gesetzgebung zu behandeln ist und dass die SANIA‑Konfiguration von den von der Organisation gewählten Aufbewahrungsoptionen abhängt.
Begrenzen Sie während der Sitzung die Interventionen der Testperson, um das Verhalten nicht zu verzerren. Zeichnen Sie anonyme Beispiele der Interaktionen auf, wenn die Piloteinstellung dies erlaubt und Einwilligung vorliegt. Nutzen Sie das Beobachtungsraster, um objektive Metriken sowie unmittelbares qualitatives Feedback zu erfassen.
KPIs und Go/No‑Go‑Kriterien: Was messen und wie entscheiden
Wählen Sie eine begrenzte Menge quantitativer und qualitativer Indikatoren, die auf die Geschäftsziele ausgerichtet sind. Nützliche Dimensionen sind z. B.: vom Tester wahrgenommene Lösungsrate, Eskalationsrate zu menschlichem Eingriff laut Beobachtung, Qualität des ASR‑Verstehens in getesteten Sprachen, durchschnittlich wahrgenommene Latenz und unmittelbar angegebene Nutzerzufriedenheit. Legen Sie die Erfassungsmethoden fest: Beobachtungsraster, separates Kurzfeedback nach der Interaktion oder externe Instrumentierung je nach verfügbaren Integrationen.
Für Go/No‑Go‑Kriterien bevorzugen Sie leicht verständliche operationelle Regeln: Wenn die wichtigsten geschäftlichen Anfragen in den priorisierten Sprachen nicht zuverlässig gelöst werden, wenn ASR unter realen Bedingungen systematisch versagt oder wenn die Touch‑Schnittstelle den Zugriff auf essentielle Funktionen verhindert, kann der Pilot nicht zur nächsten Phase freigegeben werden. Vermeiden Sie universelle numerische Schwellen ohne Kontextualisierung: Diese Kriterien sind an Ambition und Kritikalität des Projekts anzupassen.
Technische Checkliste für den Piloten
Validieren Sie während des UAT die technischen Elemente, die das Erlebnis beeinflussen. Prüfen Sie insbesondere die Robustheit der ASR in den aktivierten Sprachen, die Qualität und Verständlichkeit des TTS, die Relevanz der Antworten aus der RAG‑Dokumentbasis, das Verhalten bei Fallbacks wenn die Dokumentation nicht ausreicht, sowie die wahrgenommene Latenz bei LLM‑Aufrufen oder Echtzeit‑Integrationen.
Für SANIA prüfen Sie während der Pilotphase: Umschaltfähigkeit zwischen Sprach‑ und Textmodus gemäß Konfiguration, Erhalt des Gesprächskontexts innerhalb einer Sitzung, konfigurierte Mehrsprachigkeit und Eignung der vom Unternehmen bereitgestellten Wissensbasis. Spezifische Integrationen mit Dritt‑Systemen sind als separate Entwicklungen zu behandeln und entsprechend zu testen.
Kurz‑Checklist: ASR (Tests unter realen Bedingungen pro Sprache), TTS (Verständlichkeit, Lautstärke), RAG (Relevanz und zitierte Quellen), Fehler‑ und Fallback‑Management, Latenz von LLM‑Aufrufen, kritische Integrationen getestet, 24/7‑Verfügbarkeit simuliert.
Eskalationsprozess und Umgang mit Fehlern in der Produktion
Definieren Sie im Voraus die Situationen, in denen der Avatar den Nutzer auffordert, Personal zu kontaktieren. Der Pilot muss diese Fälle dokumentieren, um Erlebnisabbrüche zu vermeiden: sensible regulatorische Fragen, Sicherheitsprobleme, Anfragen, die Zugriff auf geschützte Systeme erfordern, oder anhaltende Unverständnisse nach mehreren Versuchen.
Verlassen Sie sich nicht auf einen automatischen Transfermechanismus: Legen Sie Standardtexte fest, wie der Avatar den Nutzer informiert, und die Empfehlungslogik für die Weiterleitung an einen menschlichen Gesprächspartner. Das Playbook 'Zu einem menschlichen Agenten wechseln vom Avatar‑KI' kann als Referenz dienen, um diese operationalen Regeln zu formalisieren.
Exportierbare Vorlagen: Szenarien, Beobachtungsraster und Abnahmebericht
Zur Erleichterung der Durchführung finden Sie hier Vorlagen, die Sie in einer Tabellenkalkulation oder einem Erfassungstool reproduzieren können:
Szenario‑Template: ID | Szenarioname | Ziel | Sprache | Modus (Sprache/Touch) | Vorbedingung | Nutzerskript | Erwartetes Verhalten des Avatars | Erfolgs-/Fehlerkriterium | Anmerkungen.
Beobachtungsraster‑Template: Test‑ID | Szenario | Teilnehmer (Profil) | Sprache | Beginn der Interaktion | ASR‑Transkription | Gegebene Antwort | Dauer | Menschlicher Eingriff | Status | Detaillierte Kommentare.
Abnahmebericht‑Template: Kontext des Piloten | Getesteter Umfang | Zusammenfassung qualitativer Ergebnisse | Zusammenfassung technischer Ergebnisse | Blocking‑Punkte | Erforderliche Verbesserungen | Liste prioritärer Maßnahmen | Operationelle Empfehlung (Go / Go mit Vorbehalten / No‑Go).
SANIA‑spezifische Punkte, die im Piloten zu prüfen sind
Bei den von SANIA bestätigten Fähigkeiten prüfen Sie im Pilot: die konfigurierte mehrsprachige Kommunikation für relevante Sprachen, die Sprach‑ und Touch‑Interaktion gemäß gewählter Konfiguration, die Fähigkeit, den Kontext während einer Sitzung zu halten, sowie die Nutzung der vom Unternehmen bereitgestellten fachlichen Wissensbasis. Diese Elemente sind native oder konfigurierbare Komponenten, deren Qualität unter realen Bedingungen validiert werden muss.
Wenn das Projekt spezifische Integrationen (Inventar, Öffnungszeiten, POS) einschließt, behandeln Sie diese als separate Entwicklungen und testen Sie sie entsprechend. Ebenso ist die Nutzung personalisierter Stimmen oder Voice‑Cloning nur möglich, wenn Rechte und Einstellungen bereitgestellt sind und muss während des Piloten validiert werden.
Kurze FAQ
Wie misst man Zufriedenheit ohne native Instrumentierung? Eine Organisation kann Sofortzufriedenheit über eine kurze, separate Umfrage nach der Interaktion erfassen oder über das vom Beobachter ausgefüllte Raster. Diese Methoden sollten vor dem Pilot festgelegt werden.
Muss die gesamte Dokumentationsbasis in alle Sprachen übersetzt werden? Nein. SANIA kann, wenn entsprechend konfiguriert, in mehr als 100 Sprachen kommunizieren. Priorität sollten die geschäftskritischen Informationen und deren Qualität in den für Ihr Publikum relevanten Sprachen haben. Die Lokalisierungsstrategie hängt von Ihren Zielen und Ressourcen ab.