Introduction rapide : le bon compromis dépend de vos priorités
Le choix entre edge, cloud ou une architecture hybride pour déployer un avatar IA sur borne ou écran ne relève pas d'une mode technologique mais d'un arbitrage entre contraintes réelles : latence de la chaîne vocale, protection des documents métiers utilisés en recherche documentaire, coût d'exploitation multisite, capacités de maintenance 24/7 et tolérance aux pannes réseau. Ce guide propose un cadre décisionnel pragmatique, des patterns d'architecture concrets compatibles avec les familles d'OS et SoC couramment utilisées (Samsung Tizen, Android, Windows selon configuration), des scénarios métiers et une checklist pilote prête à l'emploi.
Matrice de critères pour comparer les architectures
Avant de choisir, positionnez vos priorités sur une matrice simple regroupant les dimensions suivantes : latence utilisateur (ASR, LLM, TTS), confidentialité et localisation des données (RAG et documents métiers), coût total de possession multi‑site, exploitabilité et maintenance 24/7, évolutivité et capacité à déployer des mises à jour de modèles ou de contenus.
Pour chaque dimension, identifiez si elle est un impératif, un compromis acceptable ou une priorité secondaire pour votre organisation. Par exemple, si l'accueil vocal en temps réel et sans délai perceptible est un impératif, la latence devient prioritaire et favorise une architecture edge-first ou hybride avec traitement vocal local. Si la confidentialité des documents internes prime, favorisez un traitement des embeddings et de la recherche documentaire en infrastructure contrôlée (edge ou cloud privé selon vos politiques).
Trois patterns d'architecture opérationnels
1) Edge-first : traitement vocal et RAG local prioritaires. Dans ce pattern, l'ASR et le TTS peuvent s'exécuter localement sur la borne (ou sur un serveur local proche) afin de minimiser la latence perceptible par l'utilisateur vocal. La recherche documentaire sensible (création d'embeddings et recherche sémantique) est hébergée localement ou dans un périmètre réseau contrôlé. Les LLMs de génération peuvent être hébergés localement si le matériel et les licences le permettent, ou appelés en cloud pour les demandes plus complexes en appliquant une politique de filtrage en local.
2) Cloud-first : centralisation et évolutivité. Le cloud accueille ASR, LLM, TTS et la base de connaissances RAG. Ce modèle simplifie la maintenance, facilite les mises à jour de modèles et réduit la charge sur les bornes. Il peut toutefois introduire une latence additionnelle et nécessite des garanties réseau robustes et des protections contractuelles sur la confidentialité des données transitant vers les services cloud.
3) Hybride partitionné : équilibre pragmatique. L'approche hybride répartit les composants selon la sensibilité et la latence attendue. Exemple de partitionnement : ASR et prétraitement audio en edge pour capter la parole rapidement, embeddings et recherche documentaire RAG en edge ou sur un cloud privé pour protéger les contenus métier, et LLM de génération en cloud pour bénéficier de capacités supérieures et de mises à jour fréquentes. Ce pattern facilite la résilience offline partielle : lorsque l'accès cloud est indisponible, l'avatar peut continuer à répondre aux cas courants à partir des connaissances locales.
Scénarios métiers et recommandations pratiques
Retail en zone urbaine : les magasins à forte affluence recherchent une interaction fluide et multilingue. Si l'usage principal est vocal en magasin et que la latence est sensible, privilégiez un pattern hybride avec ASR/TTS en edge et LLM en cloud. Protégez les contenus commerciaux sensibles (fiches produit, promotions) via segmentation RAG et chiffrement.
Accueil public et administration : la confidentialité des documents est souvent prioritaire. Une architecture edge-first ou hybride avec gestion documentaire locale permet de limiter les flux sortants tout en assurant une expérience vocale acceptable.
Événements et contextes temporaires : le déploiement rapide, la simplicité de maintenance et le coût peuvent aller en faveur d'une solution cloud-first, éventuellement couplée à des capacités de cache local pour assurer une dégradation contrôlée en cas de perte de réseau.
Multi-sites distribués : si vous déployez sur un grand parc hétérogène, tenez compte des capacités réseau locales, de la variété d'OS/SoC et de la gouvernance des données. Le pattern hybride facilite l'uniformisation fonctionnelle tout en autorisant des configurations locales adaptées aux contraintes de chaque site.
Impacts sur RAG et embeddings : confidentialité, fraîcheur et taille du corpus
La localisation du service RAG a un impact direct sur la confidentialité et sur la capacité à garantir des réponses à jour. Héberger l'index d'embeddings localement réduit les transferts de documents sensibles mais impose des processus de refresh et de maintenance distribuée. Placer les embeddings dans le cloud simplifie les mises à jour et l'industrialisation mais nécessite des garanties contractuelles et des mesures de chiffrement lors des transferts.
La stratégie d'actualisation des embeddings doit être pensée opérationnellement : définissez qui peut déclencher une mise à jour, quelle validation humaine est nécessaire et comment revenir à une version antérieure si une régression est détectée. Ces règles sont indépendantes du choix edge/cloud mais leur mise en oeuvre opérationnelle variera selon l'architecture choisie.
Mises à jour LLM, TTS et ASR en production : gouvernance et déploiement
La mise à jour des modèles et composants nécessite un workflow clair. Identifiez les rôles responsables du choix d'un modèle, des tests qualité et de la mise en production. Pour les composants cloud-first, les mises à jour peuvent être centralisées et déployées rapidement. Pour le edge, prévoyez un processus de distribution de binaires ou de conteneurs vers les bornes, des tests progressifs et un mécanisme de rollback.
Dans un pattern hybride, privilégiez des approches blue/green ou canary pour limiter le risque de régression sur un parc hétérogène. Documentez les tests à réaliser avant déploiement : latence perçue, qualité ASR en langues cibles, cohérence du TTS et adéquation des réponses générées avec la base métier.
Runbook de dégradation et stratégies de graceful fallback
Anticiper les pannes réseau ou les indisponibilités cloud en définissant des comportements de dégradation clairs. Exemple de règles opérationnelles : lorsque la connexion au service LLM est dégradée, basculer vers des réponses prédéfinies ou vers un sous-ensemble local de FAQ ; lorsque l'ASR cloud n'est pas accessible, utiliser un modèle local simplifié ou proposer l'interaction tactile ; si l'index RAG n'est plus joignable, indiquer à l'utilisateur que l'avatar continue de fournir des réponses générales et suggérer d'autres canaux pour les demandes sensibles.
Le runbook doit préciser les séquences d'alerte à l'exploitation, les vérifications de reprise et les actions humaines à mener. Il est important de ne pas prétendre à un transfert automatique vers un agent humain sans l'intégration et les processus appropriés : prévoyez plutôt les cas où l'avatar orientera l'utilisateur vers le personnel et décrivez comment l'équipe prendra la suite.
Checklist pilote opérationnel avant industrialisation
Avant d'élargir le déploiement, validez un pilote structuré couvrant les points suivants. Cette checklist tient compte des contraintes multilingues, de l'OS et des SoC cibles et de l'exploitation 24/7 :
Définir les priorités sur la matrice latence/confidentialité/coût/exploitabilité.
Choisir le pattern d'architecture (edge-first, cloud-first, hybride) et documenter le partitionnement des composants (ASR, TTS, LLM, RAG).
Valider le pipeline RAG : provenance des documents, anonymisation éventuelle, fréquence de refresh des embeddings et procédure de rollback.
Planifier les tests de latence et qualité ASR/TTS sur les langues cibles en condition réelle de bruit.
Mettre en place le runbook de dégradation et les playbooks d'alerte pour l'exploitation 24/7.
Définir le processus de mise à jour des modèles et les critères de test avant production pour edge et cloud.
Aspects opérationnels complémentaires : coût, maintenance et OS/SoC
Le coût total de possession dépend fortement de la taille du parc et du pattern choisi. Les architectures cloud-first peuvent réduire la complexité de maintenance locale mais entraîner des coûts récurrents liés aux appels modèles et au stockage centralisé. Les architectures edge-first augmentent la maintenance matérielle et logicielle sur site mais peuvent réduire les coûts opérationnels liés au trafic et améliorer la latence.
Sur le plan pratique, vérifiez la compatibilité avec les OS et environnements supportés par votre projet. SANIA peut être déployée sur des écrans professionnels Samsung dans leur environnement SoC/Tizen, via une application Android sur certaines plateformes compatibles ou dans des environnements Windows adaptés. Le choix influence le packaging des mises à jour et les contraintes d'exploitation.
Conclusion et suite pratique
Le bon choix dépend d'une combinaison de priorités : si la latence vocale et la protection des documents sont critiques, favorisez une approche edge-first ou hybride avec traitement local des flux sensibles ; si vous privilégiez la simplicité d'exploitation et l'évolutivité, une architecture cloud-first peut être préférable. Dans la majorité des cas multisite, l'architecture hybride partitionnée offre un compromis opérationnel intéressant.
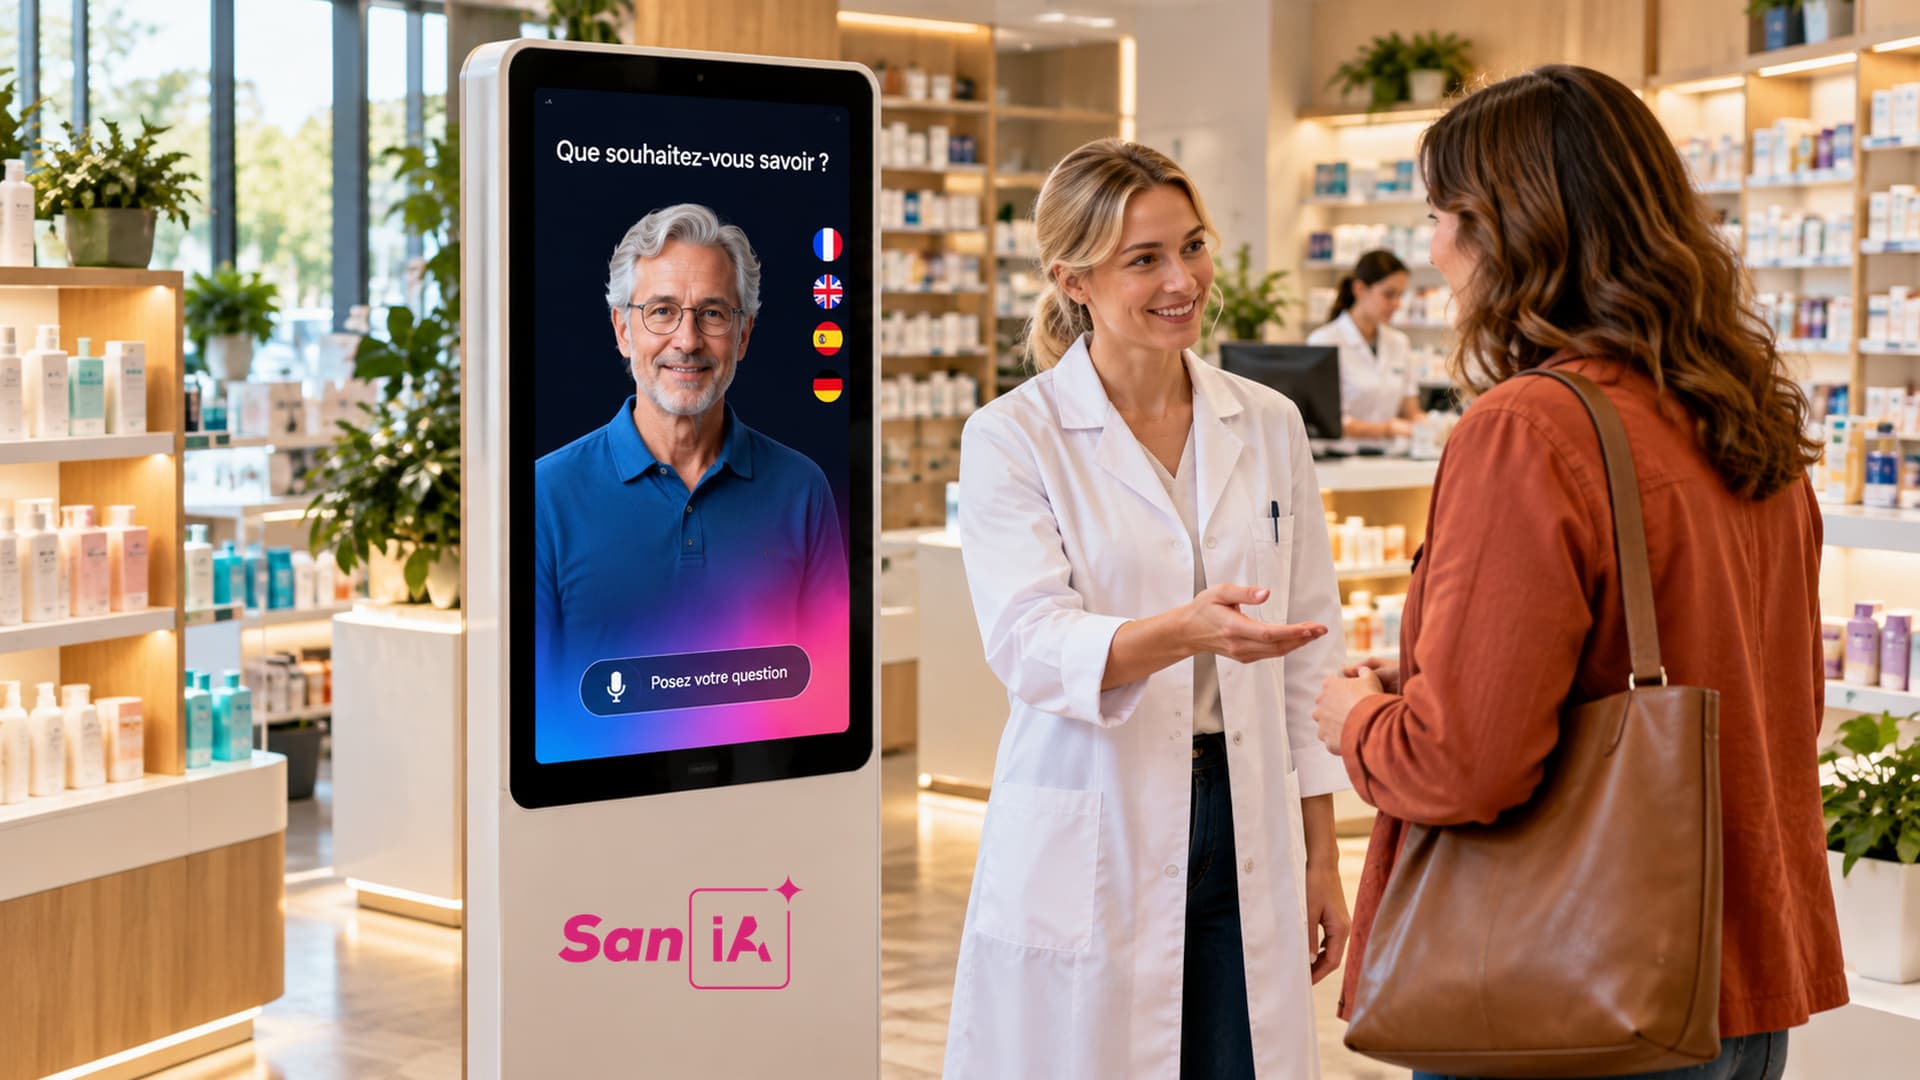
SANIA propose un avatar IA conversationnel professionnel utilisable sur écran ou borne interactive, avec interaction vocale et tactile selon configuration, disponible 24/7 et capable de communiquer dans plus de 100 langues. Pour évaluer concrètement l'architecture la mieux adaptée à votre parc, demandez une démonstration afin d'explorer les patterns d'intégration, les impacts sur RAG/embeddings et un plan pilote sur-mesure.