
Introduction : pourquoi une observabilité pensée SRE pour un avatar IA physique
Un avatar IA déployé sur écran ou borne fonctionne dans un environnement distribué qui combine composantes locales (UI tactile, audio I/O, périphériques) et services cloud ou on-premise (ASR, LLM, TTS, RAG, intégrations métier). Garantir une disponibilité 24/7 et une détection rapide des dégradations nécessite une approche d'observabilité conçue pour l'exploitation, pas uniquement pour le développement.
Ce guide propose un playbook opérationnel pour définir des SLO et SLA adaptés, construire des tests synthétiques end-to-end incluant les parcours tactiles et vocaux, concevoir des logs traçables et privacy-safe, mettre en place des dashboards et alertes actionnables, et organiser runbooks et on-call. Les recommandations sont applicables à un déploiement SANIA sur écran ou borne en tenant compte des spécificités matériel et intégrations du projet.
Définir SLO et SLA pertinents avant toute supervision
Les SLO (objectifs de niveau de service) servent à traduire en critères exploitables ce que signifie un service acceptable pour les utilisateurs et pour l’organisation. Les SLA sont des engagements contractuels ou internes qui reposent sur ces SLO. Pour un avatar IA en espace public, il est important d'aligner SLO/SLA avec les attentes métier et les capacités techniques réelles.
Plutôt que d'imposer des métriques techniques isolées, structurez les objectifs autour de l'expérience : disponibilité du service vocal et tactile sur site, latence de réponse perceptible par l'utilisateur, capacité à fournir une réponse pertinente via la base documentaire, et tolérance aux dégradations des intégrations temps réel.
Cartographier les parcours critiques (ex. orientation visiteur, information produit, scénario de paiement si présent) et définir quels composants doivent être mesurés pour chaque parcours.
Transposer les attentes métier en mesures observables : disponibilité, latence perçue, taux de fallback vers un message d'erreur ou vers une aide humaine, fraîcheur des contenus RAG.
Documenter les dépendances externes (ASR, LLM, TTS, APIs métier) et préciser quels niveaux de service sont contractuels et lesquels relèvent d’un monitoring d’exploitation.
Concevoir des tests synthétiques end-to-end qui couvrent tactile et vocal
Le synthetic monitoring permet de détecter des régressions avant qu'elles n'affectent massivement les usagers. Pour une borne interactive, un plan de tests synthétiques doit couvrir les parcours tactiles, les interactions vocales complètes (ASR -> LLM -> TTS), et les scénarios qui sollicitent la base documentaire RAG ou des APIs externes.
Les tests synthétiques peuvent être exécutés depuis le cloud, un agent on-premise ou depuis des dispositifs situés sur site. Ils doivent reproduire fidèlement la chaîne complète d'interaction et vérifier non seulement le succès technique mais aussi la qualité fonctionnelle minimale (par exemple, réponse non vide, absence d'erreur technique, latence acceptable).
Tests tactiles : parcours d'accueil, navigation des menus, enchaînement d'écrans, validation des boutons et rendu visuel.
Tests vocaux end-to-end : injection d'un fichier audio ou synthèse vocale simulée, vérification de la transcription ASR, évaluation de la réponse produite par le LLM/RAG, restitution TTS et check de la sortie audio.
Tests d’intégration temps réel : appels vers API métier simulés, vérification des codes d'erreur et comportement en cas d’indisponibilité (dégradation contrôlée).
Tests de fraîcheur RAG : requêtes ciblées sur documents mis à jour récemment pour vérifier que la base documentaire retournée est cohérente.
Concevoir des logs privacy-safe et traçables
La qualité des logs est essentielle pour diagnostiquer un incident. En parallèle, il faut garantir la confidentialité des conversations et respecter les obligations légales. Concevez des logs qui restent exploitables pour les équipes SRE tout en minimisant les données personnelles stockées.
Adoptez des principes clairs : séparer métadonnées opérationnelles des contenus utilisateur, utiliser des identifiants de corrélation non réversibles, et appliquer des politiques d'anonymisation ou de pseudonymisation adaptées selon la nature des données et la configuration du projet.
Inclure systématiquement un correlation id global pour une session (corrélable entre UI locale, ASR, LLM, TTS, et appels API).
Loguer les métadonnées utiles aux diagnostics : timestamps, latences par étape, codes d’erreur, version du modèle LLM, identifiants de déploiement et de machine.
Éviter de stocker la transcription complète ou l’audio brut sans besoin opérationnel justifié. Lorsque la conservation est nécessaire pour l'analyse, appliquer robustes mesures d'anonymisation et minimiser la durée de rétention en conformité avec les décisions RGPD du projet.
Conserver les traces d'actions système et d'étapes de traitement RAG (quelle source documentaire a été sollicitée) sans exposer le contenu sensible lui-même.
Corrélation multi-composants pour diagnostiquer ASR, LLM, TTS et intégrations
Un incident apparentement global peut provenir d’un seul composant : un ASR dégradé, un moteur LLM en dégradation, une latence réseau sur une API métier, ou un problème local sur la borne. La corrélation des traces entre composants est donc indispensable pour isoler rapidement la cause racine.
Concevez des pipelines de logs et traces qui permettent de remonter une session complète. Utilisez des correlation ids propagés à travers chaque appel et conservez des métadonnées qui indiquent le chemin exécuté et les latences par étape.
Tracer l’entrée utilisateur, la requête envoyée au service ASR, la transmittation vers le LLM/RAG, la requête TTS et la restitution finale, avec latence et statut pour chaque étape.
Inclure l’ID de version des modèles ou configurations (ASR model vX, LLM routing, index RAG) pour faciliter les rollbacks ou l’analyse de régressions post-déploiement.
Conserver les identifiants des requêtes API externes et les codes de réponse pour évaluer les incidents d’intégration sans nécessairement stocker la charge utile.
Dashboards et alerting actionnables pour les équipes Ops
Les dashboards doivent synthétiser l’état du service pour permettre une prise de décision rapide. Ils doivent être orientés vers l’action et reliés à des alertes claires, évitant les bruitages et favorisant la priorisation des incidents.
Concevez des alertes différenciées : celles qui nécessitent une intervention immédiate et celles qui appellent une investigation planifiée. Documentez le niveau d'impact attendu pour chaque type d'alerte afin de guider l'on-call.
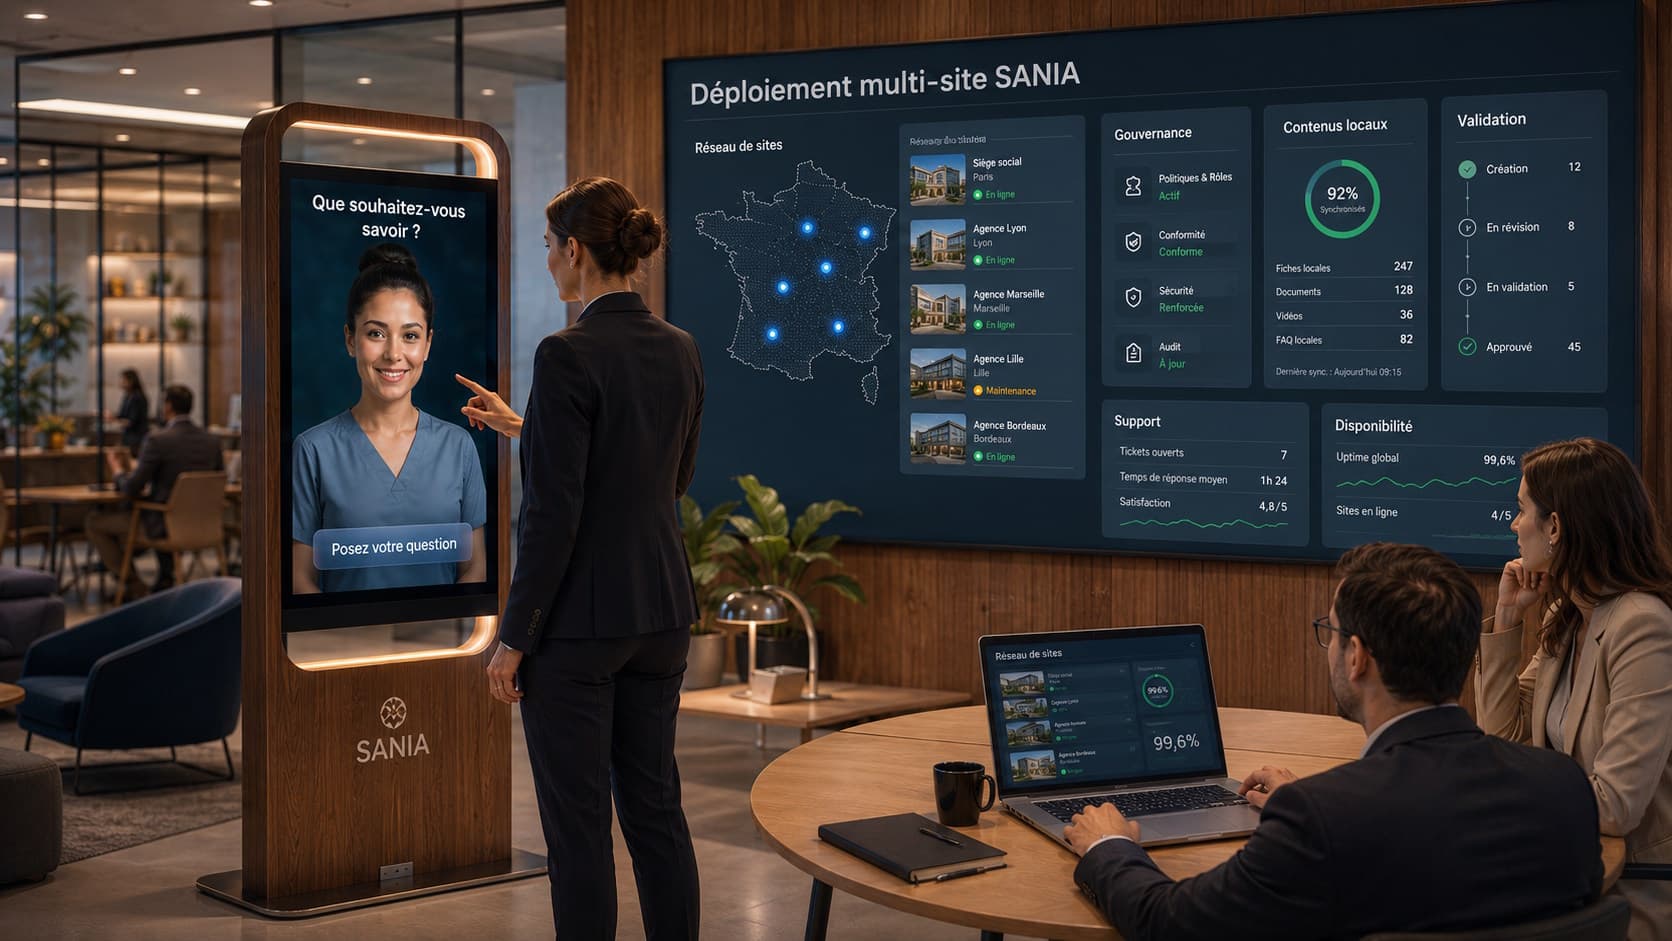
Exemples de vues Dashboard : cartographie des sites et statut des bornes, latence moyenne par composant, traces d’erreurs ASR/LLM/TTS agrégées, taux de fallback fonctionnel.
Alertes recommandées : indisponibilité d’un service critique (ASR/LLM/TTS), augmentation soutenue des erreurs d’intégration, dégradation de la latence média perceptible, anomalies dans la fraîcheur RAG indiquant un drift de contenu.
Privilégier des alertes avec contexte enrichi : logs corrélés, étapes affectées, dernier test synthétique ayant échoué, et suggestions opérationnelles issues du runbook.
Runbook, on-call et procédures d'escalade adaptées aux avatars IA
Un bon runbook doit être pragmatique et centré sur les symptômes observables. Pour chaque alerte ou incident type, documentez les étapes de diagnostic rapide, les vérifications à réaliser sur site et les actions d’atténuation possibles.
L’organisation on-call doit prévoir des rôles clairs : qui opère sur l’infrastructure locale, qui interroge les services cloud, qui gère les intégrations métier. Évitez de compter sur des transferts automatiques non définis dans le projet ; documentez les points de contact et les modes de communication.
Structure d’un runbook d’incident : description du symptôme, premières vérifications, commandes ou consoles à consulter, méthode de corrélation des logs, actions de mitigation temporaires, critères de repli et d’escalade.
Inclure des procédures pour tests rapides sur site (redémarrage contrôlé, bascule réseau, vérification matériel audio/tactile) et des scripts d'extraction de logs corrélés.
Prévoir des exercices réguliers pour valider les runbooks et maintenir la réactivité des équipes.
Stratégies de déploiement et pattern canary pour limiter les risques
Les déploiements de composants critiques (nouveau modèle LLM, mise à jour d’ASR, changement de pipeline RAG) doivent minimiser le risque d'impacter l'ensemble du parc. Le canary deployment est un pattern utile : déployer sur un périmètre limité, surveiller les indicateurs clés, puis étendre progressivement si aucun signe de dégradation n’apparaît.
Documentez les critères de validation d’un canary et les conditions de rollback. Cela inclut les résultats des tests synthétiques, les taux d'erreurs observés et l'absence d'alertes comportementales.
Planifier des phases de validation : pré-déploiement en environnement de test, canary sur un petit périmètre, déploiement progressif avec monitoring renforcé.
Définir des critères d’arrêt : signaux d’alerte clairs qui déclenchent le rollback ou l’arrêt du rollout.
Préparer des mécanismes de rollback simples et testés pour revenir à une version stable si nécessaire.
Checklist opérationnelle avant et après mise en production
Voici une liste de contrôle destinée à préparer la mise en production et à stabiliser l’exploitation continue. Elle regroupe aspects monitoring, confidentialité, tests et procédures humaines.
Cette checklist doit être adaptée au contexte du projet, à l’architecture choisie et aux obligations réglementaires locales. Elle sert de base pour valider que l’avatar est prêt pour un fonctionnement 24/7.
Valider les SLO/SLA définis et les traduire en métriques observables.
Mettre en place les tests synthétiques couvrant les parcours tactiles et vocaux et vérifier leur exécution automatisée.
Configurer la propagation de correlation ids et la séparation métadonnées/contenus dans les logs.
Définir la politique d’anonymisation et de rétention des logs en conformité avec les décisions RGPD du projet.
Créer dashboards opérationnels et configurer alertes actionnables avec runbook associé.
Organiser l’on-call et effectuer un exercice d’incident pour valider les procédures de diagnostic et de rollback.
Questions fréquentes (FAQ) : aspects pratiques
Q : Faut-il toujours enregistrer l’audio ou la transcription pour diagnostiquer un incident ? R : Pas nécessairement. Les métadonnées, les codes de statut et les transcriptions anonymisées peuvent suffire pour la majorité des diagnostics. L’enregistrement complet ne doit être conservé que si une analyse spécifique l’exige et après validation des aspects juridiques et de confidentialité.
Q : SANIA fournit-elle nativement des métriques d’observabilité ? R : Selon la configuration du projet, SANIA peut être intégrée à des outils de monitoring et exploiter des documents métier (PDF, DOCX, XLSX, TXT, CSV, ou NDJSON pour workflows spécifiques). Les métriques utiles doivent être exposées ou collectées via les composants déployés et les intégrations choisies.
Q : Comment vérifier la fraîcheur des contenus RAG ? R : Mettre en place des requêtes synthétiques ciblées sur documents récents et monitorer les réponses ainsi que les logs RAG indiquant quelles sources ont été sollicitées, afin d’alerter en cas de drift ou d’absence de documents à jour.
Pour aller plus loin
La mise en place d’un dispositif d’observabilité complet pour un avatar IA demande une collaboration étroite entre équipes produit, infrastructure, sécurité et exploitation. Adaptez ce playbook au périmètre technique et aux obligations du projet, et privilégiez des itérations courtes pour stabiliser progressivement les SLO.
SANIA peut être exploitée sur écran ou borne interactive avec interaction tactile et/ou vocale selon la configuration, et intégrer une base documentaire métier pour les scénarios RAG. Pour étudier l’adaptation de ce playbook à votre déploiement et recevoir une démonstration opérationnelle, vous pouvez demander une présentation de SANIA et de nos workflows d’exploitation.