Introduction : pourquoi un protocole UAT dédié aux avatars IA en magasin
Un pilote d'avatar IA sur borne ou écran doit prouver en conditions réelles que l'expérience remplit les objectifs métier : accueil, information, orientation et guidage. Un protocole de test utilisateur et d'acceptation (UAT) structuré permet d'éviter les illusions produites par tests techniques isolés et de s'assurer que l'avatar fonctionne avec de vraies interactions vocales et tactiles, dans plusieurs langues, et avec la base documentaire métier.
Ce document propose un protocole prêt à l'emploi : définition d'objectifs, scénarios de test types, méthode de recrutement multilingue, scripts observables, indicateurs qualitatifs et quantitatifs à suivre, checklists techniques et critères opérationnels go/no-go. Les éléments SANIA pertinents sont clairement indiqués lorsqu'ils doivent être vérifiés pendant le pilote.
Définir les objectifs métier et périmètre du pilote
Avant tout test, formalisez les objectifs concrets du pilote. Ils doivent être liés à des usages précis : prise d'information produit, orientation en magasin, réponse à des questions fréquentes, accès multilingue ou guidage vers un service. Chaque objectif se traduit par des cas d'usage priorisés qui serviront de base aux scénarios de test.
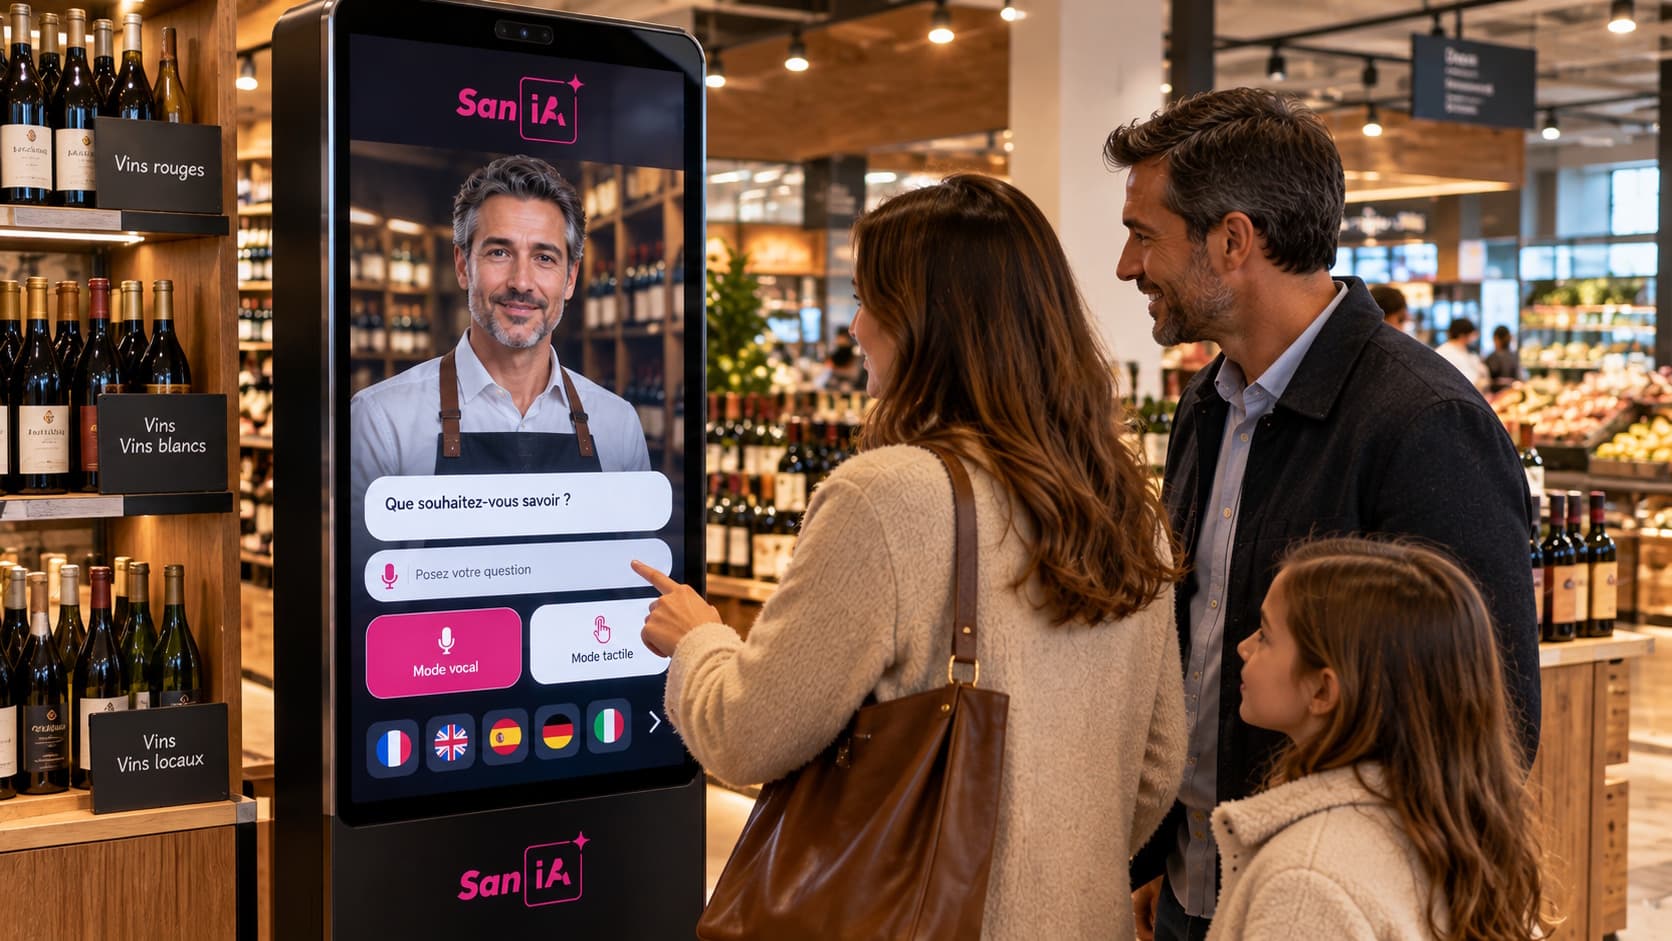
Précisez le périmètre technique et opérationnel : modes d'interaction activés (voix, tactile, ou les deux), langues à couvrir, intégrations éventuellement disponibles (inventaire, horaires, affichage dynamique), contraintes d'environnement (bruit, luminosité, circulation). Distinction importante : ce qui relève d'une capacité native de l'avatar et ce qui nécessitera une intégration spécifique.
Scénarios utilisateur types : voix, tactile et multilingue
Construisez un jeu de scénarios couvrant les parcours les plus fréquents et les situations d'échec. Chaque scénario doit inclure l'objectif utilisateur, le contexte, les prérequis (langue, disponibilité d'une intégration), le script de l'utilisateur et les critères d'issue. Variez les scénarios selon : interactions purement vocales, interaction tactile seule, parcours mixte tactile puis vocal, et basculement de langue en cours de session.
Exemples de cas métier à inclure : demande d'information produit, recherche d'un rayon ou d'un produit en stock, demande d'horaires et services, question réglementaire ou sécurité simple, et demande nécessitant orientation vers un personnel humain. Pour les tests multilingues, inclure des locuteurs natifs et des locuteurs non natifs afin d'évaluer la robustesse de l'ASR et de la formulation des réponses.
Scripts de test observables et grille d'observation
Chaque session de test doit être conduite avec un script précis et une grille d'observation remplie en temps réel par le testeur. La grille documente les éléments objectifs suivants : initiation (temps pour commencer l'interaction), compréhension ASR (l'avatar a-t-il transcrit correctement la requête?), pertinence de la réponse, clarté vocale et volume TTS, ergonomie tactile (menus, libellés), temps de latence perçu, besoin d'escalade et satisfaction déclarée de l'utilisateur.
Complétez ces observations par notes qualitatives sur l'intonation, les confusions récurrentes et les expressions utilisateur non prévues. L'objectif est de produire des traces exploitables pour corriger la base documentaire, ajuster prompts et microcopy, ou améliorer les paramètres ASR/TTS.
Champ de la grille d'observation : ID test, scénario, langue, mode (voix/tactile), transcription ASR observée, réponse fournie, durée interaction, intervention humaine nécessaire, statut réussite/échec, commentaires.
Recrutement des participants et taille d'échantillon
Le recrutement doit viser la représentativité des visiteurs réels : profils démographiques, niveaux de familiarité avec l'outil, langues parlées et comportements d'usage (préférence tactile ou vocale). Priorisez la diversité plutôt que le volume brut pour repérer les cas d'usage problématiques et les biais linguistiques ou culturels.
Plutôt que d'imposer un nombre fixe, organisez les tests par itérations jusqu'au point de saturation qualitative : lorsque les mêmes problèmes récurrents émergent et que peu de nouvelles observations sont apportées, la phase de test initiale peut être considérée comme couvrante. Ce principe évite de proposer un seuil arbitraire et s'adapte à la fréquentation et la complexité du périmètre testé.
Exécution des tests en magasin : logistique et bonnes pratiques
Planifiez des sessions durant des plages représentatives de fréquentation. Préparez l'environnement : signalétique claire indiquant qu'il s'agit d'un test, consignes de confidentialité, et autorisations si des enregistrements sont réalisés. Rappelez que la collecte de données personnelles doit être traitée selon la réglementation applicable et que la configuration de SANIA dépendra des options de conservation choisies par l'organisation.
Pendant la session, limitez les interventions du testeur pour ne pas biaiser le comportement. Enregistrez des exemplaires anonymisés des interactions si la configuration du pilote le permet et que le consentement est obtenu. Utilisez la grille d'observation pour collecter des mesures objectives et des retours qualitatifs immédiats.
KPIs et critères go/no-go : quoi mesurer et comment décider
Sélectionnez un jeu limité d'indicateurs quantitatifs et qualitatifs alignés sur les objectifs métier. Exemples de dimensions utiles : taux de résolution perçue par les testeurs, taux d'escalade vers une intervention humaine identifiée par observation, qualité de la compréhension ASR dans les langues testées, latence moyenne perçue et satisfaction utilisateur déclarée à chaud. Précisez les méthodes de collecte : grille d'observation, sondage post-interaction distinct, ou instrumentation externe selon les intégrations disponibles.
Pour les critères go/no-go, préférez des critères opérationnels lisibles : si les principales requêtes métier ne sont pas résolues de façon fiable dans les langues prioritaires, si l'ASR échoue de façon systématique en contexte réel, ou si l'interface tactile empêche l'accès aux fonctions essentielles, le pilote ne peut être validé pour passage à la phase suivante. Évitez de fixer des seuils numériques universels sans les contextualiser : ce sont des critères à adapter selon l'ambition du projet et la criticité métier.
Checklist technique à valider pendant le pilote
Pendant l'UAT, validez les éléments techniques qui impactent l'expérience. Contrôlez notamment la robustesse ASR dans les langues activées, la qualité et l'intelligibilité du TTS, la pertinence des réponses issues de la base documentaire RAG, les comportements de fallback lorsque la source documentaire ne suffit pas, et la latence perçue pour les appels LLM ou les intégrations temps réel.
Pour SANIA, vérifiez les points suivants dans la configuration du pilote : capacité à basculer entre voix et texte selon la configuration, maintien du contexte conversationnel pendant une session, disponibilité multilingue configurée, et adéquation de la base de connaissances fournie par l'organisation. Les intégrations précises avec des systèmes tiers doivent être testées comme des développements spécifiques.
Checklist technique synthétique : ASR (tests en conditions réelles par langue), TTS (intelligibilité, volume), RAG (pertinence et sources citées), gestion des erreurs et fallback, latence d'appel LLM, intégrations critiques testées, disponibilité 24/7 simulée.
Processus d'escalade et gestion des échecs en production
Définissez à l'avance les situations dans lesquelles l'avatar doit inviter l'utilisateur à contacter un membre du personnel. Le pilote doit documenter ces cas pour éviter des ruptures d'expérience : questions réglementaires sensibles, problèmes de sécurité, demandes nécessitant un accès à des systèmes protégés, ou incompréhension persistante après plusieurs tentatives.
Ne présumez pas d'un mécanisme automatique de transfert : prévoyez les messages types, la manière dont l'avatar informe l'utilisateur et la logique de recommandation vers un interlocuteur humain. Le playbook 'Passer à un agent humain depuis un avatar IA' peut servir de référence pour formaliser ces règles opérationnelles.
Templates exportables : scénarios, grille d'observation et rapport d'acceptation
Pour faciliter l'exécution, voici des modèles que vous pouvez reproduire dans un tableur ou un outil de collecte :
Template scénario : ID | Nom du scénario | Objectif | Langue | Mode (voix/tactile) | Précondition | Script utilisateur | Actions attendues de l'avatar | Critère réussite/échec | Remarques.
Template grille d'observation : ID test | Scénario | Participant (profil) | Langue | Début interaction | Transcription ASR | Réponse fournie | Durée | Intervention humaine | Statut | Commentaires détaillés.
Template rapport d'acceptation : Contexte pilote | Périmètre testé | Synthèse résultats qualitatifs | Synthèse résultats techniques | Points bloquants | Améliorations requises | Liste d'actions prioritaires | Recommandation opérationnelle (go / go avec réserves / no-go).
Points spécifiques SANIA à vérifier en pilote
Parmi les capacités confirmées de SANIA, vérifiez lors du pilote : la communication multilingue configurée pour les langues pertinentes, l'interaction vocale et tactile selon la configuration retenue, la capacité à maintenir le contexte au cours d'une session et l'exploitation de la base de connaissances métier fournie par votre organisation. Ces éléments sont des composants natifs ou configurables dont il faut valider la qualité en conditions réelles.
Si votre projet inclut des intégrations spécifiques (inventaire, horaires, POS), traitez-les comme des développements distincts et testez-les comme tels. De même, la gestion des voix personnalisées ou du clonage vocal n'est possible que si les droits et le paramétrage sont fournis et doivent être validés durant le pilote.
FAQ rapide
Comment mesurer la satisfaction sans instrumentation native ? Une organisation peut recueillir la satisfaction à chaud via une courte enquête distincte après l'interaction, ou via la grille d'observation remplie par un testeur. Ces méthodes doivent être décidées avant le pilote.
Faut-il traduire toute la base documentaire pour chaque langue ? Non. SANIA peut communiquer dans plus de 100 langues lorsqu'elle est configurée. La priorité doit être donnée aux informations métier clés et à leur qualité dans les langues réellement pertinentes pour votre public. La stratégie de localisation dépendra de vos objectifs et de vos ressources.