Introduction : pourquoi un TCO précis est indispensable
Décider d’un pilote ou d’un déploiement multi‑sites d’un avatar IA sur borne interactive exige un chiffre crédible, accepté par la direction et la DSI. Le coût ne se limite pas à l’achat de la borne : il couvre l’infrastructure matérielle, les licences LLM, la synthèse et reconnaissance vocale, la connectivité, l’intégration aux systèmes métier, la maintenance 24/7 et la gouvernance du contenu.
Cet article propose une méthode actionnable pour décomposer ces postes, estimer la consommation de tokens et construire des scénarios pilote / 10 / 100 sites. L’objectif : donner des repères concrets pour rédiger un budget, négocier des contrats et définir les leviers d’optimisation.
Les postes de coût à prendre en compte
Pour bâtir un TCO complet, regroupez les dépenses en CAPEX (investissements initiaux) et OPEX (frais récurrents). Chaque poste ci‑dessous doit apparaître dans votre tableur budget.
Matériel et installation (CAPEX) : écran ou borne interactive, support physique, boîtier audio, microphones et haut‑parleurs adaptés, éventuelle protection physique et installation réseau sur site. Pensez aux coûts d'acheminement et d'installation physique sur site.
Logiciels et licences (OPEX/Capex selon contrat) : licence logicielle de l'avatar, coûts d'accès aux moteurs LLM (tarification tokens ou abonnement), licences TTS (synthèse vocale) et ASR (reconnaissance vocale) si elles sont facturées séparément, licences d'OS ou d'application kiosque.
Intégrations et développement (CAPEX / OPEX initial) : adaptation de la base de connaissances, développement d'API pour connecter POS, inventaire ou CRM, configuration du RAG et tests multilingues. Incluez la validation juridique des contenus lorsque nécessaire pour des réponses métiers sensibles. Ces coûts couvrent aussi les tests UAT et ajustements UX voix/tactile avant mise en production locale ou pilote multi‑sites.
Coûts opérationnels récurrents à budgéter
Exploiter un avatar IA implique des coûts récurrents souvent sous-estimés. Identifiez et budgétez clairement :
Coûts LLM : facturation au token ou par abonnement. Le coût dépendra du volume de requêtes, de la taille moyenne des prompts et des réponses, et de la politique tarifaire du fournisseur. Selon la configuration, plusieurs moteurs LLM peuvent être orchestrés pour équilibrer qualité et coûts.
Coûts voix : TTS et ASR peuvent être facturés au minuteur, au nombre de requêtes ou via abonnement. La reconnaissance vocale en environnement bruyant peut augmenter le volume de requêtes (retransmissions, retries), il faut en tenir compte.
Connectivité et data : bande passante pour appels API, coût des connexions redondantes pour garantir disponibilité, éventuels coûts de stockage et de transfert pour les embeddings si la solution stocke des vecteurs dans le cloud ou on‑premise selon configuration choisie pour le RAG.
Méthode pas à pas pour estimer la consommation LLM (formule opérationnelle)
Plutôt que d'inventer des chiffres, définissez des variables mesurables et appliquez une formule simple. Voici les étapes et la formule à intégrer dans votre tableur :
1. Mesurer ou estimer le trafic : nombre moyen d'interactions par borne et par jour, différenciant interactions tactiles et interactions vocales. 2. Estimer la taille moyenne d'une interaction en tokens : prompt utilisateur + contexte envoyé au LLM + réponse générée. 3. Multiplier tokens par interaction par le nombre d'interactions sur la période souhaitée (mois/année). 4. Appliquer le tarif fournisseur exprimé en coût par 1 000 tokens (ou autre unité).
Formule synthétique à implémenter : Coût LLM périodique = (interactions/jour x jours) x (tokens moyen par interaction / 1000) x (prix par 1000 tokens).
Même logique pour TTS/ASR : estimer le temps moyen d'audio généré ou traité par interaction, puis multiplier par le tarif fournisseur (par minute ou par requête).
Construire des scénarios : pilote, 10 sites, 100 sites (modèle de calcul à adapter)
Plutôt que d'annoncer montants, structurez trois scénarios dans votre tableur en utilisant les mêmes variables précédentes. Pour chaque scénario, renseignez : nombre d'unités (bornes), trafic estimé par borne, exigences multilingues (nombre de langues activées), mode voix activé ou non, architecture (edge, cloud, hybride) et niveau de SLA attendu.
Les coûts CAPEX se multiplient par le nombre d'unités pour le matériel et l'installation, tandis que certains coûts OPEX peuvent bénéficier d'économies d'échelle (par exemple licence centrale, hébergement mutualisé, monitoring centralisé). Renseignez dans les colonnes : unité, quantité, prix unitaire (fournisseur), périodicité, total périodique et total annualisé.
Incluez une colonne dédiée aux « coûts d'intégration uniques » par site et une autre pour les « coûts de run centralisés » (support, mise à jour de contenus, hébergement embeddings). Enfin, prévoyez une cellule pour les imprévus et un scénario de sensibilité basé sur variations de trafic ou hausse des tarifs tokens.
Leviers d'optimisation économique concrètes
Plusieurs décisions techniques et opérationnelles influencent fortement le TCO. Voici les leviers que vous pouvez tester ou négocier :
Edge vs cloud : traiter certaines requêtes localement réduit les coûts d'appels LLM et la latence, mais augmente le CAPEX et la maintenance locale. Une approche hybride permet d'externaliser les requêtes complexes tout en traitant les FAQ courantes en local.
Cache et pré‑génération : mettre en cache les réponses fréquentes ou pré‑générer des contenus statiques diminue le volume de tokens appelés au LLM.
Orchestration multi‑LLM : router les requêtes peu coûteuses vers des modèles économiques plus favorables et réserver les modèles premium pour les cas nécessitant une réponse élaborée.
TTS localisé : utiliser des voix locales (edge TTS) pour les interactions fréquentes peut réduire la facture TTS, à condition d’assumer le coût matériel et la maintenance.
Optimisation des prompts et du RAG : structurer la base de connaissances pour limiter la quantité de contexte envoyé au LLM. L'usage d'une recherche sémantique bien maîtrisée peut réduire tokens inutiles, mais implique un coût de stockage et d'actualisation des embeddings selon la configuration choisie (on‑prem ou cloud).
Clauses contractuelles et SLA à négocier
Les contrats avec fournisseurs LLM, TTS/ASR, éditeur de l'avatar ou intégrateur doivent couvrir des points précis pour sécuriser votre budget et le niveau de service :
Tarification et granularité des unités : préciser l’unité facturée (tokens, requêtes, minutes), paliers tarifaires et mécanismes d’overage.
SLA de disponibilité et pénalités : définir l’engagement de disponibilité pour l’API et les éventuelles pénalités associées aux indisponibilités affectant le service en borne.
Engagements de performance : latence moyenne attendue pour les réponses et pour la TTS, et temps maximal acceptable en cas de dégradation.
Support et horaires : niveau de support (heures ouvrées vs 24/7), délais de réponse, process d’escalade et contact dédié.
Sécurité et traitement des données : obligations sur la conservation, la suppression, la localisation des données, et conditions d’utilisation des contenus métier fournis (RAG, embeddings).
Clauses de sortie et portabilité : conditions de résiliation, accès aux données exportables et modalités pour reprendre la base de connaissances en cas de changement de fournisseur.
Checklist procurement et template de calcul à préparer avant appel d'offres
Avant de lancer un appel d'offres ou une négociation, préparez un dossier structuré contenant vos variables métier et exigence techniques :
Description des usages prioritaires et volume attendu par borne (interactions voix / tactile), par période.
Liste des intégrations nécessaires (POS, inventaire, CRM) et exigences d'authentification.
Exigences multilingues et qualité attendue des voix (TTS) pour chaque langue.
Niveau de disponibilité souhaité et rythme de mises à jour de la base de connaissances.
Méthodologie d'estimation des coûts que vous attendez du fournisseur (exposer votre tableur de variables pour obtenir comparatifs homogènes).
Points contractuels non négociables : SLA minimum, sécurité des données et reprise en cas de sortie.
Questions fréquentes (FAQ) utiles pour le comité de pilotage
Q : Comment justifier l'écart entre CAPEX important et OPEX réduit sur le long terme ? R : Présentez plusieurs horizon de comparaison (coût total annualisé) et mettez en avant les coûts récurrents principaux (LLM, TTS, support). Le comité doit comprendre le point d'équilibre et les leviers pour le faire évoluer.
Q : Faut‑il privilégier l'edge pour réduire la facture LLM ? R : L'edge réduit certains appels à des modèles payants mais demande un investissement matériel et une maintenance locale plus importante. Une stratégie hybride est souvent la plus pragmatique : traiter localement les interactions à faible valeur ajoutée et déléguer au cloud les cas complexes.
Pour aller plus loin et prochaine étape
Pour transformer ce guide en chiffres concrets, téléchargez ou créez un tableur reprenant les variables évoquées et invitez vos fournisseurs à remplir leurs tarifs unitaires selon vos usages estimés. Testez au minimum un pilote sur un site pour mesurer les tokens moyens par interaction et ajuster les scénarios 10/100 sites.
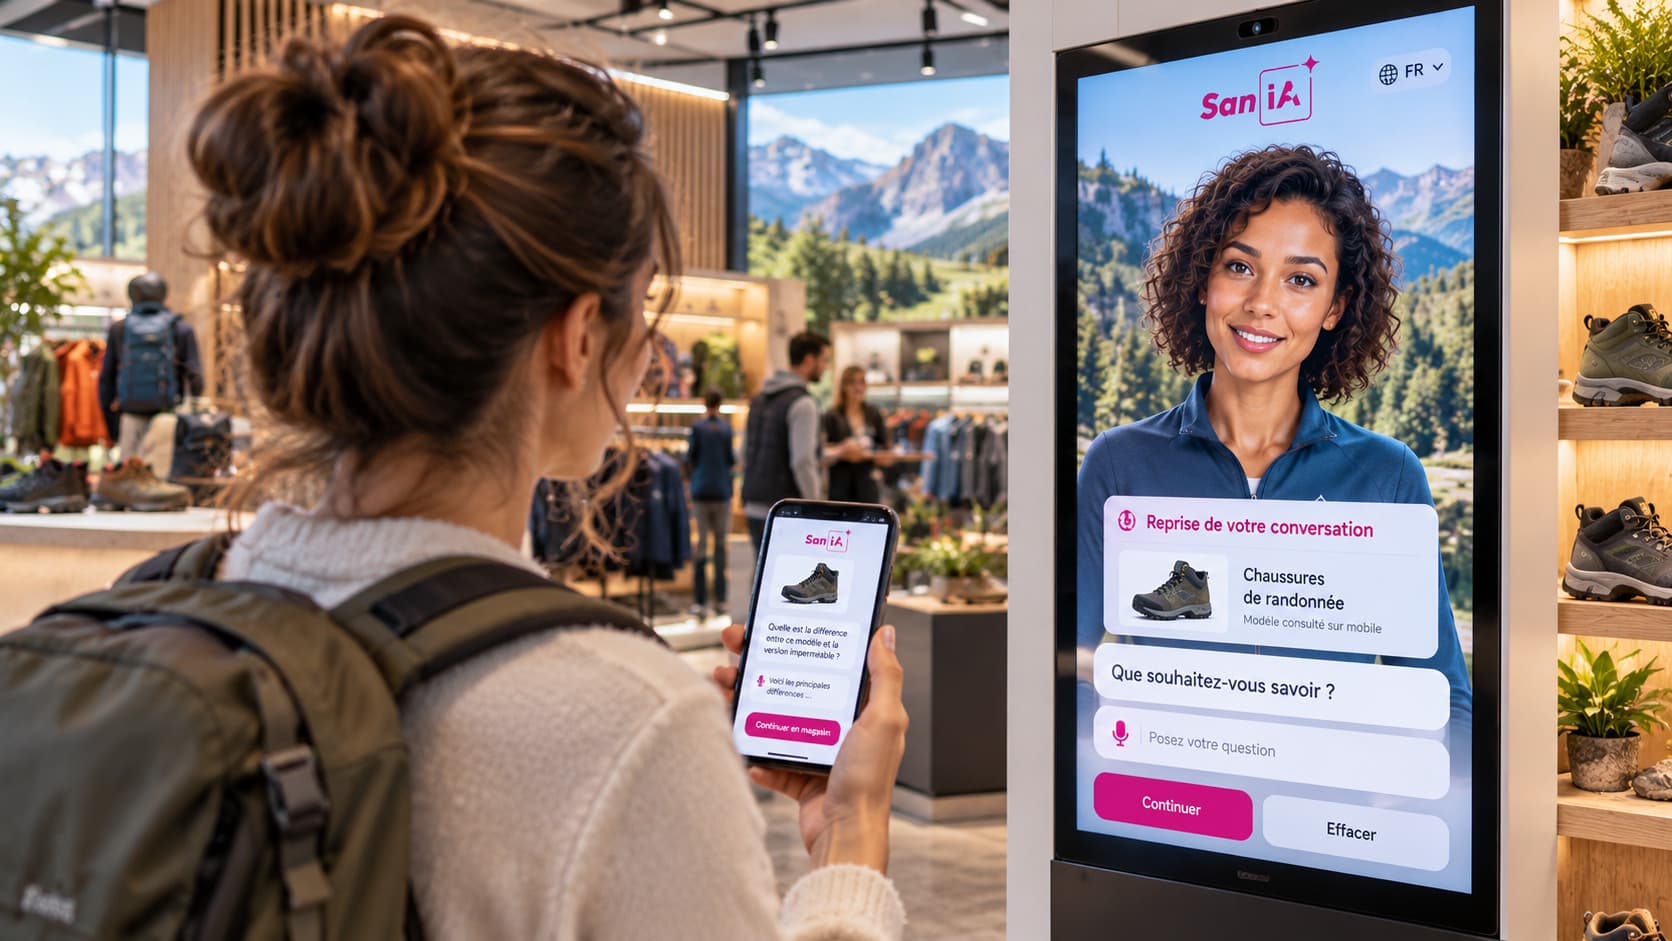
SANIA peut être déployée sur écran ou borne interactive, fonctionner en voix et/ou tactile et s’appuyer sur une base de connaissances propre à l’organisation. Pour étudier précisément comment ces choix impactent votre TCO dans votre contexte (architecture edge vs cloud, orchestration multi‑LLM, TTS/ASR), vous pouvez demander une démonstration et un chiffrage adapté à votre réseau de sites.